一张16GB显卡,一个1.7B模型,一条“回答不许出现e”的硬规则。四个步骤走完:造180条数据、LoRA SFT到35%、GRPO到60.5%、裁判评测。模型学会了答题,也学会了用一词答案骗奖励。
一张16GB显卡,一个1.7B模型,一条变态规则:回答里不许出现字母e。规则简单到一行代码就能判对错,但Qwen3-1.7B只给指令时,200条答案0%合格。不是它不听话,是它根本看不见字母——它看见的是token。
你可以把它当成一次微调实验:不追求SOTA,只看四个步骤——数据、SFT、GRPO、评测——每一步到底改变了什么。下面按一条最小复现路径走一遍。
-
造数据:180条“能不用e回答”的问答对,11.7万监督token;
-
SFT:LoRA挂7个线性层,配合梯度检查点把显存账从37.7GB压到7–8GB;
-
GRPO:每条prompt采8个答案,用裁判分数做组内比较,35%推到60.5%;
-
评测:50条prompt×4个seed,配对bootstrap,避免把噪声当提升。
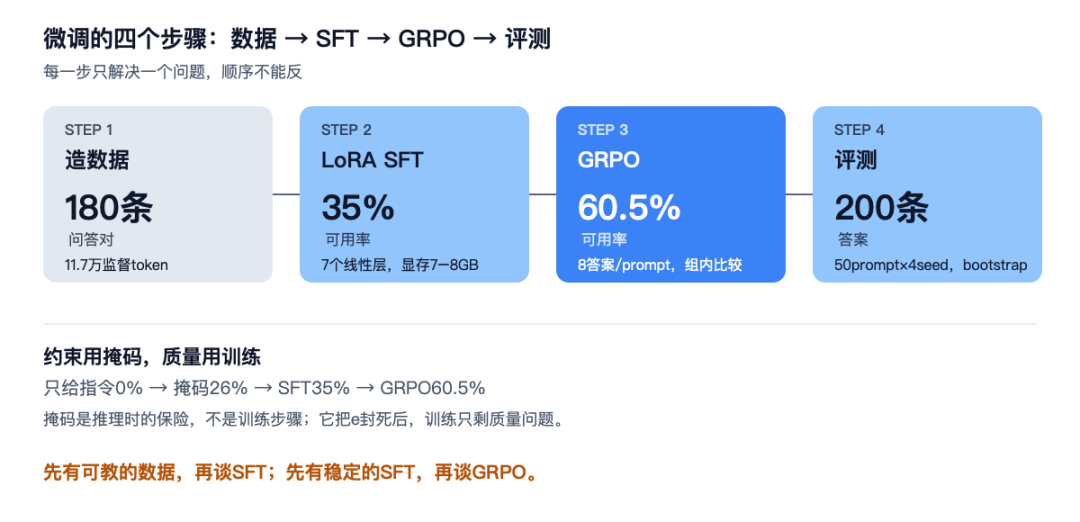
图1
图1|微调的四个步骤。数据决定能教什么,SFT决定起点,GRPO决定上限,评测决定你看到的是不是真的。
微调不是许愿:三种省事做法为什么失败
很多人把微调和提示词混在一起。提示词改的是输入,模型权重一动不动;微调改的是权重,模型的行为会留下“习惯”。你想让模型学新知识、学新格式、还是学一种偏好,用的数据和损失都不一样。
这次要学的是“在硬约束下说话”:回答不能含e,同时要连贯、要答到问题。它适合当微调教材,因为对错可以一行代码判定,你能清楚看到每一步带来了什么、又漏了什么。
先看三条走不通的路。
第一条,写system prompt。结果是0%:1.7B的200条答案全部含e,换成4B也一样。模型知道规则,但它看到的是token,不是字母;每个token的选择是局部的,它没法在解码时保证整段文本满足一个字符级条件。
第二条,只做RL。奖励很直接:不含e的token加0.5,含e的减1,再用折扣把后面的惩罚回传给前面的选择。两小时就训出一个“合规”的适配器,但它找到了更省力的解法:
i m k t r n l d g h j z p q w x y f v b c …每个token都不含e,奖励接近满分,但这不是语言。加KL惩罚、改折扣因子、加大e的惩罚,输出仍然在“字母流”和“复读机”之间摇摆。原因不复杂:奖励只度量字符,不度量词,更不度量句子。
第三条,拿小说做SFT。用Gadsby训练——1939年那本5万词、全书没有e的小说,约6.9万token。验证损失从4.09降到3.24,学得很好;评测可用率24.5%,还不如不做SFT的掩码基线。它学到的是无e散文的语感,不是“看到问题→给出回答”的映射。
三条路失败在同一个地方:把“约束”和“质量”当成了一个指标。约束可以零成本判定,质量不能;约束能在解码时解决,质量只能靠训练。分开之后,四个步骤才有意义。
为什么约束能在解码时解决?因为模型看到的是token,不是字母。Qwen3的tokenizer会把green切成gr+een;een含e,封掉它,green整词就不可达。掩码只做一件事:每生成一个token之前,把所有“解码文本含e/E或非ASCII”的token分数置为负无穷。零训练,合规率100%。special token要保留,否则<|im_end|>被封,生成无法结束;非ASCII一起封,是为了挡住é、è这类变体。
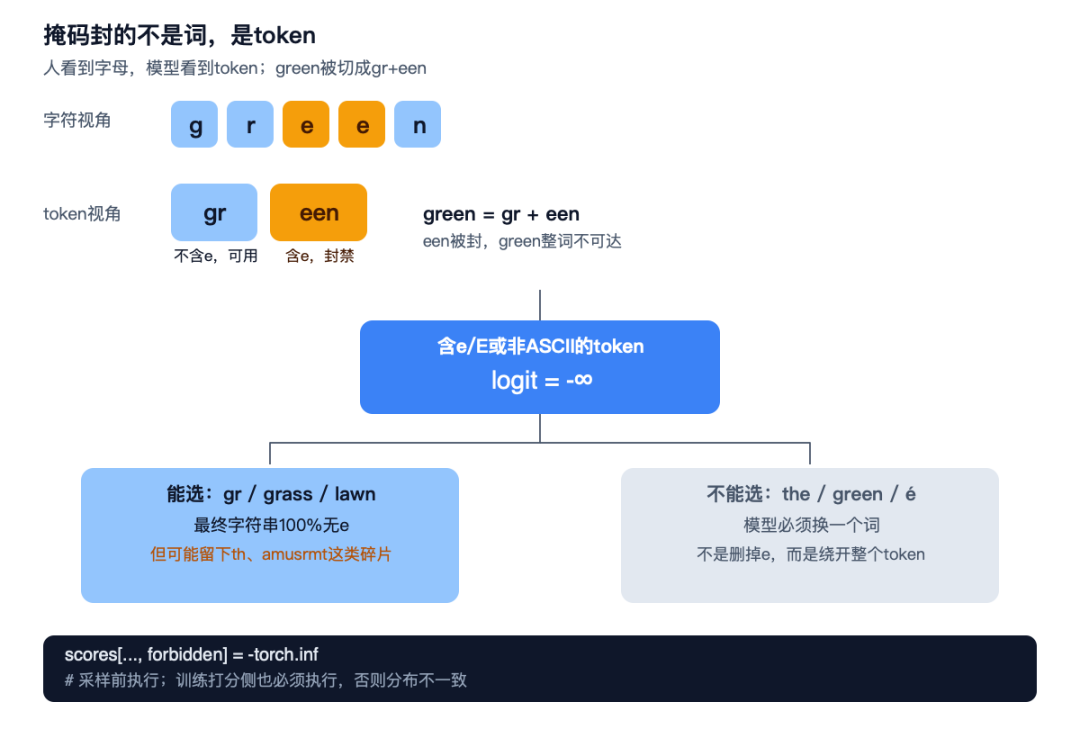
图2
图2|同一个green,人和模型看到的东西不同。een被封,green整词不可达;模型只能换词,或者退化成gr这样的碎片。100%合规不等于100%可用。
但掩码只封住约束,不教质量。掩码模型的26%可用率就是这么来的:每个答案都不含e,但很多答案是重复、碎片或半句话。比如问“woodchuck能扔多少木头”,它会写This is a classic riddiculous...,然后重复十遍;每个词都不含e,但没有回答问题。剩下的差距,只能靠数据、SFT和GRPO去补。
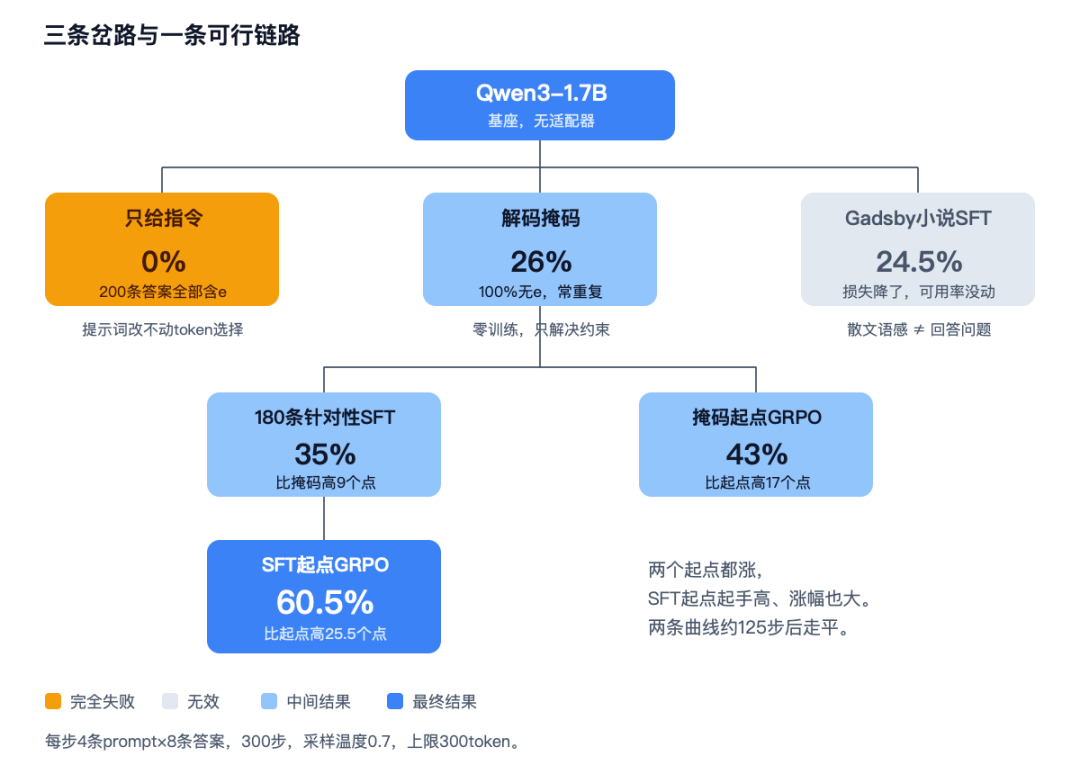
图3
图3|三条岔路与一条可行链路。只给指令0%,只做掩码26%,拿小说做SFT只有24.5%;180条针对性SFT到35%,从SFT起点跑GRPO到60.5%。灰色与橙色是失败路线。
四个步骤,一条流水线
第一步,造数据。不是越多越好,而是每条都能教。180条“针对prompt写的无e答案”,11.7万监督token;90条那档只有5.8万token,可用率31.5%,已经赢过小说。数据的关键是任务形态:它得是问答对,不是散文。
第二步,SFT。LoRA挂在每层的7个线性层上,只训练A、B两个低秩矩阵;prompt段不计算损失,只对回答段算。目标不是让模型背下180条答案,而是让它形成“看到问题→写无e回答”的映射。结果35%,比掩码基线高9个点。
第三步,GRPO。SFT给了一个起点,但它的上限受180条示范限制。GRPO让模型对每条prompt采8个答案,裁判打分,组内比较,好答案的概率上调、差答案下调。结果60.5%,比SFT起点高25.5个点。
第四步,评测。没有评测,你分不清“模型变好了”和“这次采样碰巧对了”。50条prompt×4个seed=200条答案,裁判给连贯性和答到问题各打1–5分,配对bootstrap给出区间。
| 步骤 | 输入 | 动作 | 验收 |
|---|---|---|---|
| 数据 | 2,400条候选 | 筛到1,235条,取180条 | 读10条,无e且答到问题 |
| SFT | 180条问答对 | LoRA只学回答段 | 可用率35%,答案可读 |
| GRPO | SFT适配器+裁判 | 8答案/组,组内比较 | 60.5%,区间不跨0 |
| 评测 | 50条prompt×4seed | 裁判+配对bootstrap | 能和基线区分开 |
这四步不是四个孤立实验,上一步的产物就是下一步的输入。这张表的验收列,就是每一步的刹车;没有验收,不要进下一步。每一步还有对应的失败信号:数据阶段,答案里出现e或答非所问,读10条就能发现;SFT阶段,loss在降但生成全是重复和碎片,先查label masking和数据;GRPO阶段,reward在涨但usable不动,说明奖励和最终指标不同构;评测阶段,区间跨0,说明这点提升还不能信。看到信号就停,不要用下一步掩盖上一步的问题。
顺序不能反:先有可教的数据,再谈SFT;先有稳定的SFT,再谈GRPO;评测贯穿始终。SFT像先把模型放到正确的街区,GRPO再在街区里找路;跳过SFT直接RL也能到43%,但起点低、涨幅小,同样300步少17.5个点。反过来先跑最贵的RL,通常是在验证一个还没被定义清楚的指标。
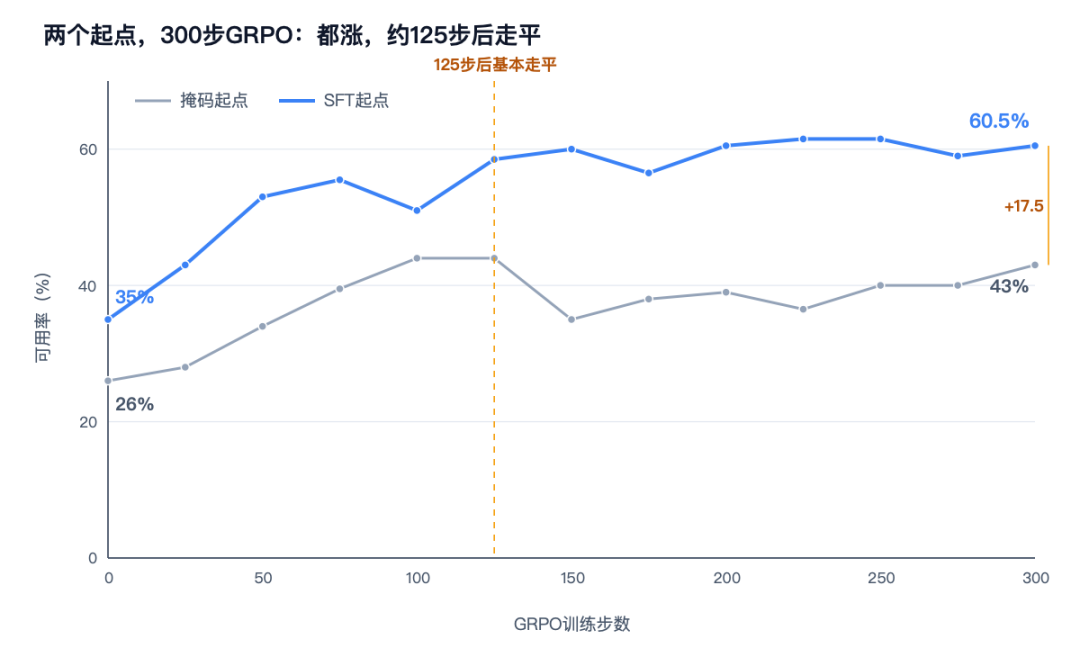
图4
图4|两个起点都涨,约125步后走平。掩码起点26%→43%,SFT起点35%→60.5%;终点相差17.5个点。数据来自两次300步run的12次中途评测。
第一步:造数据——180条就够,但每条都要能教
数据从哪来?先从训练集里挑出2,400条候选,筛到1,235条“可以不用e回答”的prompt,再从中取180条做SFT。筛选不是拍脑袋:先让模型列出“好答案无法避免的词”,再检查这些词是否含e;人工抽检40条,只有2条边界情况。
答案从哪来?让前沿模型写,再人工核对。180条答案共11.7万监督token,平均每条约650 token。这个量很小,但足够教“格式”;想教知识,180条远远不够。
写答案可以按四条要求来:一条prompt只配一条答案,避免同题多答案互相矛盾;第一句先回应问题,别绕;长度覆盖短、中、长,别全是单词答案;不用生僻词硬凑,读起来要像正常人说话。
还有一条防泄漏:评测用的50条prompt不能出现在180条SFT数据里,否则35%这个数字会被污染。训练池和评测池要分开,自己造数据时很容易忘。
数据格式是最普通的JSONL:
{"prompt": "How do I ...", "response": "First, ..."}训练时套chat template,prompt段label全填-100,回答段保留token id,末尾补eos:
# prompt段不计算损失,只对回答段算
labels = [-100] * len(prompt_ids) + response_ids
# 对齐:用第t个位置的logits预测第t+1个token
logits, labels = logits[:, :-1], labels[:, 1:]
只对回答算损失,是因为你要教“看到问题→写回答”,不是复述问题;prompt段的token对损失没有贡献,填-100就是把它从梯度里摘出去。
这里有个容易混淆的点:prompt里可以有e,只有回答不能有;SFT数据里的回答不含e,但模型学到的只是“尽量不含e”的分布,不是“绝不出现e”的保证。要100%合规,还得在解码时加掩码。掩码不是训练数据的一部分,它是解码时的硬约束。
数据造完,先读10条,检查四件事:有没有e、有没有回答问题、有没有被截断、是不是一词答案。它们比训练日志更早告诉你数据能不能用。
第二步:SFT——用LoRA把“回答问题”变成习惯
16GB卡上全参训练1.7B,权重、梯度、优化器状态加激活会直接OOM;这里的做法是只训练LoRA,基座冻结。
# 只训练A、B两个低秩矩阵,基座冻结;B初始为0,起点等于原模型
out = base(x) + (x @ A.T @ B.T) * (alpha / r)适配器挂在每层的q/k/v/o_proj和MLP的gate/up/down_proj,共7个线性层。A形状是(r, in),B是(out, r),B初始化为0,所以训练第一步的输出和原模型完全一致;缩放用alpha/r,这里两者都是16,等效缩放为1。
训练超参不复杂:LoRA rank16,学习率1e-4,batch 4,最长3072 token,最多10轮,按验证损失存档。180条数据实际跑了7轮、168次更新,几分钟到十几分钟。
target_modules只挂注意力的q/k/v/o和MLP的gate/up/down,embedding与lm_head不挂;词表矩阵有15万×2048,挂上会多吃一份梯度和优化器状态,而任务要学的是“怎么写”,不是“认哪些字”。
checkpoint按验证损失存;但验证损失低不等于可用率高,所以至少要拿存档生成10条读一遍,再决定用哪个。10轮是上限,不是目标;验证损失回升就停,小数据过拟合比欠拟合更常见。
显存账要算清楚:全参训练约37.7GB(权重4GB、梯度4GB、AdamW状态16GB、激活11.3GB、logits2.46GB);LoRA把梯度与优化器状态压到约0.5GB,梯度检查点把激活压到约1.3GB,融合交叉熵让完整logits不落地。优化后理论需求7–8GB,峰值10–13GB。
| 显存项 | 未优化 | 优化后 |
|---|---|---|
| 权重 | 4GB | 4GB |
| 梯度 | 4GB | 约0.25GB |
| AdamW状态 | 16GB | 约0.25GB |
| 激活 | 11.3GB | 约1.3GB |
| logits | 2.46GB | <0.5GB |
| 合计 | 37.7GB | 7–8GB |
SFT最容易犯的错,是只看loss。Gadsby的验证损失从4.09降到3.24,看起来学得很好,可用率只有24.5%。loss降,说明模型学会了训练集的分布;它不说明模型学会了“回答问题”。所以每存一次checkpoint,都要生成几条答案读一遍。
回到180条针对性数据,SFT的结果是35%,比掩码基线高9个点。但它也封顶得很快:90条到180条,数据翻倍,只涨3.5个点。这说明SFT学到的是“示范的边界”,剩下的要靠RL去探索。
第三步:GRPO——让裁判分数变成梯度
GRPO的核心不是“用奖励训练”,而是“同一条prompt的8个答案互相比较”。这样不需要value网络,也不需要把不同难度的prompt放在一起比。
具体四步:每条prompt采8个答案;裁判给每条答案两维分数,换成0–1的奖励;减去组均值、除以组标准差,得到优势;用PPO式裁剪更新策略,同时加KL约束。采样温度0.7,单条上限300token;这两个值和评测口径保持一致,否则训练与评测的分布会对不上。
为什么是8条?组内比较需要均值和标准差,条数太少优势噪声大,条数太多判分和显存成本翻倍;8条是两者之间的折中。学习率2e-5,约为SFT的1/5;RL的更新更敏感,学习率一大,ratio会迅速跑出裁剪区间。
# 同一prompt的8条答案互相比较:减组均值、除组标准差
adv = reward - reward.mean()
adv = adv / reward.std().clamp_min(1e-6)

# PPO式裁剪,ratio是“新策略/采样时策略”的概率比
clipped = ratio.clamp(0.8, 1.2) * adv
surrogate = torch.minimum(ratio * adv, clipped)

# KL用k3估计:exp(d)-d-1,非负,方差比单点log(d)小
loss = -(surrogate - kl_beta * kl).mean()奖励的定义是reward = (coherence - 1 + responds - 1) / 8,两项都1分得0,都5分得1。裁剪系数0.2,KL权重0.02。SFT起点的run把KL锚点指向SFT适配器,不是基座——否则模型会被拉回“会说英语但不会答题”的起点;掩码起点的run锚点就是基座。0.02是很弱的约束,只防策略跑得太远。
GRPO还要一个参考策略算KL。16GB卡放不下第二份模型,做法是临时关掉适配器:
with lora_disabled(model):
ref_logits = model(input_ids)如果锚点是SFT适配器,用swapped_adapters把SFT数值临时换进来,跑完再换回。
掩码不只在采样时加。训练打分也要用同一套掩码算logprob,否则重要性采样比从一开始就是错的;代码里在token_log_probs里再封一次。
这套配置能跑,但奖励里埋了一个洞:两项相加,5+3和4+4都得0.75。前者不可用,后者可用,模型看不出区别。
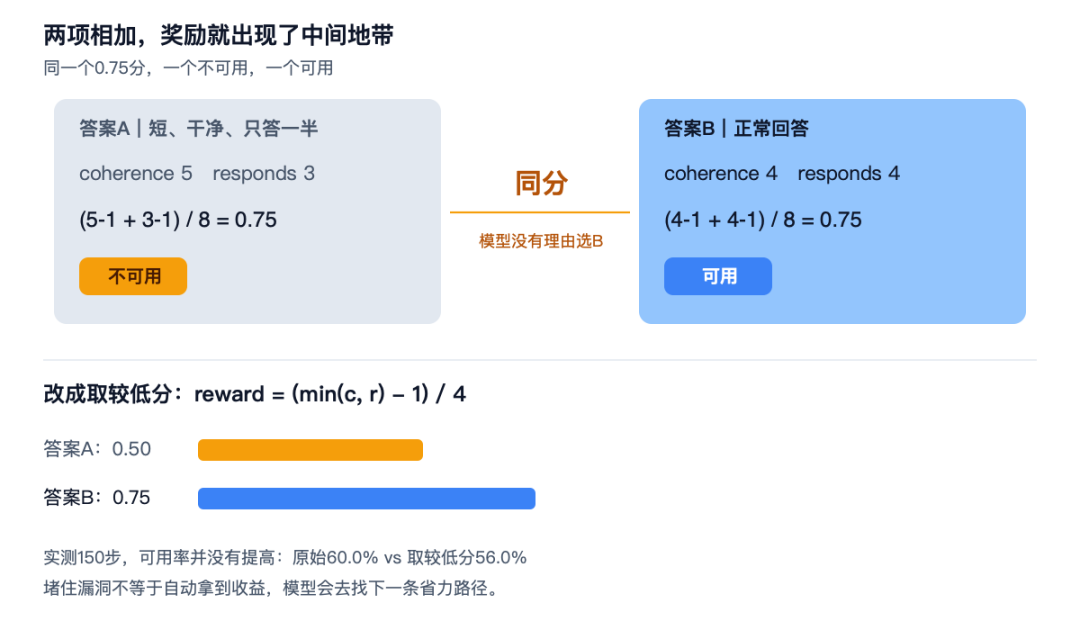
图5
图5|两项相加,奖励出现中间地带。5+3与4+4同得0.75,模型没有理由选后者。改成取较低分后,A降到0.50、B保持0.75;但150步的对照里,可用率并没有提高。
后果很具体。掩码起点:增益全部来自coherence(3.29→4.20),responds一分没涨(3.61→3.56),“干净但只答一半”的答案从24/200涨到66/200。典型输出是问龙卷风强度怎么评,答Strong;问汉堡为什么好,答It's a classic.
SFT起点:两项都涨(coherence3.73→4.39,responds3.35→3.75),“干净但只答一半”从54/200降到49/200,而且每个长度区间的可用率都上升:<25token从47%到66%,100+token从7%到25%。它的增益不只是变短。
另外两个修法各跑150步:用两项里较低的那个作奖励;把损失从“除以自身长度”改成“除以固定300”。结果都没有提高可用率(原始60.0%,取较低分56.0%,固定长度50.5%),也都没能阻止变短(中位长度33/30/38token,RL前是53)。
一个可能的解释是掩码的副作用:多写一个词,就多一次被逼用怪词的机会,短答案得分更高。这只是推测,没有做直接实验;但它说明,堵住奖励漏洞和拿到训练收益是两件事。
GRPO的结果是60.5%,比SFT起点高25.5个点;掩码起点也从26%涨到43%,涨了17个点。两条曲线在125步左右拿到主要增益,之后基本走平。继续跑175步,更多是在同一水平上漂移。
第四步:评测——别用loss判断微调成败
评测口径比模型更决定结论可信度。usable是严格口径(两维都≥4),readable是宽松口径(两维都≥3)。掩码基线readable67%,usable只有两成多。
50条prompt×4个seed=200条答案;所有区间都是配对bootstrap,同一批prompt有放回重抽1000次,同一次重抽同时用于两个run,再取差值分位。配对的意思是:同一次重抽里,两个run用同一批prompt再算差值,prompt难度差异被消掉;区间跨0,几个点的提升就不能当真。
usable和readable要一起看:前者防“合规但废话”,后者防“说得好但含e”。只看一个,都会把另一类失败藏起来。
裁判本身也被评测过三轮。第一版给“同一行重复五遍的诗”打coherence4分;第二版加硬规则“同一短语重复≥3次,coherence封顶3”;第三版明确“事实错误不扣分”,并标注被300token截断的答案。校准结果:100条已验证答案98%可用,64条人工复核答案一致率92.2%,6条失败输出×8条prompt全部判0。
评测不是收尾动作,是每一步的刹车:SFT后先看10条答案,RL每25步看一次曲线,跑完才做全量对比。只看loss,你会把“模型学会了训练集”误当成“模型学会了任务”。
在16GB卡上跑一遍
环境硬门槛:16GB显存、Python虚拟环境、torch cu128、transformers5.x;liger-kernel可选,没有它SFT会回退到普通交叉熵,只是显存和速度差一些。权重放weights/qwen3-1.7b,判分需要OPENAI_API_KEY。
如果只想知道“这套东西能不能用”,按1→2→3→4的顺序跑:先做数值对齐,再复现掩码基线,然后跑SFT180,第4步做RL可行性检查。SFT180是第4步的前置,rl_check要加载它的best.pt;完整RL的两个300步run可以后补。只有一张卡时,先跑到SFT,再决定要不要RL;SFT几十分钟就能给你一个能读的起点,RL是小时级投入。反过来先跑最贵的RL,通常是在验证一个还没被定义清楚的指标。
# 1 数值对齐:手写前向 vs HuggingFace,最大差应<1e-3
python -m scripts.check_parity

# 2 复现掩码基线
python -m scripts.evaluate \
  --data_path=data/prompts/short_eval_50.jsonl \
  --output_dir=runs/check/base_masked \
  --max_new_tokens=300 --seeds='[0,1,2,3]' \
  --judge=True --no_e=True \
  --mask_e=True --ascii_only=True

# 3 180条SFT+评测
SIZES="180" bash runs/sft_sizes_20261016/run_all.sh

# 4 RL可行性:门槛是“至少一条可用的prompt≥20%”
bash runs/rl_check_20261016.sh

# 5 RL冒烟:3步,不跑评测
python -m scripts.rl_judge --run_dir=runs/check/smoke \
  --prompts=data/prompts/rl_pool.jsonl --max_steps=3 \
  --eval_every=1000 --final_eval=False

# 6 配对比较
python -m scripts.judge_eval compare --run-dirs \
runs/check/base_masked runs/check/rl_sft180/eval/step_0300第2步只写了掩码基线;0%条件把--mask_e=True改成False、保留--no_e=True;80.5%条件再把--no_e改成False。完整命令见05-复现指南.md的4.2节。
几个命令层面的坑:--output_dir/--run_dir必须不存在,否则直接FileExistsError,这是防止覆盖已发布记录;--seeds要写成'[0,1,2,3]',写成0,1,2,3会被fire当成字符串;run_all.sh假设runs/sft_sizes_20261016/目录还在,清空过runs/要先建目录。
失败判据比“跑完没报错”重要:
-
check_parity最大差>1e-3,停。28次FP32对比的最大差是7.15e-5,低两个数量级才算对。 -
基线三个条件应是0%/26%/80.5%(80.5%是不加e规则的公平性检查)。掩码基线偏差超过2个点,先查掩码是否漏了
ascii_only、special token是否被误封。 -
rl_check的“至少一条可用的prompt”低于20%,停。脚本默认温度1.0时,两个起点实测78%和64%,门槛留了足够余量。 -
每步突然从28秒变成170秒,不是模型变慢,是WSL显存溢出退化到统一内存。保留14GiB上限,监控峰值显存与步速。
-
判分错误>0,停。两个完整run合计约2.4万次判分,判分错误为0。
两个容易踩的坑:
看起来成功、其实错了:WSL上显存超了不会报错退出,而是悄悄用统一内存,每步从28秒变170秒。训练曲线还是好看的,只是你在用6倍时间换一个本可以避免的故障。
报错信息与真实原因不符:SFT起点的RL加载时OOM,报的是显存不足,真实原因是KL锚点又加载了一份完整模型。正确做法是用swapped_adapters换适配器数值,不是去调小batch。
还有一个bf16下的坑:采样logprob与训练logprob差0.01–0.02,ratio第一步就不等于1。开recompute_old_log_probs,不是改学习率。
如果显存只有12GB,可以按比例把每步prompt降到3或组大小降到6,先保证不溢出,再谈复现;显存换时间比OOM重跑便宜。
版本也别混:transformers4.x的apply_chat_template签名不同,Qwen3Config字段也不同,会在加载模板或配置时直接报错;torch用稳定版CUDA build也可以。另一个判据是答案里出现th、amusrmt——这说明模型在删e而不是换词,继续训练只会强化这个行为;这时要么换模型,要么改奖励,掩码本身解决不了。
这套配置的峰值在10–13GB。剩下的余量可以换更大batch或更长序列,但300token上限是评测口径的一部分,不建议只放大训练长度。
成本参考:RL每步约28秒,一次完整run加12次评测约2.1小时(掩码起点)/1.7小时(SFT起点);两个run合计约2.4万次判分、1600万token。SFT180实际168次更新,几分钟到十几分钟。
复现顺序上,先跑数值对齐,再跑基线;如果基线对不上,不要往下跑,先打印10条被判可用的答案读一遍——多数错误是掩码或special token,而不是模型。训练日志里至少记四样:峰值显存、每步耗时、判分错误数、sampling_vs_training_logprob_gap。它们不影响loss,但能提前发现OOM退化与分布错位。
迁移到别的约束,只改四个地方:core/checks.py的判定、build_forbidden_token_mask的禁用字符、core/judge.py的质量维度、reward()的组合方式。如果约束不是“禁止某些字符”而是“必须包含某字段”,掩码不适用,得靠SFT或奖励;如果约束会随上下文变化,先确认它能不能在解码时判定,不能就别急着上RL。
这套方法的天花板
-
样本量小且同源。评测集只有50条prompt、每条4个seed,每个配置只跑一次,也没有多种子重训;prompt来自同一数据集,跨分布泛化没有测。几个点的差异在噪声内,图4相邻点的上下波动也不应解读成“模型退化了”。
-
答案由前沿模型生成。180条示范带着教师模型的风格,裁判也可能偏好这种风格;换一个教师或换一个裁判,SFT的起点和RL的增益都可能变。
-
裁判是闭源的。
gpt-6-luna是闭源接口;评分维度和prompt写在core/judge.py里,换一个判分模型要重新校准。两维评分是为短问答写的,换到代码、长文或中文,维度和锚点都要重写。三轮校准只能说明它在三个集合上一致,不能说明它等于人类偏好。 -
300token上限会诱导短答案。训练与评测都限制在300token,长度偏置被这个口径放大;放开到600token,长度分布和可用率大概率会变。
-
只测了一个模型族。1.7B与4B同族同tokenizer;4B在掩码下只有12.5%,低于1.7B的26%,这是“坚持写原词再删e”的具体行为,不是缩放律结论。
-
长文没有解决。转向短答案之前,2k长文阶段80条输出全部不合格,所有条件都是0/8;只有记忆化实验能做到损失1.520→0.032、5/6精确复制,但验证损失反而从1.456升到2.557。这套方法不能声称能处理长文。
-
RL只验证了300步。训练奖励在125步后走平,继续跑会不会涨、会不会崩,都没有数据;这是一个未验证区间,不是“300步最优”的结论。
-
没有checkpoint。公开材料只有配置、指标、判分和答案文本;要复现SFT/RL结果必须自己重训。
这些边界不是免责声明,是使用说明。比如“300token上限”意味着:如果你业务里的回答平均800token,本文的长度分布、奖励漏洞的表现、甚至SFT需要的数据量都可能变;不能直接把这个终点当成你场景的预期。先按最小规模跑通,再决定要不要加数据、加步数;这比一开始就冲两个300步run更划算。
还有一个没做的对照:DPO、RAFT、拒绝采样微调(RFT)都可能用更低成本拿到类似收益。这套流程只证明了“掩码+SFT+GRPO”这条链路可行,没有证明它是最优解;GRPO的价值在于不需要critic、能直接用裁判分数,代价是每个prompt要采8条,训练成本是SFT的几十倍。
微调不是让模型变聪明,而是让它养成一个新习惯。习惯的好坏,不取决于你用了多少显存,而取决于你给的数据、损失和奖励是否在教同一件事。无e任务只是一个显微镜:它把这句话放大给你看。
参考
-
项目仓库:kevinyvv/qwen-3-1.7b-finetune-proj
-
项目博客:kevin-wu.ca/blog/qwn
-
实验笔记:
repo/docs/experiment_history.md -
基线数据:
repo/runs/rl_20261016/*/eval/step_0300/short_eval_report.json -
SFT数据:
repo/runs/sft_sizes_20261016/eval_180_masked/short_eval_report.json -
适配器:k33wu/qwen3-1.7b-no-e
如果你也在做带硬约束的生成任务——禁词、格式、字数、必须包含字段——把约束写在评论区,我挑一个用这套“掩码+SFT+GRPO”跑一遍,数据公开。
我是 Aaron,10 年算法工程经验,每周拆一个 AI 新东西的实现细节。 关注「AI 拆解猿」,每周拆一个 AI 协议、框架、源码或架构,直到你能自己动手。
