一次训练2小时,排队8到20小时,而编码Agent的会话只有10分钟。想让AI自己改代码,会先撞上一件跟模型没关系的事:它等不起。这套装置在内部叫AutoResearch,办法很土:提交完拿submitId就走,下一轮回来收。1366行执行器加221行坑清单,换来主指标+0.056pp、相对+2.02%,端到端耗时持平。
先说结论
这套装置不想新点子。它干的事只有一件:把一个已经写下来的研究方向,拆成能验证的小假设,一轮一轮试到尽头。
四件可以直接拿走的东西:
-
一个不用等的循环:提交完就返回,下一轮开头再收(图1)
-
三道护栏:不重复提交、不静默失败、不无限重启
-
一份12条”静默失败”清单的写法,以及它为什么比代码更值钱
-
边界:它只会沿着一个方向往下试
规模摆在这里:执行器主文件1366行,收割模块172行,后端6张表。最值钱的不是代码,是那份记录平台毛病的手册。
一次真实产出:排序主干从MaskNet换成RankMixer,主指标2.786%→2.843%,相对+2.02%,端到端耗时持平。
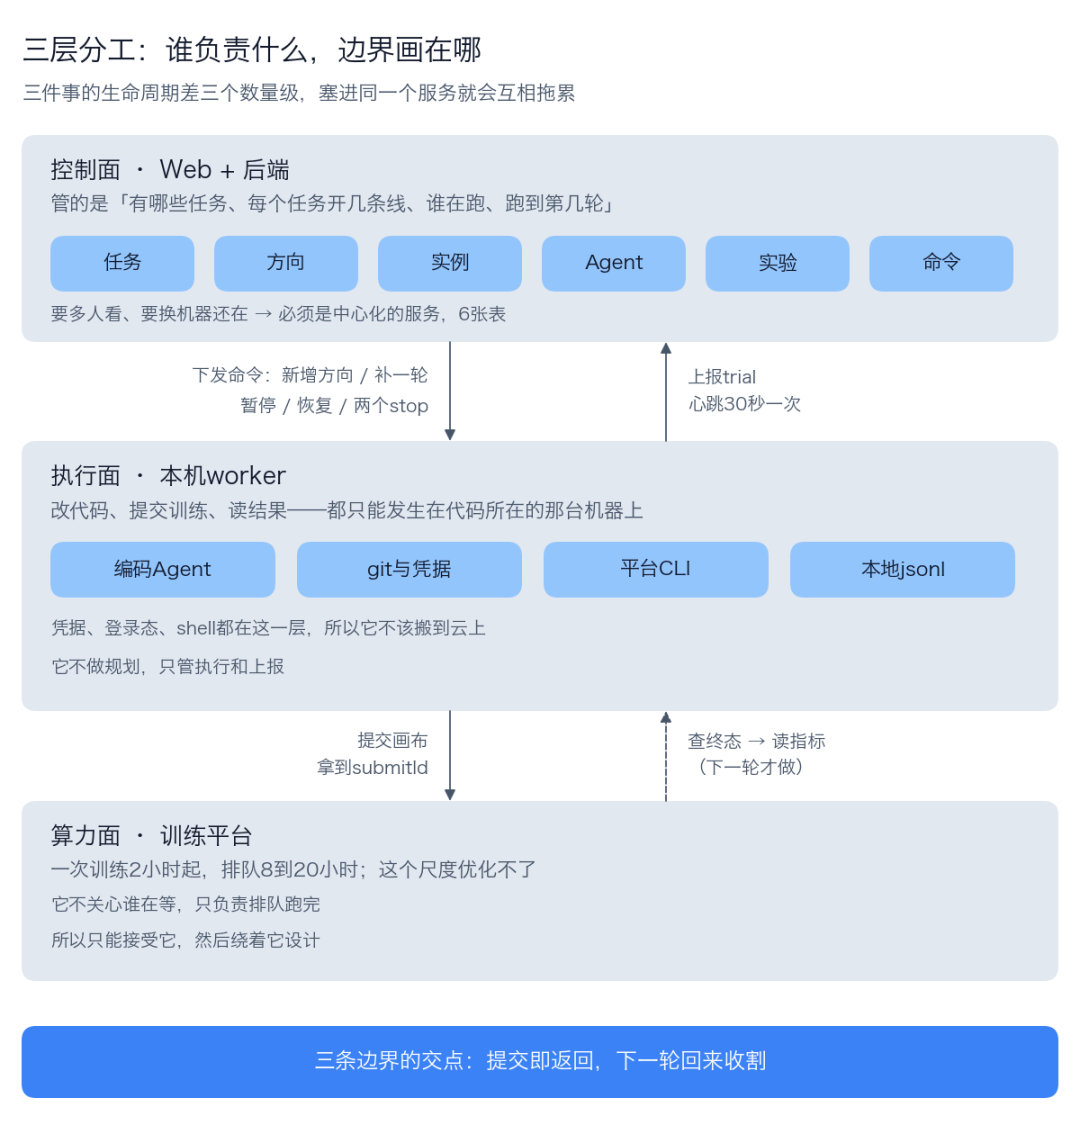
三层分工
图1|三个面各管一段,边界先划清。控制面只记账不碰代码,执行面只干活不做规划,算力面只排队不管谁在等。后面那些看着奇怪的设计,命令轮询也好、提交即返回也好、结果靠收割也好,都是这三条边界推出来的。
一、第一版写成同步的,卡在等训练上
排序模型怎么调,说到底是一堆想法互相打架:“warmup从2000加到4000会不会更好”、“batch从512改到1024收益多大”、“把FFN换成gated结构值不值”。每个想法一句话就能说完,可验证起来都得走一遍:改代码、提训练、等两小时、看一个指标。
麻烦的不是技术。一轮两小时起步,一天跑三轮就算勤快,剩下那二十一个小时机器闲着,人也不会守着。等他想起来回来看结果,脑子里那点上下文早凉了。
也不是所有研发都适合这么干。判断标准很朴素:这一轮做完,能不能马上知道好不好?
-
架构评审不能,结论得靠人吵出来;
-
故障排查不能,根因往往要靠直觉收敛;
-
调一个超参、换一个模块、试一种归一化,能,指标就在那里,跑完即知。
第二类活有个共同点:判断起来便宜,看一个数就够;执行起来贵,两小时训练,前面还排着一段不知道多长的队。这种活天生适合交给机器,因为机器不怕等,人受不了等。
一开始就划了一条线:这东西不想新点子,只管把已经写下来的方向拆成一串小假设。所以它不需要会做规划的大模型,只要一个能改代码、能调平台、能记住上一轮干了啥的Agent,现成的编码Agent就够。
第一版写成了同步:改代码、提交、等训练跑完、读指标、决定下一步。
时间线是这样:改代码几分钟,提交几十秒,然后等2小时。
问题就出在中间那两小时。编码Agent一次会话撑不到那时候,超时设的600秒,也就是十分钟。训练还没真正开始,会话先超时了。
超时之后会怎样?这一轮要是什么都没记下来,下一轮的Agent根本不知道自己提过什么,于是再提一遍同样的实验。队列里堆一堆重复的画布,记录里一片空白。
跟模型聪明不聪明没关系,是时间对不上:两小时的活,塞进十分钟的会话里。差12倍。
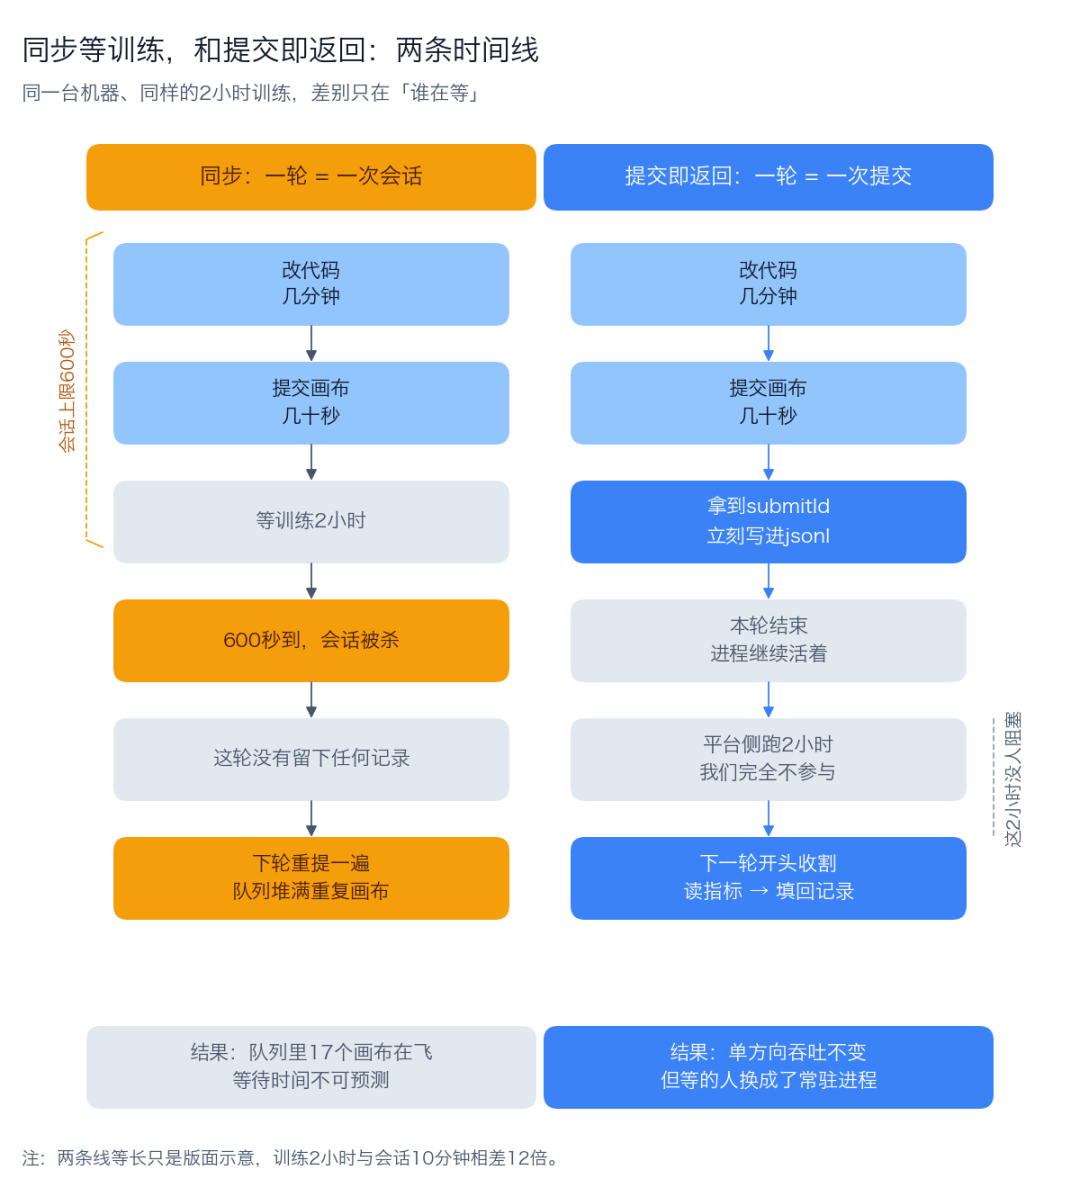
两条时间线
图2|左边是顺手写出来的版本,右边是能跑下去的版本。会话上限600秒,训练要2小时,同步方案里第3步一定超时。右边只是不在这一轮里等,两小时就落到了一个不会超时的常驻进程身上:等这件事没消失,只是换了个地方等。
二、提交即返回,下一轮再收
做法很土:第N轮只做四件事,改代码、复制画布、改参数、提交。画布是平台上的一份实验配置,复制一份就是开一个新实验。提交完立刻拿到一个submitId,写进记录,状态标submitted,这一轮就结束了。
训练在平台上自己跑。到第N+1轮,第一件事不是想下一步,而是回头看看上一轮提的东西跑完没有:查状态、读指标、填回记录、上报。这一步叫收割。
主循环就这么缩成六步,顺序不能随便换:
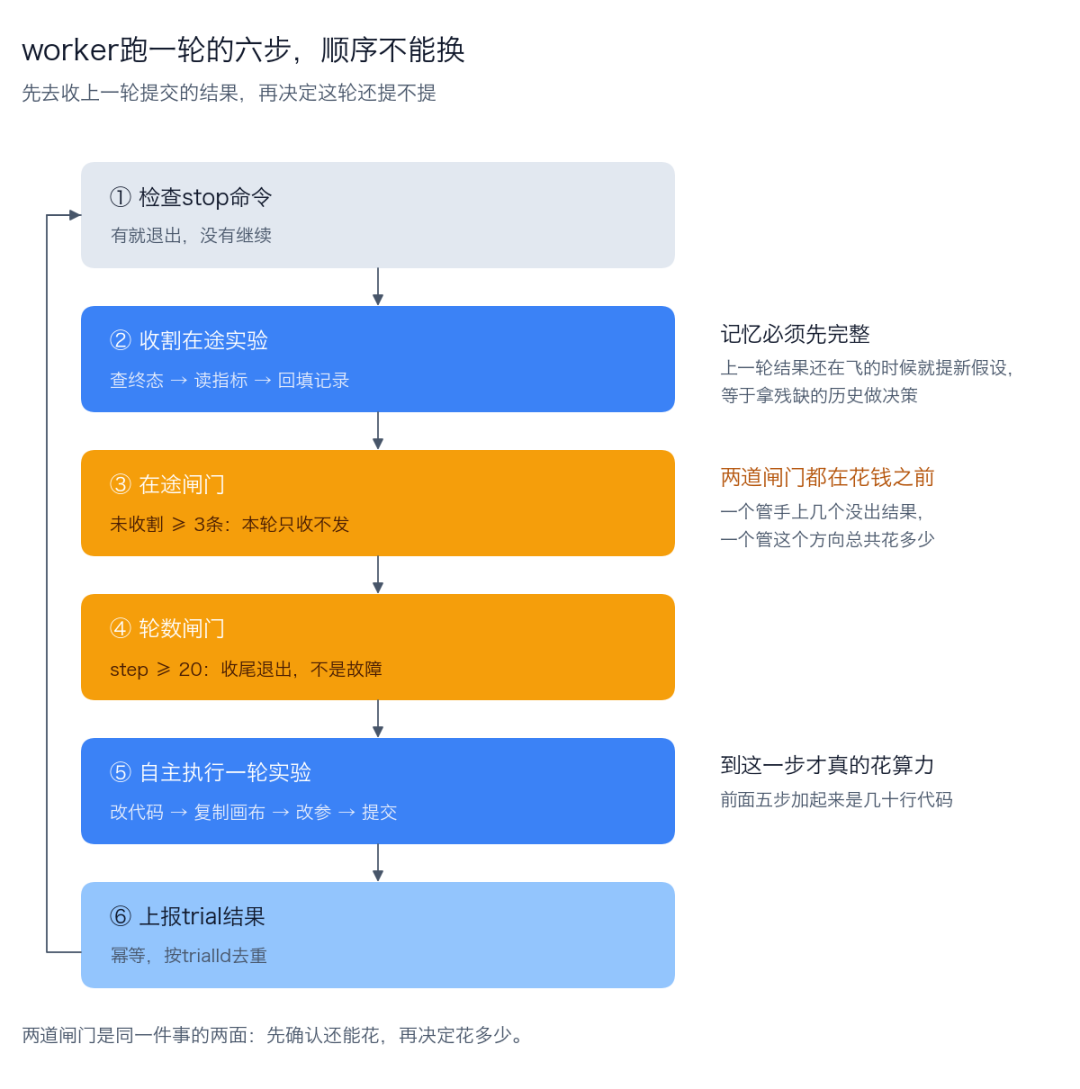
一轮六步
图3|先去收上一轮的结果,再决定这轮还提不提。把②放在⑤前面不是为了好看:上一轮还在飞的时候就想新假设,等于拿半截历史做判断。
为什么非得先收?反过来试一次就知道了:先想新假设、先提交、回头再收。Agent提假设的时候,上一轮的结果还在飞,它不知道那条路走通没有,只能拿更早的信息来推,很可能又提一个已经被证伪的东西。而且没收的实验会越堆越多,每轮先加一个新的,旧的还没收,堆起来一次比一次多。
顺序之外,还得说清楚任务、方向、实验这三层怎么记,因为它决定了能同时试几种想法。
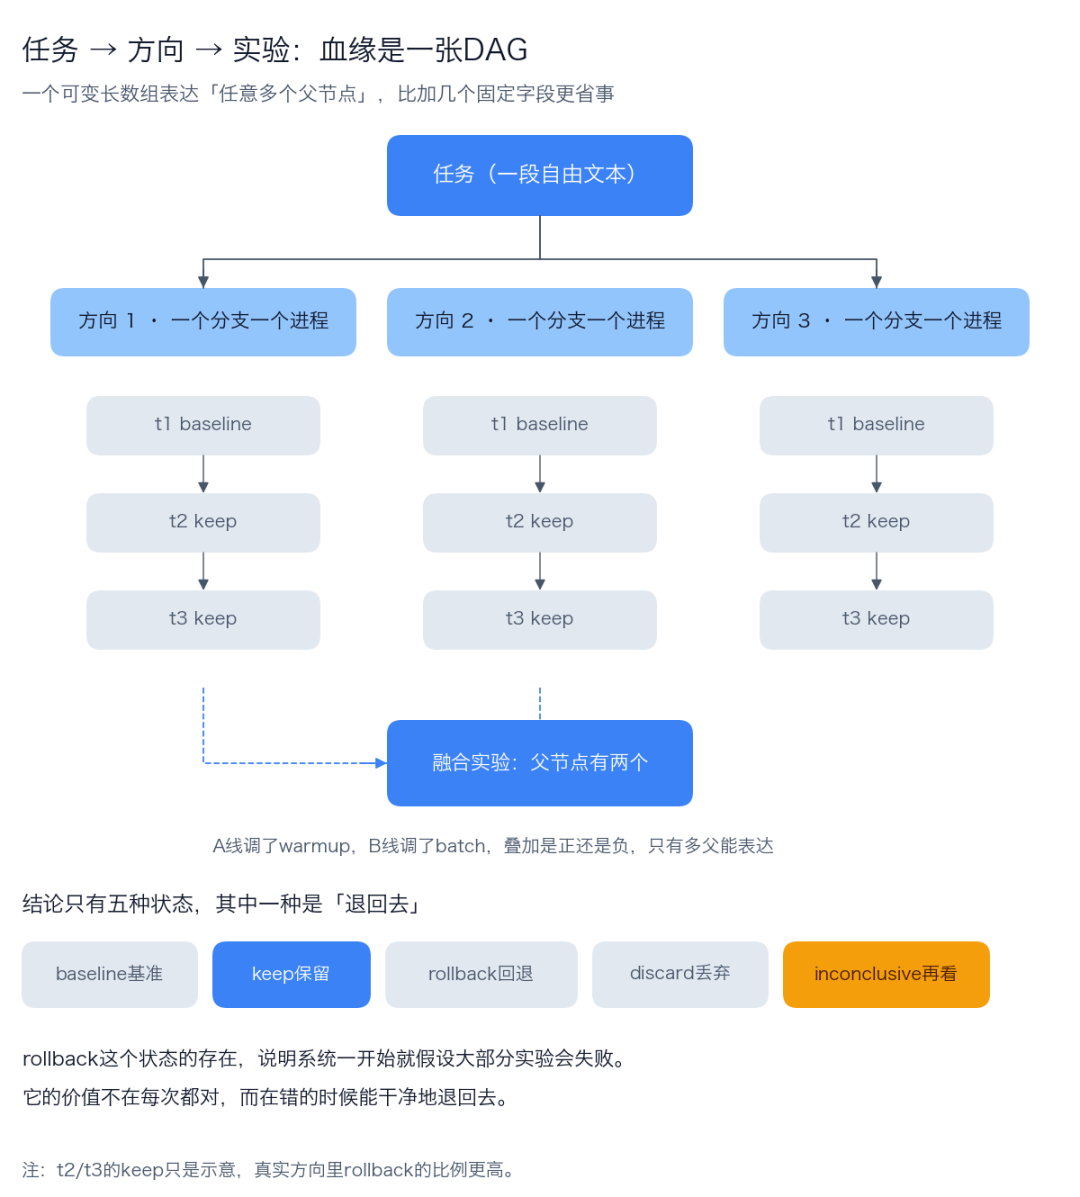
实体与血缘
图4|任务→方向→实验,实验之间的父子关系是一张DAG。方向的ID是定死的,不含时间戳,进程重新拉起后注册的还是同一个Agent;实验的父子关系用一个可变长数组表达,多父就是融合。
关键字段只有一个:parentTrialIds,一个JSON数组。空数组是baseline,一个父是常规推进,多个父是融合。
多父这个设计是逼出来的。A线在调warmup,B线在调batch,两边各自都涨了点,可没人知道叠在一起是正还是负。要是父子关系只能记一个父节点,融合实验就存不进去,它既不是A的子节点,也不是B的子节点。那加两个字段,parentA、parentB?三父融合又没地方放。
一个数组就完了。长度不固定,能装任意多个前驱,比加一堆固定字段省事,也不用每来一种融合就改一次表结构。
每条实验最后落在五种状态之一:baseline、keep、rollback、discard、inconclusive。有rollback这一档,说明设计的时候就认了大多数实验会失败。这是这类工作的常态,谈不上悲观;真正要紧的是错的时候能干净地退回上一个状态。
三、几个容易写错的地方
上面是主干。能让它连跑三天不出事的,是下面这几个地方。
收割的三条规矩
收割本身只有172行,要处理的情况一点不少。状态机很简单,submitted推成completed或failed,外加一条超时路径。
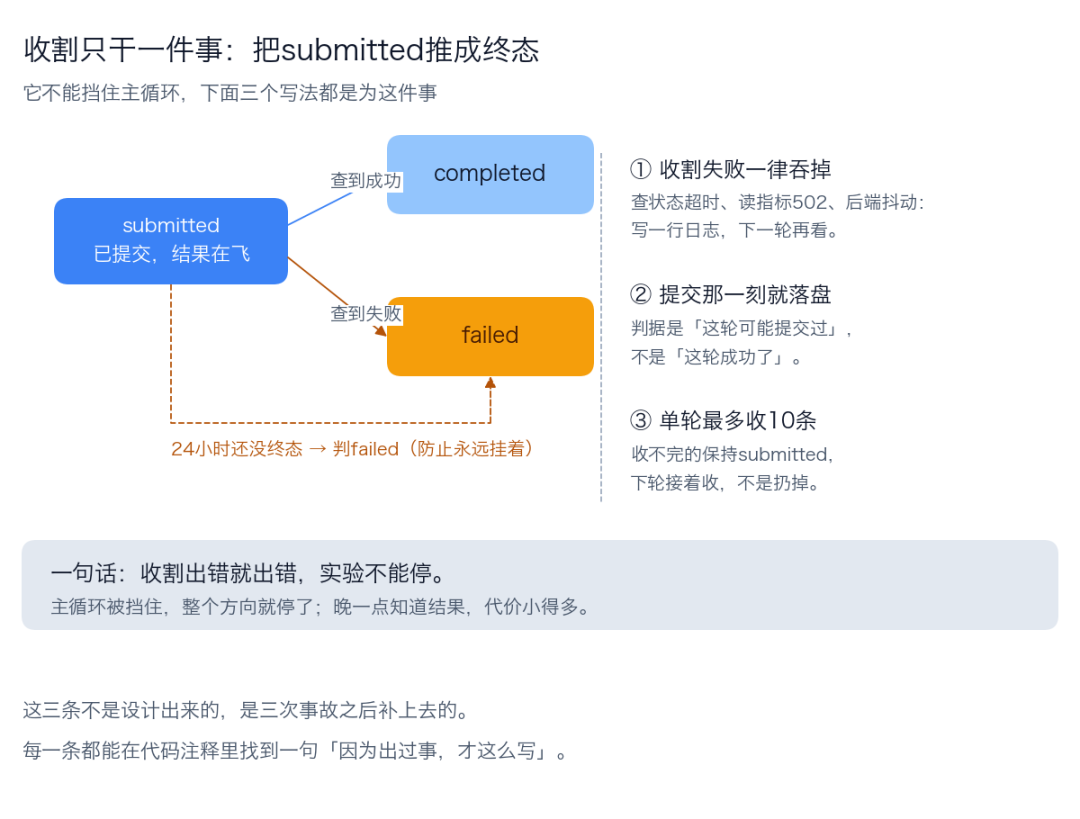
收割状态机
图5|收割只干一件事:把submitted推成终态。三条规矩说的是同一件事:收割是附带功能,不能挡住主循环。
第一条最容易写错:收割出错就出错,实验不能停。查状态失败、读指标超时、后端502,一律吞掉,写一行日志,下一轮再说。收割失败无非晚一点知道结果,主循环一挡,整个方向就停了。
第二条是踩过一次才补的:记录得在提交成功那一刻就落盘,不能等结果回来再写。
// 条件不是"这轮成功了",而是"这轮可能提交过"
// 只要提交动作发生过,就必须留下痕迹
if (opts.taskId && currentSubmitId) {
  appendTrialToJsonl(..., {
    submitId: currentSubmitId,
    status: "submitted",
  });
}
哪怕后来进程被kill、机器重启,下一轮读jsonl依然知道有一个submitId在飞,可以去收。
第三条是限流:一轮最多收10条。堆了30个没收的实验,一次全查会把这一轮拖到几分钟以上。所以这轮收10个,剩下的还是submitted,下轮接着收,别扔。
两道闸门
/** 在途上限:未收割的实验数,超过就只收不发 */
const MAX_IN_FLIGHT =
  Number(process.env.AUTORESEARCH_MAX_IN_FLIGHT) || 3;
第一道管”手上同时有几个还没出结果的实验”。3是个折中,够并行,也不至于把队列打爆。这个数是踩出来的:有一次17个画布同时挂在平台上,每个都在排队,等多久完全说不准,看着在并行探索,其实是互相拖。
第二道管”这个方向一共花多少”:maxSteps默认20,跑满就正常收尾退出,不是出错。
把两轮的数字写在一起,就是成本的上界:
同步:循环 = 改 + 提 + 训练 = 7200s > 会话 600s → 必被杀
异步:循环 = 改 + 提 + 收割 = 300~600s < 600s → 能活
上界:轮数 ≤ 20 → 单方向最贵 20×2h = 40h 训练
两道闸门都在花之前检查,所以不会超。
记忆只有三个字段
做决定的活交给Agent了,它干得好不好靠什么保证?靠每一轮喂进去的那段文字。
每一轮,worker拼一段提示词交给编码Agent:研究目标、仓库分支和commit、参考画布、当前第几轮,最后是历史实验记录。末尾压着四条硬要求:
1. 修改代码(如果有改进思路)
2. 用工具操作画布:复制、改参数、提交
3. 提交画布后立即结束本轮,不要等待训练完成
4. 完成后只输出 JSON
第三条最关键:它把”别等”写成了给Agent的指令。前面那一堆收割机制,全建立在”Agent真的会按时返回”这个前提上,它要是不听话,后面全白搭。
历史记录那块是做减法。每条trial只压成三个字段:desc、metrics、status。注意是desc,不是hypothesis,上一轮Agent写进desc的那句话,就是下一轮Agent能看到的全部记忆。
写得含糊(“优化了一下结构”),下一轮没法参考;写得具体(“把FFN换成gated,参数量+3%,指标持平”),下一轮才知道往哪走。这三个字段怎么定,基本决定了它下一轮能想到什么。这地方最容易被忽略,又最影响产出。
六个故障,六条补丁
| 故障 | 补丁 |
|---|---|
| 进程悄悄死了,后端还在等 | 心跳30秒,120秒收不到判离线;离线是被动算出来的,不改存储状态 |
| 后端抖动一轮就废 | 整轮try/catch,出错等5秒重进,进程不退出 |
| 命令处理到一半崩了 | 确认分三态;有意不确认,命令留在队列里,下轮再做 |
| 同一结果报了两遍 | 上报幂等,按trialId去重更新 |
| 重启留下一堆孤儿进程 | 启动与退出都统一清理,状态文件分开命名 |
| 会话超时被杀,这轮白干 | 提交后立刻写记录,否则下轮不知道提过什么 |
第三行和第六行值得多看两眼,它们不是系统坏了,是有些状态压根没定义清楚。
命令队列天然会遇到这个问题:worker拿到命令,处理到一半崩了,这条算处理完了吗?确认要是只有成功和失败两态,“崩了”只能算失败,可失败的意思是”这条不用再做了”,而它其实应该被重做。所以确认分三态,还留了一个口子:不确认。命令留在pending里,下一轮再取。
这样一来,“不确定”就成了一种正常状态,不用急着把它消掉。
还有一处退避在调度侧:worker退出时按2的n次方秒重新拉起,1秒、2秒、4秒,最多3次。
const delay = Math.pow(2, restartInfo.count) * 1000;
if (restartInfo.count < (opts.maxRestarts || 3)) {
  // 重新拉起:1s → 2s → 4s
} else {
  await reportTaskFailed(...);   // 超上限就上报失败
}
为什么只给三次?反复崩的worker,十有八九不是运气差,是环境坏了:凭据过期、依赖没装、接口改了。这种时候重启只会多烧token,把问题拖成一条”一直在重试”的日志。
设这个上限,图的是让故障早点暴露,省不省钱倒在其次。
十二个坑:把平台没说出口的规矩写成文档
如果只让我留一个文件,我留那份平台操作手册,221行,最后一节叫”已知坑总清单”,十二条。
里面记的不是我们的代码,是平台那些没说出口的规矩。挑几条:
| 坑 | 表现 |
|---|---|
| submitId藏在redirectUrl里 | 响应里没有独立字段,得从跳转URL的query里抠 |
| 改参数要三件套 | URL query、毫秒时间戳header、值要encode,少一样静默不生效 |
| 队列选错集群 | 指标计算直接exit 13,报错信息完全指不到根因 |
| 读指标要用快照组件ID | 用主画布ID查,返回空 |
| 指标组件必须独立运行 | 走上游模式,即使成功也读不到 |
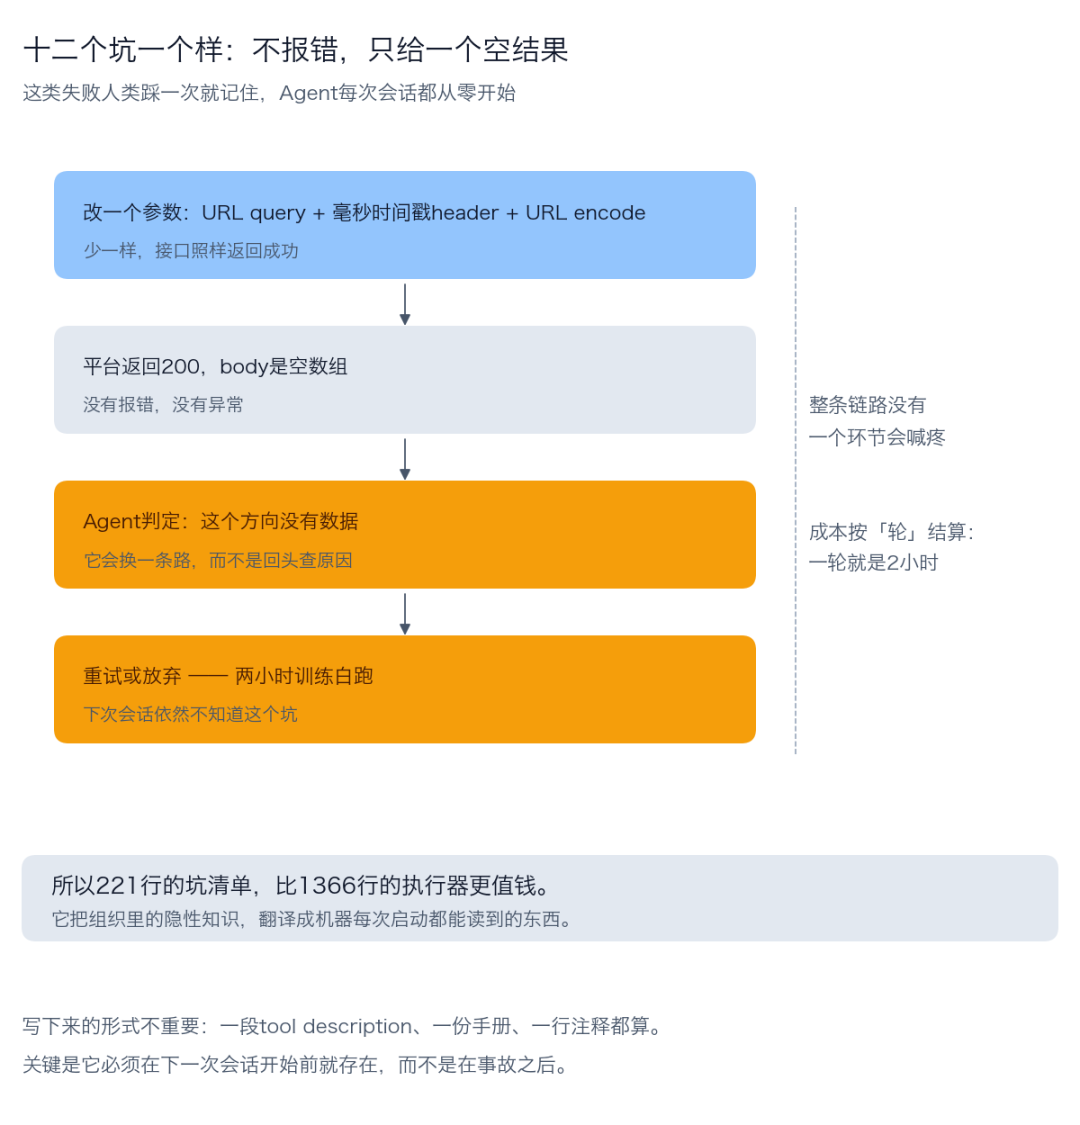
静默失败
图6|十二个坑一个样:不报错,只给一个空结果。不抛异常,返回一个空数组就完了;成本却按轮结算,一轮就是两小时。
人踩过一次就记住了,Agent每次会话都从零开始,它没有”上次那个坑”这回事。所以这份文档不当接口教程写,它记的是老同事嘴里的经验,好让机器每次启动都能读到。
写了,Agent第一次上手就能绕开;不写,它每次都得重踩一遍,一次两小时训练。
四、跑出来的结果
讲了这么多机制,看结果。
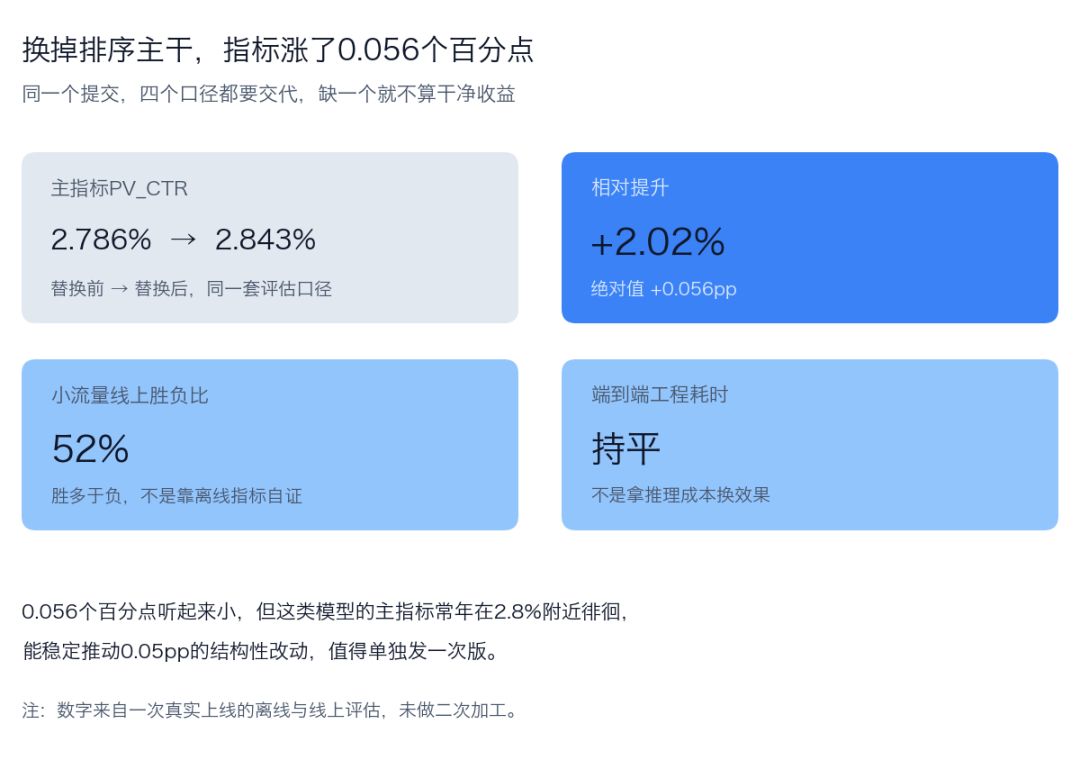
一次真实产出
图7|同一个提交,四个口径都要交代。缺了”工程耗时持平”这一行,收益就不干净。
+0.056个百分点听起来小,可这类精排模型的主指标常年在2.8%附近徘徊,能稳定推动0.05pp的结构性改动,值得单独发一次版。
工程耗时这一行必须交代。换结构最容易出现的情况是效果涨了、推理慢一倍,那不叫优化,只是换了个更贵的模型。这次没出现,所以这个收益站得住。
回头看,这类任务能被交出去,是因为同时满足四个条件:目标能用一个数说清、改动只碰一个模块、失败能整条退回、几个方向互不干扰。
反过来也一样:目标说不清、改一处牵全身、失败退不回来的实验,它干不了。这东西有边界。
五、想自己搭一套,先写这四份东西
这套系统没开源,下面的片段来自内部实现,已经脱敏。真正能抄走的,是四份文档。
第一份,一个最小的状态机。
submitted ──成功──> completed
    ├──────失败──> failed
    └──────24h───> failed
两个终态,加一条超时路径就够了。别设”处理中”这种中间态,一设状态机就变成一张网,网是没有测试能盖全的。
第二份,一条在途上限。
别拿并发数当上限,用没收的数。并发数说的是”我开了几个”,没收的数说的是”我还欠几个结果”,会堆起来的是后者。
第三份,一份判据表。这是对平台的验收标准,每条都能自己测:
| 判据 | 怎么测 | 通过标准 |
|---|---|---|
| 崩溃后可恢复 | kill掉worker再重启 | 第一轮日志出现收割记录 |
| 超时不悬挂 | 造一条pending指向不存在的任务 | 24h后变failed,不是永远挂着 |
| 闸门生效 | 在途上限设成1,连跑两轮 | 第二轮只有收割,没有新提交 |
三条判据覆盖三种不同的坏法:崩溃、悬挂、越界。再多就没人测了。
第四份,一份坑清单。格式固定成三行:现象、原因、正确做法,外加一行”不写会怎样”。判断标准很简单:这份清单能不能让一个从没见过这个平台的人,一次就把参数改对。能,就合格。
写的顺序也有讲究:先做落盘,不然崩一次就全忘;再做状态机,不然说不清谁欠着结果;最后做闸门,不然队列会被打爆。反着来也能跑,就是第一次崩了得推倒重来。
四份里只有判据表能当天验完,其余三份都得等事故来考。所以别指望一次写对:先写最小的一版,跑起来,让它崩一次,再把崩出来的那条补进去。
有句话可能不中听:很多人的第一反应是”把这些要求写进系统提示词不就行了”。提示词管不住崩溃,进程被杀的时候,提示词已经不在内存里了。文档的价值恰恰在于没有进程的时候它还在:落盘的记录、队列里的状态、下次启动读到的坑清单。提示词只对这一次会话有效,文档对下一次启动有效。
所以落盘要最先做,而且当天就能验:跑起来之后手动kill一次,看jsonl里有没有那条submitted。有,说明它崩了也知道自己欠着什么;没有,后面全是空中楼阁。
还有个容易漏的点:别给Agent看全量历史。每条只留三个字段是故意的,历史越长它越容易在旧结论上打转,而且每轮都要重读一遍,token全花在回忆上。
两个真踩过的坑
坑一,停止只改了本地变量。
现象:后端显示已停止,平台上的训练还在跑,卡继续烧。 原因:本地改了不等于对面停了。跨系统的操作,得在对面看到结果才算数,本地把变量清空没用。 正确做法:真的去调平台的stop接口,并在下一轮用终态查询确认它停了。
坑二,选错集群,报错指不到根因。
现象:训练成功,指标计算组件exit 13,日志是空的。 原因:集群ID决定了指标计算的环境,选错了连指标都算不出来,报错只告诉你退出码。 正确做法:把集群写进坑清单的固定字段,提交前校验一次,不要靠Agent记得。
环境与未实测声明
运行环境:一台装着git和平台CLI的Linux或macOS机器,Node.js 18+,一个能长时间存活的进程管理器。这套代码没有开源,上面的片段是真实实现;判据表的第三条我在系统上验证过,但没有可复现的公开环境,所以本文不给截图、不给命令。
六、它做不了什么
只讲成功没意思,下面这几条我自己也还在踩。四条局限都成立:
| 局限 | 影响 |
|---|---|
| 没有GPU资源感知调度 | 并发只按worker数限制,不知道集群还剩多少卡 |
| 调度进程不会自动拉起 | 需要人工重启,这期间任务名义上还在running |
| 任务没有failed状态 | worker全崩之后仍显示running,得靠人看出来再停 |
| 重试与否由Agent判断 | 同一假设要不要重试,取决于它当时的判断,不稳定 |
这四条看着像工程债,其实是一回事:调度做得越简单,越得有人盯着。这东西本来就是替人跑腿的,不是替人值班的。
前三条都能靠加监控、加人补上,第四条不能。重试与否由Agent判断,意味着同一个假设昨天被放弃、今天可能被重试,同一份历史跑两遍未必有一样的结论。这条最难补,也最影响”结论能不能被引用”。
比这四条更根本的还有一条:它只会沿着一个方向往下试,不会自己换方向。
把warmup从2000试到4000,是沿着一条路往下走;想到”warmup这个维度根本不用调,该换的是整个优化器”,是换一条路。前者它擅长,给个方向就能走到头;后者它做不了,因为它每一步都是从历史记录里相邻的点推出来的,历史里没有的东西,它想不出来。
所以用法应该是人给方向、它把方向走完,而不是让它自己找方向。这个分工不酷,但能把人从两小时的等待里捞出来,让他去想下一个方向。
它还会放大你的错误。研究方向错了,它不会质疑方向,只会在错的方向上更快地跑到尽头,一轮两小时,跑得越顺,错得越彻底。
还有一个不容易注意到的代价:试错变便宜之后,人会不自觉地多试。轮数闸门管的是一个方向,管不住方向越开越多,同一个目标开五个方向,成本就是五倍。它也不会告诉你”这条路走到头了”,只会把20轮用完,然后交给你一堆不显著的结论。什么时候该换方向,还是得人看。
什么时候该关掉它?三条里占一条就别信它的结论:指标抖动大到一次实验说不清、评估周期长于一天、改动需要跨多仓。这三种情况下,它给出的”keep”可能只是噪声刚好涨了一点点。拿不准的时候,先按没收益算。
剩下要人干的事:提方向、判断这波收益值不值得发版、把踩过的坑写成文档。前两件靠判断,第三件靠写,把脑子里那点经验写成机器每次启动都能读到的东西。
所以它更像放大器,不像研究员:方向给得准,放大出来的是收益;方向含糊,放大的就是噪声。它的位置是把一个想法验证到底,不是替你想下一个想法。
参考
-
MaskNet:用实例引导的掩码做特征交叉,本文替换前的排序主干结构
-
RankMixer:替换后的结构,参数量与推理耗时基本持平
-
代码片段:内部实验装置(执行器、收割模块、平台操作手册),已脱敏
-
平台行为(退出码、快照组件ID、submitId位置):来自坑清单原文
你们团队的自动化实验,卡在”等”还是卡在”记”?评论区说说你在哪一步放弃的,我挑三个写进下一篇。
我是 Aaron,10 年算法工程经验,每周拆一个 AI 新东西的实现细节。 关注「AI 拆解猿」,每周拆一个 AI 协议、框架、源码或架构,直到你能自己动手。
