133ms一帧,Haru不会因为你也开口就停下来
摘要:全双工语音模型Haru-4B,4000万小时真实语音、7.5Hz、64维连续latent、单步MeanFlow,一帧133ms、端到端65ms。反差是它不遵循指令、事实不可靠,官方只当研究模型发布。
先说结论
Haru-4B是一个开源的全双工语音模型。它不像对讲机那样等你说完再开口,而是每133ms同时吃进一帧你的音频、吐出一帧自己的音频和文字——听和说在同一次前向里做完。
这套结构里有三个反常识的选择,也是全文要拆的三件事:
-
三条流不是拼接,是相加。 用户音频、模型音频、模型文本各自编码后逐元素相加,塞进Transformer的同一个位置,序列长度只有”交错方案”的三分之一。
-
音频不是token,是连续向量。 一帧3200采样点压成64维,帧率7.5Hz。没有码本、没有RVQ、没有独立的音频Transformer。
-
生成不是多步采样,是一步回归。 一个四层MLP用MeanFlow学”区间平均速度”,一次前向出整帧音频,不需要迭代去噪。
读完你能拿到:三条老路各自卡在哪一步;三流加和、MeanFlow、因果codec的代码落点;三条运行路径的可复制命令,我在M4 Pro上踩到的两个坑;以及四个能搬到你自己流式系统里的决定,和一条千万别照抄的。
图1|一帧里只有三进两出。三条流相加后进32层主干,同时产出下一个文本token和下一帧音频latent;整套系统里没有VAD,也没有轮次状态机。
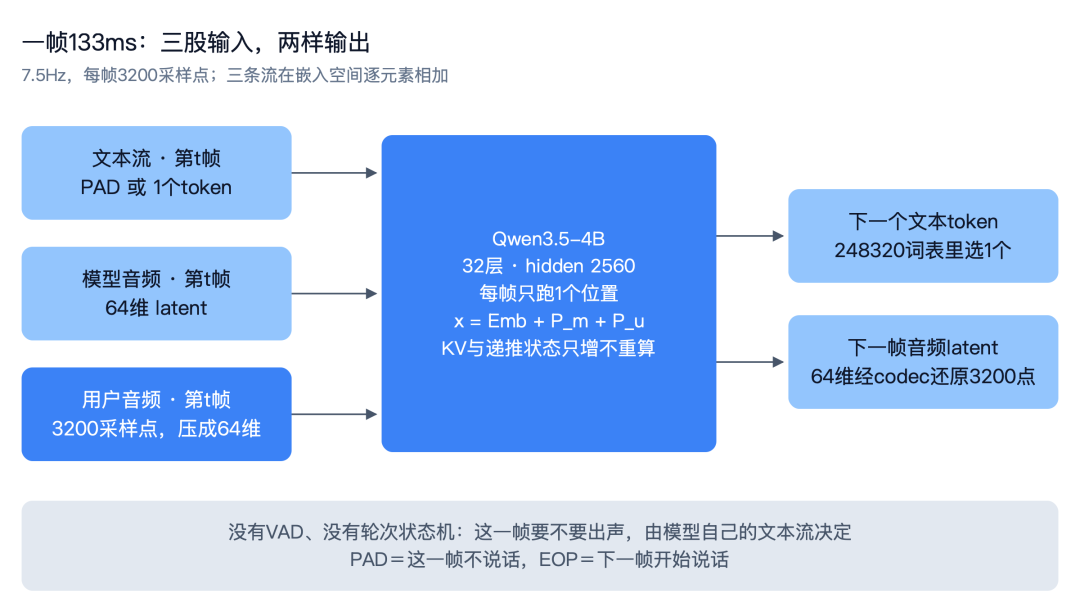
图1
别人是怎么做的,卡在哪一步
级联是最好实现的一种:ASR转写、LLM生成回复、TTS合成,三段串行。它卡在”等”字上。ASR要等一句话出现足够长的静音尾巴才敢出结果;LLM要等整段转写完才开始想;TTS要等整句文本齐了才开始合成第一帧波形。三段延迟相加,而且插话无从谈起——你开口的那一刻,系统正在合成它上一句,它听不见你。
轮流是目前商用语音助手的主流:用VAD判断”你说完了没有”,然后一方独占。它卡在”重叠”。人说话会附和、会抢话、会用”嗯”接住对方,这些行为在轮流模型里全被当成噪声,因为模型在结构上就没有”一边听一边说”的通道。打断判定同样是硬伤:VAD一检测到双方同时有声,只能选一个丢掉,丢谁的规则怎么写都不对。
三流交错是研究里常见的一种:把用户音频、模型音频、文本按token排成一条长序列,让模型自己学对齐。这条能学到重叠,但卡在长度——每跑一步要往序列里塞三个位置,一小时对话就是八万多个位置(7.5×3600×3,这是我的推算),KV cache和注意力的开销都跟着涨;文本流还被音频token切碎,字与字之间夹着两段音频。
Haru换了第四个做法:三条流各占同一个位置,逐元素相加。官方对比图上标得很清楚:同样6帧,交错排开18个位置,加和只剩6个,正好三分之一,和纯文本模型一个量级;文本流连续,不被音频打断;也没有”轮次”这个概念需要维护。
这个做法能成立,前提是数据。VAD永远标注不出”附和”——它只知道有没有声音,不知道这声”嗯”是接话还是插话。要让模型学会这些,只能用真实对话录音,配上足够长的上下文。
图2|同样6帧,交错要18个位置,加和只要6个。前三种都不允许双向同时;最后一条把三流叠进同一格,位置数掉到三分之一。
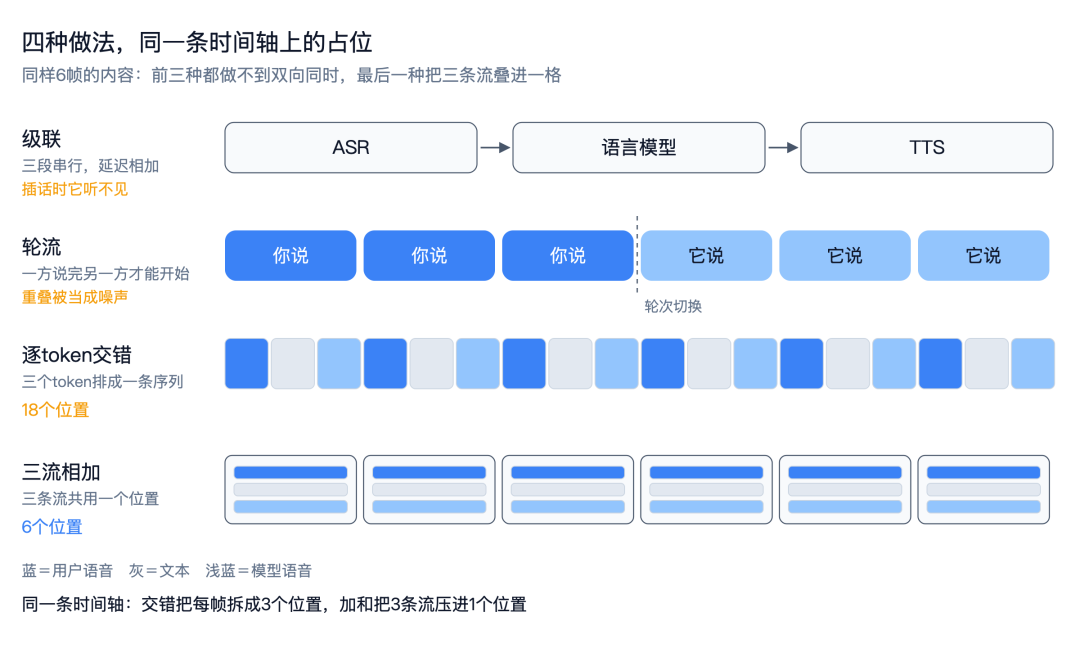
图2
三条流挤在同一个位置里
三流加和的形式很简单:
x_t = Emb(text_t) + P_m(z_m_t) + P_u(z_u_t)
第t个位置吃三样东西:模型自己第t帧说的字(没说话就是PAD)、模型自己第t帧的声音、用户第t帧的声音。两路音频各自过一层投影P,加到文本嵌入上,进同一个位置。输出也是两样:第t+1帧的文本token,和第t+1帧的音频latent。
注意因果方向:第t个位置产出的是第t+1帧。音频latent是下一帧的输入,所以”模型刚说出来的声音”会立刻变成它自己下一步的上下文。这也是它能在别人说话时继续说自己那句的原因——上一帧的声音还在输入里,它不会因为被打断就失忆。
代价是加法本身不区分来源。三条流挤在同一个2560维空间里,模型必须自己学会”这是我的声音、那是你的声音、这是我现在该说的字”。结构上没有任何东西保证它分开,只能靠数据量喂出来。官方训练用了4000万小时真实语音(160+语言,9个主语言),第二阶段再补1300万小时用语音分离拆出来的双工对话,单条样本最长60分钟。
加和能成立,还有个不显然的前提:位置必须真的对齐。
整段prompt分三段(图3)。角色卡是ChatML的一条system消息,不带音频。参考音频3秒到3分钟,编码成latent放在模型流上,文本流全是PAD、最后一帧是EOP——等于告诉模型”这段话是我刚才说的”,音色条件就这么给进去,不需要额外的speaker embedding。实时段三条流全开,用户音频进、模型音频和文本出。
图3|prompt三段,掩码决定哪条流参与。角色卡位置两条音频流都置零,参考音频只在模型流上,实时段三条流全开;蓝色是这一帧的真实输入。
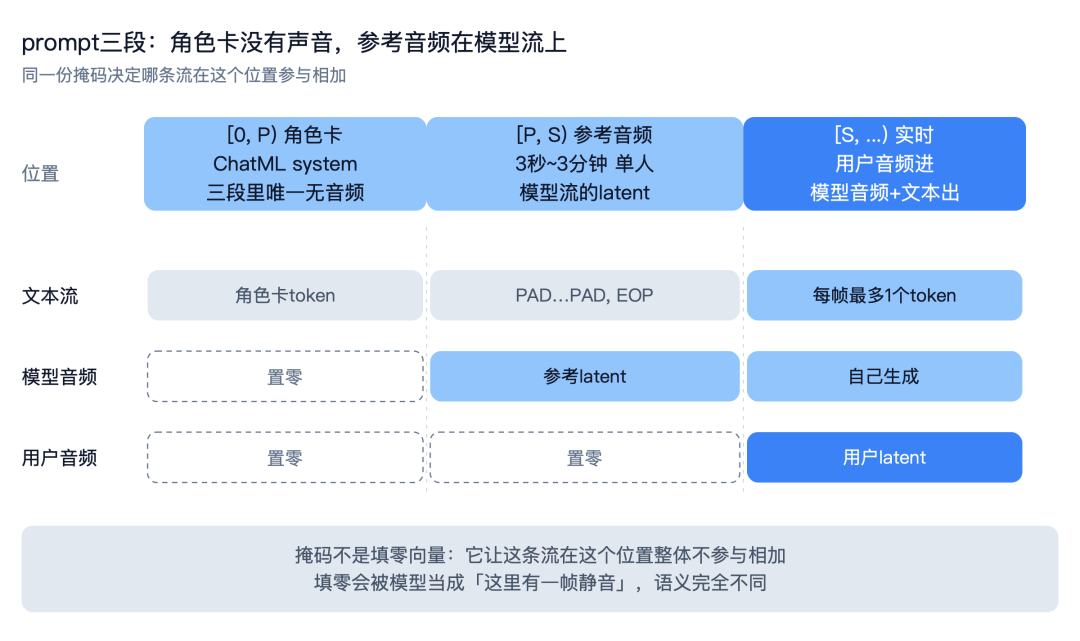
图3
“置零”这个说法要小心:代码里不是填一个零向量,而是把这条流的投影结果整体乘0,语义是”这个位置这条流不存在”。填零向量会被模型当成”这里有一帧静音”,两者在训练分布里不是一回事。
然后是那个容易忽略的时序约定:模型永远领先一帧。
start()跑完prompt就直接产出第0帧,一个采样点都不需要用户提供;之后每收到用户第k帧,产出模型第k+1帧。所以用户第k帧最早影响的是模型第k+1帧,算法延迟下限就是一帧。这个数字不是优化出来的,是结构决定的——想再快只能改帧率。官方那个65.2ms只算一帧的进出,不含凑帧;端到端还得加最多133ms。
图4|领先一帧的时间轴。模型第k+1帧在用户第k帧到达时就算完,赶在用户说第k+1帧的那133ms里播出去。
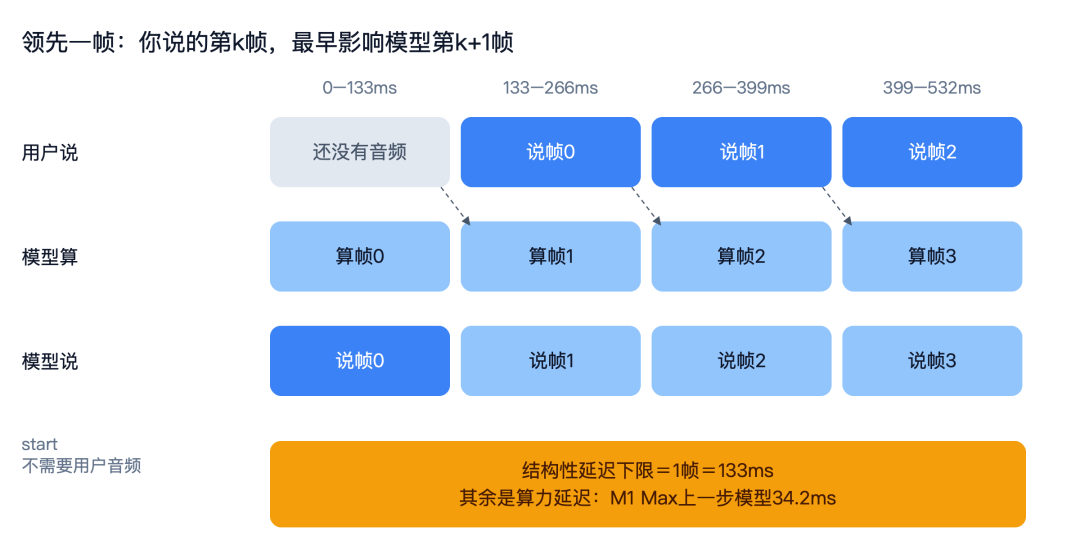
图4
五处实现细节,决定了133ms能不能做到
一帧3200个采样点,压成64维
编码器是VibeVoice的因果声学tokenizer:24kHz波形,6级跨步卷积下采样,stride依次是2、2、4、5、5、8,乘积3200——正好一帧的采样点数。通道从32一路翻到2048,最后压成64维。
通道翻这么高是有代价的:最后一级的8个Block都在2048通道上跑,codec那0.344B参数里,大头都堆在这8个Block上。反过来,最高分辨率那层只留32个通道——波形层面的建模用不上宽通道,堆在那儿纯浪费。
这里有个工程上最容易被忽略、又最要命的设计:每一层卷积把左上下文当显式状态传进传出。
# 每层记住左上下文,形状 (in_ch, kernel-stride)
def state_shape(self):
    return (self.in_channels, self.context)

# 整段跑时初始状态全零;逐帧跑时把上一帧的尾巴拼在前面
x = torch.cat([state, x], dim=-1)
y = F.conv1d(x, self.weight, self.bias, stride=self.stride)state就是这一层需要的”历史尾巴”。于是同一份权重,训练时整段跑、推理时逐帧跑,测试断言相对误差小于1e-4(haru_mlx/tests/test_model.py:76的test_codec_stream_equals_whole_clip)。
没顺手解决这件事的代价很典型:离线听起来正常,上线逐帧就出现咔哒声和音色漂移,然后你花两周怀疑是采样率问题。逐帧编解码的另一面是成本:每帧都要跑完整条编解码栈,PyTorch实现约6ms,仓库用Triton kernel加CUDA graph重写成每帧一次图回放,降到0.7ms。
图5|逐帧与整段等价,靠状态把左上下文搬过去。上面是一次喂4帧,下面是逐帧喂、每帧把state传给下一帧;蓝块是被传递的状态。
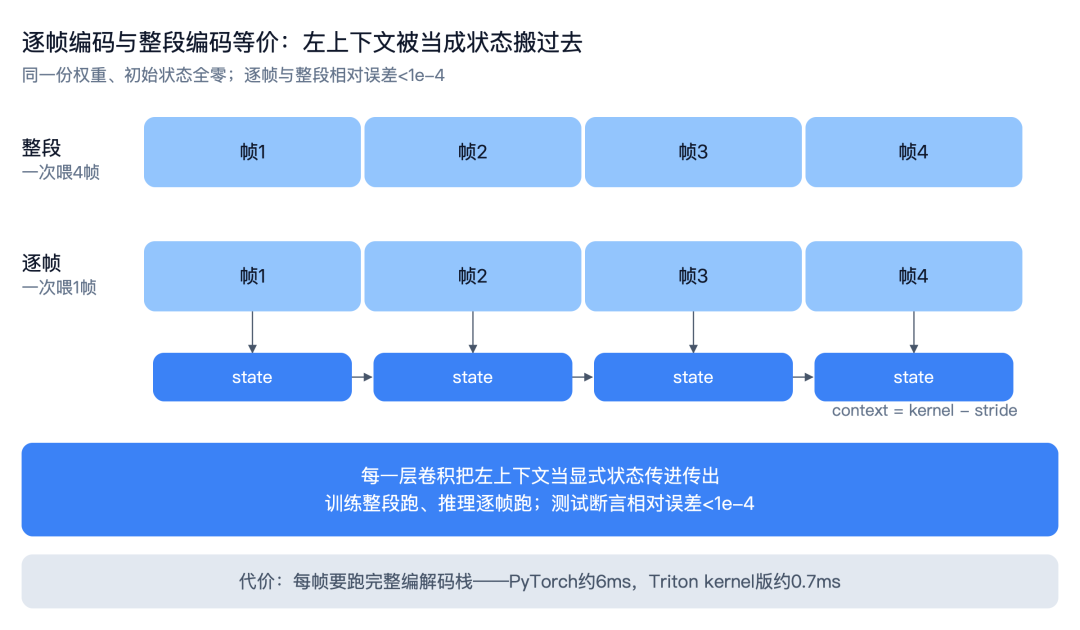
图5
从噪声直接算到音频,中间不迭代
常规做法是扩散或flow matching:从噪声出发解ODE,走N步,每步一次前向。语音交互每帧都必须出结果,N步就是N倍算力。
MeanFlow换了个学习目标:不学瞬时速度,学区间平均速度。
u(z_t, t, r) = (1/(r-t)) · ∫_t^r v(z_τ, τ) dτ
学过之后,从t到r的位移就是一次乘法:
z_r = z_t + (r - t) · u(z_t, t, r)
推理时r-t=1,从纯噪声一步到数据,网络只跑一次——这就是”1步”的全部含义。
指引(guidance)也做进了网络输入,而不是跑两遍模型再插值:把ω=1-1/w做成标量嵌入加进条件,w默认1.5(有效范围1到2)。w在训练时就作为条件喂进去,推理一次前向就得到引导后的结果。这套单步不是直接训出来的:先用Flow Matching训好生成头,再蒸馏成一步。这一步很关键——CFG跑两遍是2倍算力,而一帧的预算里没有第二遍的位置。
时间t、区间h、常量7.0、ω这四个标量,各自过正弦嵌入加两层MLP,相加后走一次SiLU,再由一个融合的ada矩阵一次算出四层的(shift, scale, gate)。MLX版把这个矩阵的权重叠在一起算,省掉多次小矩阵乘。
# 时间t、区间长度h、常量7.0、指引ω,各自嵌入后相加
c = c + self.t_embed(t) + self.dt_embed(h)
c = c + self.interval_embed + self.omega_embed(omega)

# 一次前向出速度场,乘区间长度就是这一步的位移
z = z + h * self.velocity(z, c)还有一个数字:codec编码器输出的是均值,采样时要加σ=latent_std/0.8=0.625的高斯噪声。所以它既不是确定性回归,也不是多步采样——一步,但带随机性。这也是同一段参考音频、同一个角色卡下,每次生成语气不完全一样的原因。
图6|一步与多步的区别。左边是常规flow matching的ODE路径,右边是MeanFlow:学区间平均速度,一次前向跨完整个区间。
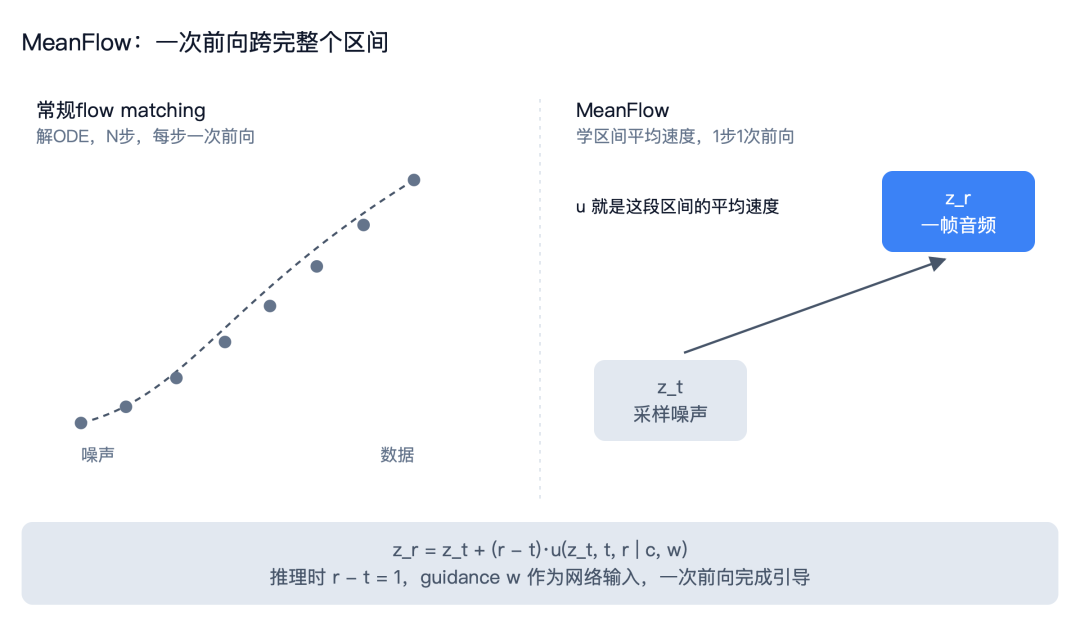
图6
这一帧说不说话,取决于两个logit
一帧可能对应0个字、1个字,绝不会对应半句话。Haru不做token级强制对齐,而是让文本流自己承担节奏:这一帧有字就出1个token,不说话就出PAD(id 248076),要开口的前一帧出EOP(id 248071)显式表示”下一帧开始说”。
于是”什么时候轮到我说话”退化成一个分类问题——而这正是最不能糊弄的地方。官方还给了一条理由:逐token对齐会切碎文本,容易忘掉预训练的语言知识。PAD和EOP的logit用float32重算,代码注释写得很直白:这两个logit的差常常小于bfloat16在该量级的分辨率。用bf16算,“这一帧说不说话”可能是随机的。
# 只对PAD/EOP这两个token的位置用float32重算,其余照旧
# 官方注释原话:PAD与EOP的logit差常小于bf16分辨率
# 分辨率不够,“这一帧说不说话”就可能变成随机的
return hidden.float() @ weight[tokens].float().T
另一个细节是DRY重复惩罚(multiplier 0.8、base 1.75、lookback 1024、最大匹配长度32),PAD/EOP/EOS豁免。豁免名单很关键:把PAD也罚下去,模型会为了不被罚而强行说话。
还有个容易被忽略的小坑在detokenizer:连续多个PAD被折叠成一个空格,没拼完的UTF-8字符先暂存。前者影响观感(否则文本流里会冒出成串空白),后者影响正确性(中文一个字三字节,被帧边界切开时必须等下一帧补齐)。
一小时会话,KV cache不能线性涨
32层里24层是Gated DeltaNet(线性注意力),8层是全注意力,每4层一个。线性层给常数大小的递推状态,全注意力层负责检索。
递推本身不长:
S = g·S + β·(v - S·k)·k^T,y = S·q
g是衰减门(exp(-exp(A_log)·softplus(a+dt_bias))),β是写入强度,q/k先做L2归一化。每一步只更新一个固定大小的状态矩阵,历史不会被重新算一遍。
一小时会话是两万七千帧。如果32层全用全注意力,KV cache按帧线性涨;换成3:1混合,大部分层的历史被压进状态矩阵,这就是它敢把max_frames设成27000(60分钟)的原因。代价是检索能力压到8层里,翻旧账不如纯全注意力——所有混合架构都吃这个亏。
权重就一份,三套实现各自补了不同的洞
同一份checkpoint,仓库给了三套实现:NVIDIA上的PyTorch、Apple silicon上的MLX、以及vLLM引擎插件,Python接口对齐。
PyTorch版最直接:transformers的Qwen3_5TextModel加DynamicCache,每帧追加一个位置。codec有Triton加速路径,服务端是aiohttp加二进制WebSocket。
MLX版把主干重写了一遍,因为MLX生态里没有Qwen3.5的混合注意力实现。重写的关键不在数学,在权重映射:融合的gate_up、四合一in_proj、RMSNorm存的1+w、卷积权重的通道布局,全写成一份可校验的转换计划,逐个tensor核对,而不是strict=False然后祈祷。
vLLM插件最有意思,因为它要对抗引擎的基本假设。引擎认为请求是无状态的、可以抢占、可以重算;而Haru的会话状态在worker里,重算不了。所以插件做了三件事:把音频编码挂在preprocess里、把MeanFlow头和解码挂在post_sample_multimodal_outputs里(音频必须在产出它的那一步就出去)、把recompute_preemption设成fail。同时明确列出不支持的引擎选项:异步调度、前缀缓存、投机解码、张量并行——这些都会破坏”一帧一步、状态原地推进”的语义。
这些做法换个系统也能用,最后一条是反例
Haru本身对你可能还是远的,但这套系统里有四个决定可以拆下来搬走。我按”搬什么、什么时候别搬”写清楚,最后一条是唯一不该照抄的。
先数一数两边同时说话的时长
全双工的复杂度全压在”同时”两个字上:数据要双通道、会话状态要长、评测要看重叠段。它不该是默认选项。
可操作的判断:抽20段真实录音,统计两路同时有声的时长占比;再看用户插话时,系统需不需要保留插话前那半句。我自己的经验阈值是5%,占比低于它、又不需要保留上文,级联或轮流的成本低一个数量级,还多了可审计性——每段转写、每句合成都能单独拿出来看。
反过来,重叠占比到15%以上(同样是经验值),或者业务本身就是陪聊、教学、会议记录,轮流方案的天花板是结构性的。换模型、换更大的基座都补不出来,因为缺的是通道,不是参数。
什么时候开口,让模型每帧自己选
Haru没做强制对齐:不标注每个字落在哪一帧,而是让文本流每帧三选一——出一个字、出PAD(这帧不说)、出EOP(下一帧开口)。一个原本要对齐到毫秒的问题,变成了逐帧分类。
凡是”发生在连续时间轴上、但决策本身是离散的”问题都能这么改:流式ASR的断句、实时字幕的标点与分行、机器人动作的起停、直播里精彩片段的切点。
图7|同一个问题,两种解法。左边是强制对齐:要逐帧标注,误差还会沿序列累积;右边是每帧三分类:不标注也能学,代价是精度和惩罚要给这两个控制符让路。
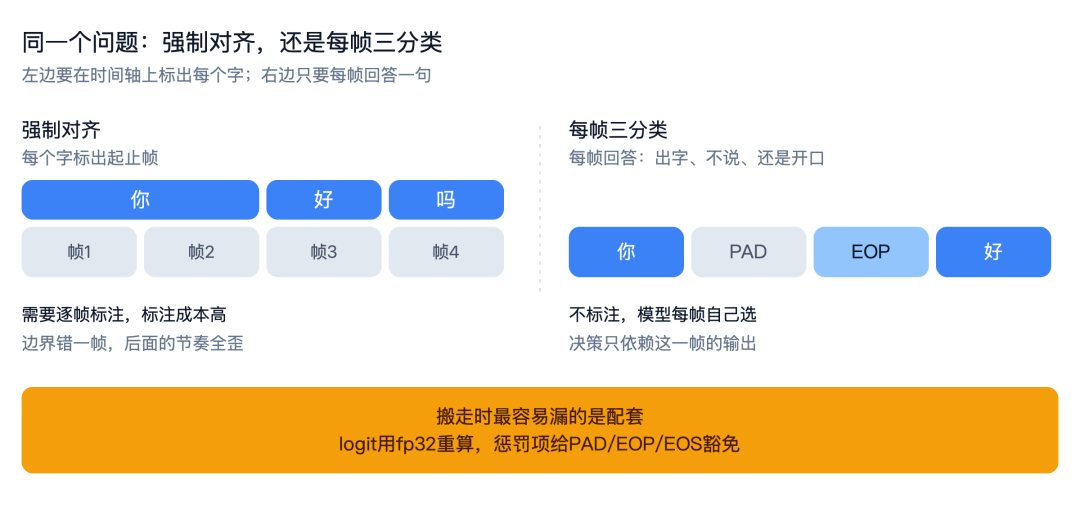
图7
但配套必须一起搬,这是最容易漏的地方:这个决策的logit精度要单独保证(Haru用float32重算PAD和EOP),重复惩罚要豁免这几个控制符(DRY对PAD/EOP/EOS豁免)。少了这两条,模型会为了不被罚而硬说话——分类器本身没坏,是被惩罚项逼歪了。
同一段音频,整段跑和逐帧跑得输出一样
这是全文性价比最高的一条,而且和模型无关。
Haru的做法前面讲codec时提过:每层卷积把左上下文做成显式state传进传出,训练时整段跑、推理时逐帧跑。你该搬走的是它的测试——拿一条音频,一次整段过,一次按帧喂并把state顺着传下去,断言两次输出相对误差小于1e-4。
写这个测试不到50行。没有它的后果很典型:离线听着正常,上线逐帧就出咔哒声和音色漂移,然后你花两周怀疑采样率。流式ASR、流式TTS、在线特征计算、实时视频编码,都该有这一条,它比任何性能优化都便宜。
预算30ms和300ms,选的东西不一样
MeanFlow常被说成”更快的扩散”,其实它换的是学习目标:不学瞬时速度,学区间平均速度,一次前向跨完整个区间。但这不是免费的。
训练侧要把区间长度、起点、指引强度都当条件喂进去,采样策略也要跟着改;质量上限还让给了多步。所以先算预算,我按经验分成两档:每帧300ms以上,多步采样完全够用,不必付这份复杂度;每帧30ms级、且每帧都必须出结果,这一步的收益才盖过成本。
判断标准不是”模型能不能一步出”,是”你的时延预算里有没有第二遍前向的位置”。
结构可以抄,那4000万小时抄不了
4000万小时真实语音、1300万小时双工、256张B200跑8天。这三个数字决定了”三流加和”能学会把三条流分开。但这4000万小时也不是拿来就用:录音先用Sidon做修复,双工那1300万小时得从单通道混音里分离,为此专门训了FastDialogueSidon;模型没训过一条原生双通道对话。
文档里那句”加法本身不区分来源,只能靠数据喂出来”,是全文最贵的警告。小团队照抄结构、拿几百小时数据训,得到的通常是一个会抢话的模型:它学会了重叠的形式,没学会什么时候该让。
图8|你复现的是推理,不是能力。左边开源:结构、权重、三套实现,你能跑、能改、能接;右边没开源:数据规模与处理管线,它才决定能力上限。
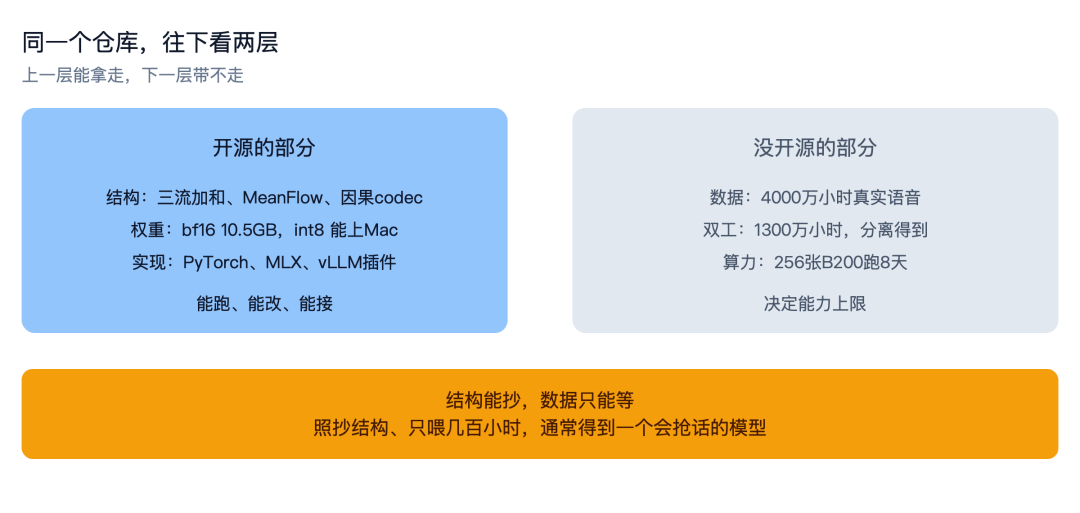
图8
所以看这类工作时,把结构创新和数据红利分开记账:前者能搬,后者只能等。这也是我判断一个开源语音模型值不值得跟的第一条——先看它的能力有多少来自结构,多少来自数据。
跑通测试之前,我先踩了两个坑
先声明:下面命令来自仓库README与源码,我没有用真实权重跑通对话——10.5GB的checkpoint在这台机器上没下完(Hugging Face实测约0.3MB/s)。真跑通的部分是:CPU上的单元测试42 passed/20 skipped,以及用仓库自带的tiny配置(随机初始化)跑通start()+step()全链路,首帧16.5秒编译、之后7-13ms一帧。
环境门槛先摆出来:Python 3.10以上;NVIDIA路径要CUDA GPU、约12GB显存;网页demo上传录音要ffmpeg在PATH上(WAV/FLAC/Ogg不需要);Mac路径要Apple silicon。
路径一:GPU加网页demo。
python3 -m venv .venv && source .venv/bin/activate
pip install -e ./haru
# 可选:codec用Triton从6ms降到0.7ms
# pip install -e "./haru[triton]"
python -m haru.server --hf-repo higurashi-ai/Haru-4B
# 打开http://localhost:8998
音色必须自己给:仓库不附带任何音色文件,在页面里上传或录一段3秒到3分钟的单人干净语音。浏览器只在localhost或HTTPS下给麦克风权限,所以别用局域网IP直接开。
常用参数里,--max-sessions默认1(超出排队),--time-limit默认3600秒,--network-profile local把缓冲压薄(同机或局域网用),--warmup-frames 16在加载后先跑16帧热身,免得第一个用户吃编译开销。
路径二:Mac加原生app。
cd haru_mlx
python3 -m venv .venv && source .venv/bin/activate
pip install -e .
python -m haru_mlx.run_inference user.wav reply.wav \
  --reference voice.wav --quantize 8 \
  --transcript frames.jsonl
cd swift && ./build_app.sh && open build/Haru.app
--quantize 8只量化主干权重矩阵与embedding表,codec、音频头、所有归一化gain保留bfloat16。理由写在README里:codec对数值敏感,量化收益小、风险大。
路径三:vLLM-Omni多并发。
pip install vllm==0.32.0 vllm-omni==0.32.0
pip install -e ./haru -e ./haru_vllm
vllm serve higurashi-ai/Haru-4B --omni \
  --deploy-config "$(python -m haru_vllm.deploy)"
端点是OpenAI Realtime事件协议,但节奏是Haru自己的:每追加3200采样点回一帧音频,max_tokens被设成1,一帧一个token。第一次append就会启动会话,返回的模型第0帧音频别用,发静音即可。
坑一:内网源装不上mlx-metal。
现象:pip install -e ./haru_mlx报ResolutionImpossible,提示依赖冲突。 原因:mlx-metal只有PyPI有macOS arm64的wheel,内网源不同步,解析器找不到它就只能报冲突。 正确做法:加--index-url https://pypi.org/simple。
坑二:Metal JIT编译被系统拒绝。
现象:跑pytest,GPU路径9个用例失败,报Unable to build metal library from source ... Operation not permitted。 原因:不是Xcode没装——xcrun -sdk macosx metal --version正常(Apple metal 32023.620),是运行环境不允许写Metal编译缓存。 正确做法:测试时把MLX默认设备切到CPU,能跑通逻辑测试(42 passed);实时对话得换一个不被限制的环境。
成功判据(看末行关键字,别只看”没报错”):
| 步骤 | 成功标志 | 失败时第一件事 |
|---|---|---|
| 安装 | Successfully installed,pip list有haru-speech-mlx |
换PyPI源重试 |
| 单测 | 末行42 passed,无failed |
确认设备是CPU |
| 冒烟 | 每帧index递增,audio_peak非0 |
查prompt是否为空 |
| 服务 | 日志出现监听端口,握手后立刻有第0帧 | 查显存与模型路径 |
最小验证流程我按这个顺序走,能少绕两圈:装完先跑单测;权重单独下完再启服务;先用haru-inference跑一条十秒wav确认能出音频、文本不重复;再开haru-server试实时;最后才加--codec-backend triton对比每帧耗时。
它不做什么,官方写得很清楚
-
不是助手。预训练基座,不遵循指令,事实不可靠。官方README的措辞是”released for research”,适合研究对话行为或做二次微调,不适合直接接客服。
-
音色克隆是能力也是风险。仓库不附带音色,只能用自己的;它模仿参考音频的能力是真的,滥用同样是真的。
-
双工数据是分离出来的。真实对话录音大多单声道,官方用FastDialogueSidon拆成两路;分离误差在重叠语音处最明显。官方”未来工作”第一条就是改用原生双通道录音微调。
-
4B主干限制知识量。能聊得像人,但别指望它答对事实问题——这不是对齐没做好,是参数量摆在那。
-
训练代码没开源。所有数据规模、训练时长只能引用博客,无法复核。
-
文本吞吐有上限。一帧一个token,长回答会比打字机式TTS更慢;对话场景不痛,播报场景会痛。
-
vLLM插件与引擎版本绑定。README明说用的是vLLM-Omni的model-runner hook,会随版本变;
recompute_preemption="fail"意味着会话被抢占就直接失败,生产上要自己做会话重建。 -
没有降显存的官方路径。约12GB显存是硬门槛,MLX的8bit只针对Mac。
放在坐标系里看:Moshi证明了全双工的可行性,但用离散码本加多步生成;VibeVoice证明了连续latent加7.5Hz可以合成很自然的语音,但不是双工。Haru把这两条线接在一起,同时给出Mac能跑的MLX版和能上生产的vLLM插件——这三点同时出现在一个开源仓库里,目前不多。
但也要说清代价:它把复杂度从”多模型编排”转移到了”训练数据”,而数据这一半没有开源。你能复现推理,不能复现能力。
参考
-
higurashi-ai/Haru,commit7fe6b76,README.md、haru/haru/models/{haru,meanflow_head,vibevoice_codec}.py -
haru/haru/session.py、prompt.py、sampling.py(会话协议、prompt布局、DRY) -
haru_mlx/haru_mlx/models/qwen3_5.py(3:1混合注意力与单帧前向) -
haru_mlx/tests/test_model.py:76(逐帧与整段等价的断言) -
官方技术博客
blog.higurashi.ai/melte/haru4b/(训练规模、延迟分解) -
模型卡
huggingface.co/higurashi-ai/Haru-4B(config.json的全部超参)
如果你正在做语音交互,最想先解决哪一段:延迟、打断,还是音色?留言说你的场景,我按投票拆下一篇(候选:Moshi的depth transformer、vLLM-Omni的双工协议)。
我是Aaron,10年算法工程经验,每周拆一个AI新东西的实现细节。 关注「AI拆解猿」,每周拆一个AI协议、框架、源码或架构,直到你能自己动手。
