大模型NO. 01
Agent该买还是该造,先看数据能不能出内网
内部Agent该买还是该造,第一道分叉不是功能对比,是数据能不能出内网。三档判定条件、一周到两周的验证方法、网关该不该加的三个问题,都写成了能直接回答是或否的形式。
内部Agent该买还是该造,第一道分叉不是功能对比,是数据能不能出内网。三档判定条件、一周到两周的验证方法、网关该不该加的三个问题,都写成了能直接回答是或否的形式。
4000万小时真实语音训出的全双工模型Haru-4B:7.5Hz、64维latent、单步MeanFlow,一帧133ms,官方65.2ms不含凑帧。反差是它不遵循指令,只当研究模型发布。
AutoResearch:一次训练2小时,排队8到20小时,编码Agent的会话却只有10分钟。解法不是更强的模型,是把“等”删掉:提交拿submitId就走,下轮收割。执行器1366行,最贵的却是221行坑清单。
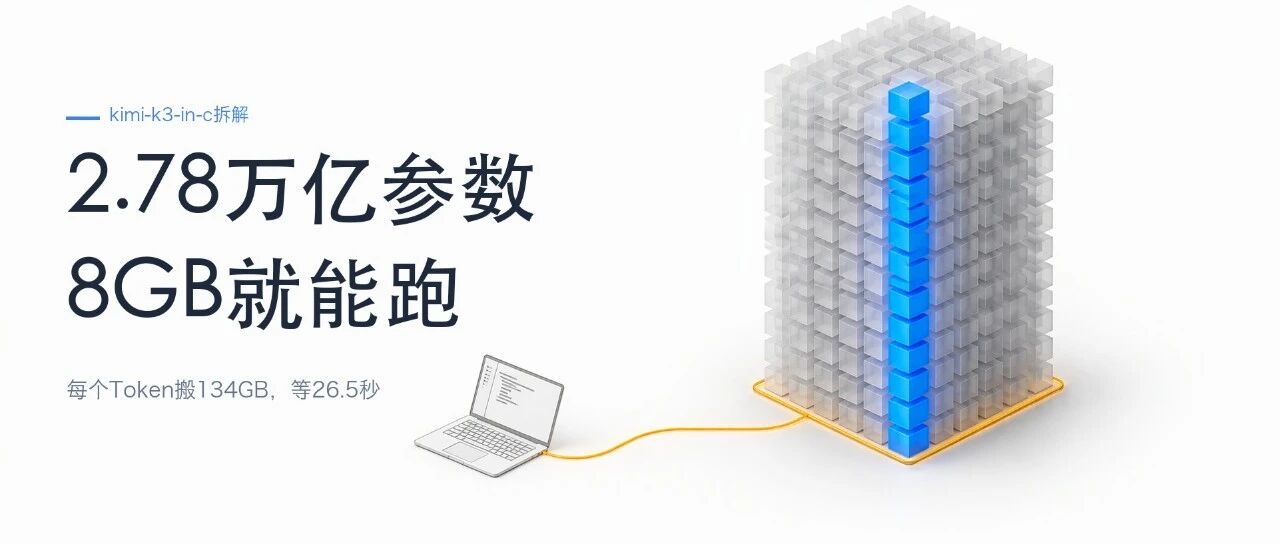
2.78万亿参数的模型,8GB笔记本就能跑。代价是每个Token从磁盘搬134GB、等26.5秒。176KB的C代码重新定义了哪些字节必须常驻——这才是它真正值得学的地方。
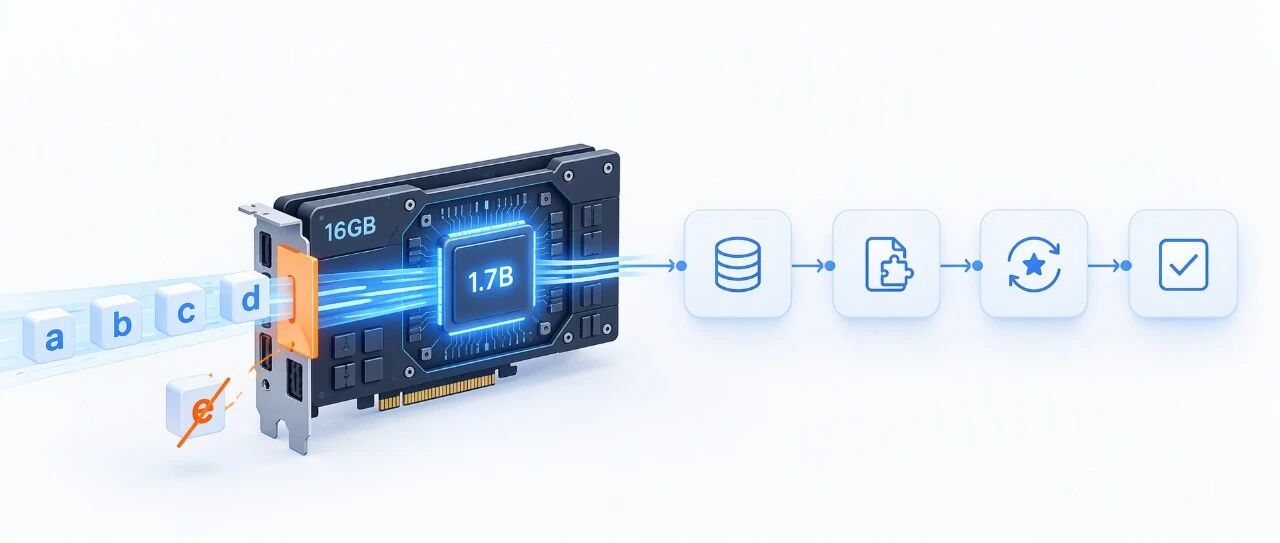
一张16GB显卡,通过微调把Qwen3-1.7B的可用率从0%训到60.5%:180条数据、LoRA SFT、GRPO组内比较、裁判评测,四步拆开讲,附单卡复现命令和失败判据。
Anthropic 开源的 FlashProve 让 400B MoE 不交权重,也能为每次回复出一份 18.78MB 的证明:普通 CPU 21 秒验完,代价是 93 倍算力。从协议、整数模型到单卡复现,一篇讲透可验证
开源大模型追平闭源,却卡在“本地跑不动”。FreeToken 把整台 PC 视为统一推理平台:按实测带宽动态分配 GPU/CPU 计算,配合双缓冲 prefill 与专家缓存,单张 5090 以 22~25 tok/s
5.4万star的DeepTutor,最值得抄的不是教学功能。港大团队把一次对话做成可恢复的数据库事务,把教学法写成 581 行不调模型的纯函数。本文拆解三处设计,附六个可平移的工程模式。
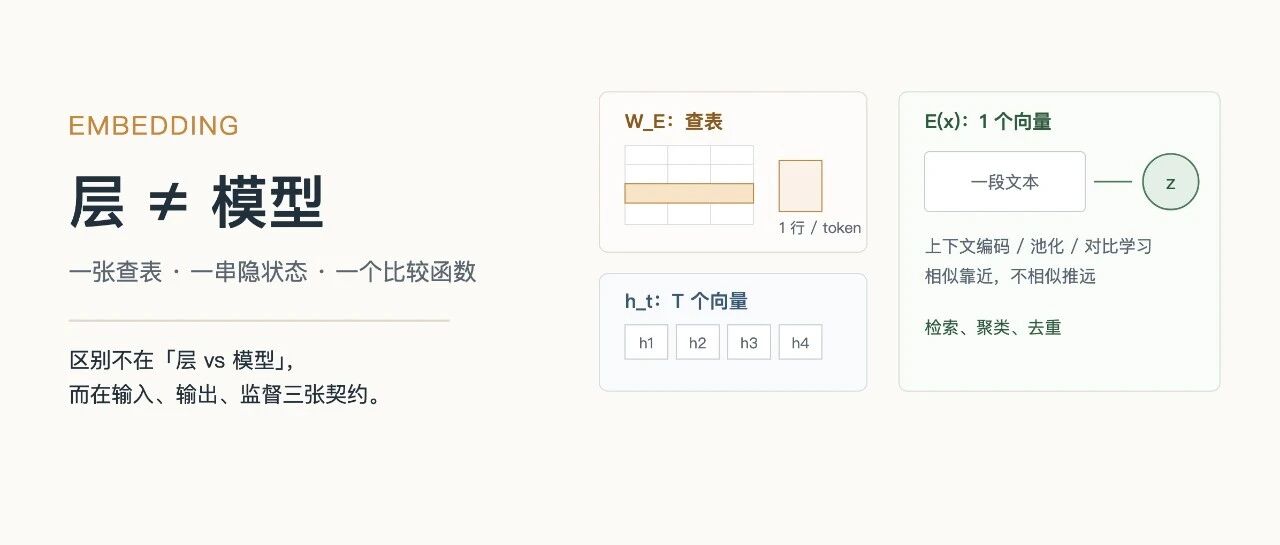
大模型的Embedding层,为什么不能直接拿来做检索?同一个名字,三种东西:一张查表、一串隐状态、一个被训练来比较的函数。
两个免root的手机 Agent,一个 4325 星,一个 721星,路线完全相反:一个自己写1500行adb 去借 shell 身份,一个靠无障碍加 Shizuku。有意思的是,两条路最后都写了同一个20 行的类。
没有 root,也没有系统签名,一个普通 App 怎么替你点微信、下单、截图?Mika 开源 48 小时拿到 1923 星——它自己写了一遍 adb 协议,借调试通道换到 shell 身份,再造一块看不见的屏,把 App