摘要:1.56TB的checkpoint(专家权重原样就是MXFP4)、108.8GB的主干按层流式读、每生成一个Token搬134GB;六个C文件、176KB的引擎,让2.78万亿参数在一台8GB笔记本上跑起来。我在macOS上编译:1.8秒构建、173条测试全过、五道oracle门逐位相等。
概述
2.78万亿参数的模型,在一台8GB内存的笔记本上跑起来了,代价是每生成一个Token都要从磁盘搬走134GB、等上26.5秒。它不是把模型塞进内存,而是重新定义了”哪些字节必须常驻”——这才是这个项目真正能学的东西。
读完你能拿走三样:
-
一本字节账:从5.56TB到8.24GB,四步各降一个量级,每一步都对应一个可以复用的决定(4位量化、稀疏激活、权重打包、流式读取)。
-
三个具体手法:4位浮点权重不还原成高精度就直接参与乘法;主干按固定顺序流式读;线性注意力把递归状态做成与上下文长度无关。
-
一套验证方法:没有那1.56TB权重,也能把引擎验到”输出逐位相等”;以及为什么作者会主动公布33%的噪声地板,还据此撤回了自己的结论。
图1|降维的每一步都是字节决定,不是参数决定。5.56TB是16位浮点全参,1.56TB是专家权重改存4位浮点之后,113GB是稀疏激活后每个Token真正要过的量,8.24GB是把主干也改成流式之后的内存峰值。代价写在右下角。
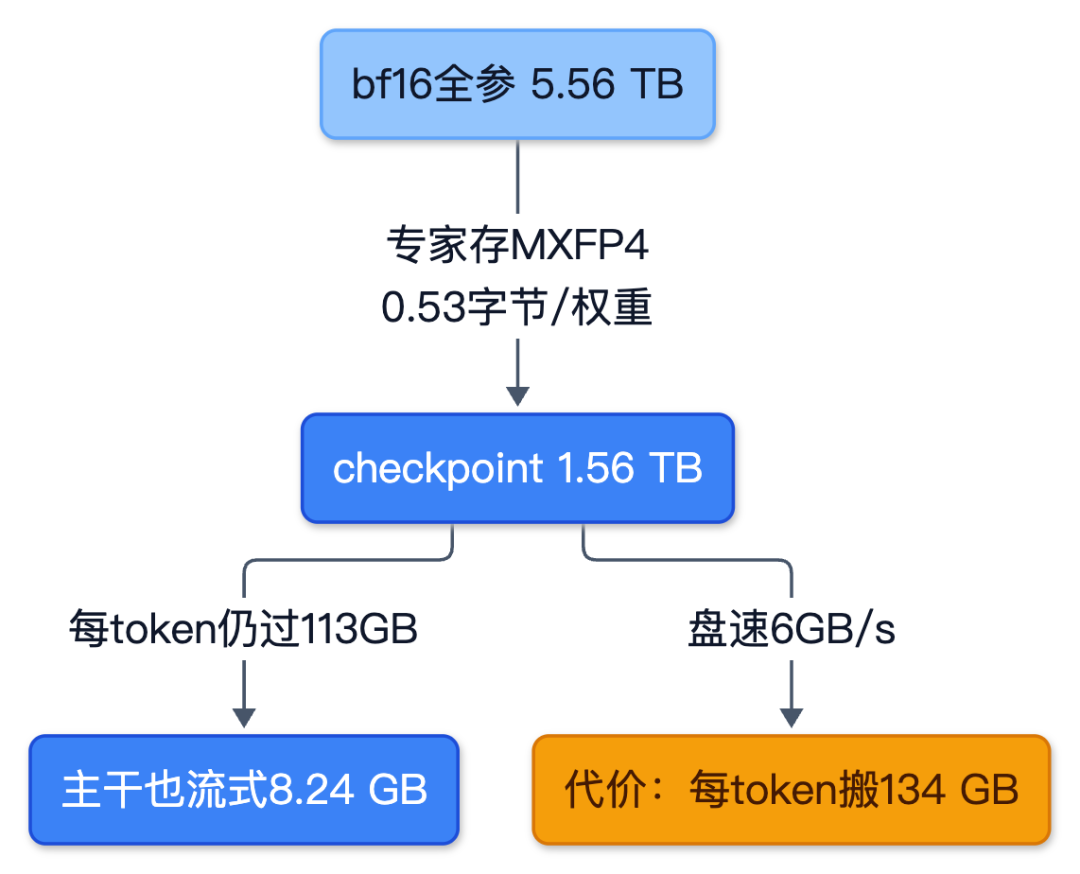
图1
一、为什么”装不下”不是容量问题
先算一笔最朴素的账。2.78万亿参数,bf16每个2字节,全参就是5.56TB。一台顶配工作站的内存在1TB上下,差着五倍;换8bit是2.78TB,还是差三倍;换4bit是1.39TB,依然装不下。任何”把整个模型放进内存”的路线,在这一步就已经死了。
常规的两条退路也都不通。
第一条是量化。 4bit基本是性价比的临界点,再往下掉点明显,而且1.39TB照样超过内存。更关键的是,量化在这里不是作者为了跑起来临时做的压缩——K3官方发布的checkpoint,路由专家本来就是MXFP4。也就是说,这不是一份”被牺牲了精度”的权重,而是原始权重就长这样。这一点很重要:它把”精度损失”从作者的账上划掉了。
第二条是offload。 把层换进换出,本质上是把模型当分页文件用。这条路上限就是磁盘带宽,而内存和NVMe差了将近两个数量级——前者几百GB/s,后者个位数。如果每生成一个token要把5.56TB完整过一遍,按6GB/s算就是十五分钟一个token(这是我的推算,不是实测)。所以”层换入换出”这种做法,只能应付”模型比内存大一点”的场景,模型比内存大三个数量级时,它退化成纯粹的磁盘扫描。
这两条路的问题在于,它们都在回答”怎么把5.56TB装进8GB”这个错问题。
真正的问题是:一个token前向的时候,到底有多少参数是同时活着的?
答案是很少。K3是MoE结构,93层里有92层是MoE,每层896个路由专家,但一个token只选16个,再加2个共享专家。主干(注意力、norm、embed、lm_head)每个token都要过,专家只过被选中的那一小撮。
于是问题被拆成两个可以分别回答的问题:
-
哪些字节每个token都要?(主干 + 常驻表)
-
哪些字节这次要、下次不要?(路由专家)
这两个问题的答案,决定了后面所有的设计。而且注意,这两个问题的性质完全不同:第一个是”必答题”,只能靠压缩和流式;第二个是”概率题”,可以靠缓存和预取。把它们混在一起调,就是大部分offload方案做得不理想的原因。图2把这两件事分开画了。
图2|一层里896个专家只有16个亮,相邻Token亮的还不是同一批。左边是一个Token经过MoE的路径:先降到3584维,路由打分后取前16个,2个共享专家全程参与。右边是第1层68个Token的真实路由记录:1088次请求只碰到150个专家,相邻两个Token平均只重合1.5个。
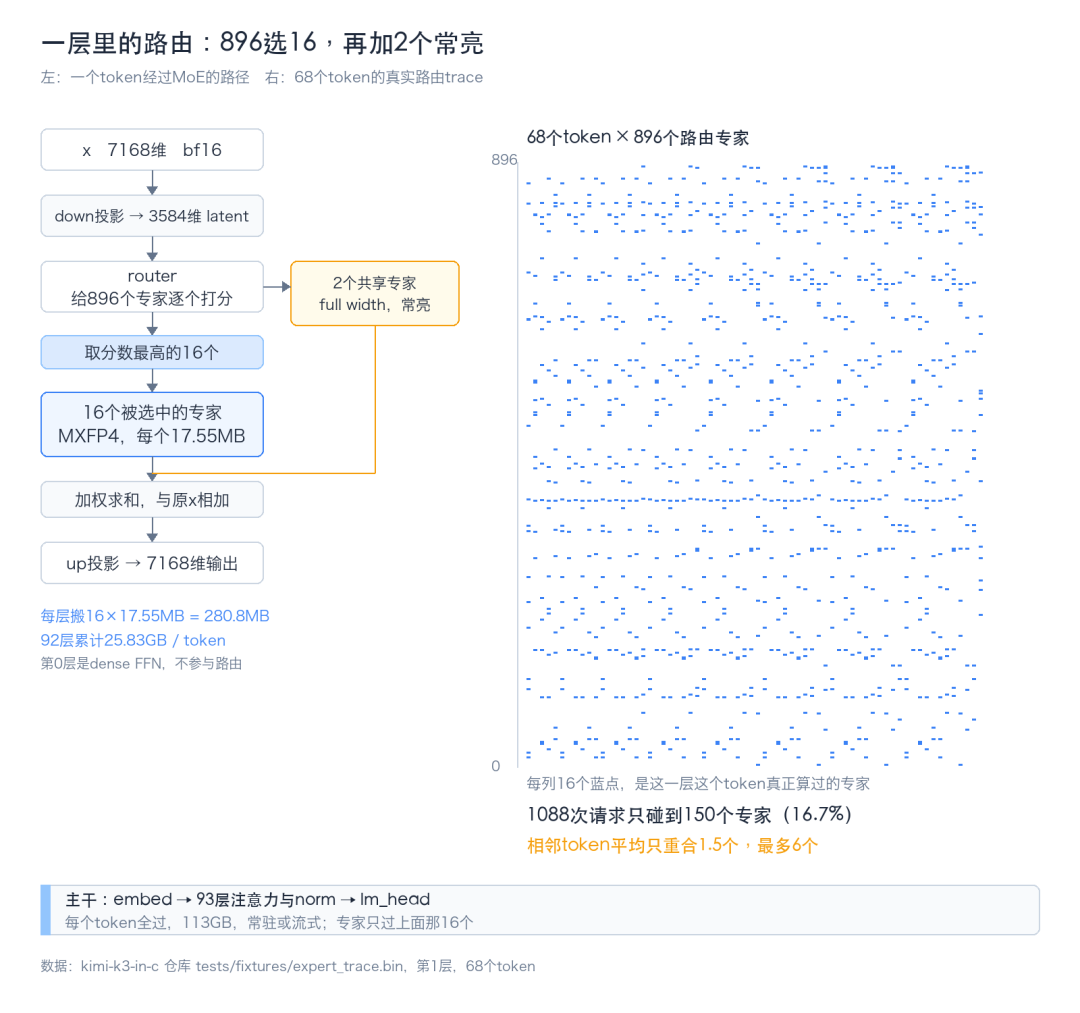
图2
二、四条流:把内存变成一个旋钮
作者的做法可以概括成一句话:能流式的就不常驻,必须常驻的就钉死。
| 步骤 | 从 | 到 | 做了什么 |
|---|---|---|---|
| 1 | 5.56TB | 1.56TB | 专家权重按MXFP4存,不反量化 |
| 2 | 1.56TB | 113GB | 只算top-16,专家按需读 |
| 3 | 113GB | 8.24GB | 主干93层打包成trunk.bin,按层流式 |
| 4 | 8.24GB | 26.5s/token | 内存只影响速度,不影响输出 |
拆开看一个token在干什么,会更清楚这四步是怎么落到代码里的:
-
先查词表,把token变成向量。这张表11.7亿参数,每个token都用,必须常驻;
-
然后过93层。到了第L层,就按固定偏移去trunk.bin里读这一层(约1.17GB),算完就扔;
-
每层的MoE要选16个专家。选完去checkpoint里读这16个(每个17.55MB),算完还回去;
-
最后过lm_head,又是11.7亿参数,同样常驻。
这四步加起来134.6GB。技术报告的官方口径是每Token激活104B参数,两个数看着对不上——因为主干按bf16存(每参数2字节),只有专家是MXFP4(0.53字节)。参数账和字节账要分开算,混着算就会得出”装得下”的错误结论。
常驻的部分加起来4.7GB——embed和lm_head各占一半。为什么它们不能流式?因为它们是”每个token的第一跳和最后一跳”,读它的时候没有别的事情可以重叠,读它就是在等。而中间那93层不一样,第L层在算的时候,第L+1层可以同时在读。
到第三步,内存的语义彻底变了:它不再是”模型能不能装下”的门槛,而是”每次少读多少盘”的缓存。同一份模型,8GB和224GB跑出来的每一个token,ID逐个相同,只有时钟不一样。
这一点是整篇文章里最值得记住的:把容量问题转成带宽问题,模型就可以在任何机器上跑,只是快慢不同。这个转换不是免费的,它要求引擎对”读的顺序”有完全的控制权——这就是为什么它必须用C重写,而不是在PyTorch里写个DataLoader。框架的显存分配器、算子调度、张量生命周期,都不允许你在”这一层的字节什么时候进内存”这个粒度上做决定。
图3|两条流各自独立:主干按层读、专家按路由读。主干108.8GB按固定顺序流式,专家1.45TB按路由随机读。前者可预测,所以能预取;后者不可预测,所以只能缓存。两条流的失败模式完全不同,调优也必须分开做——这正是下一节两个不同结论的来源。
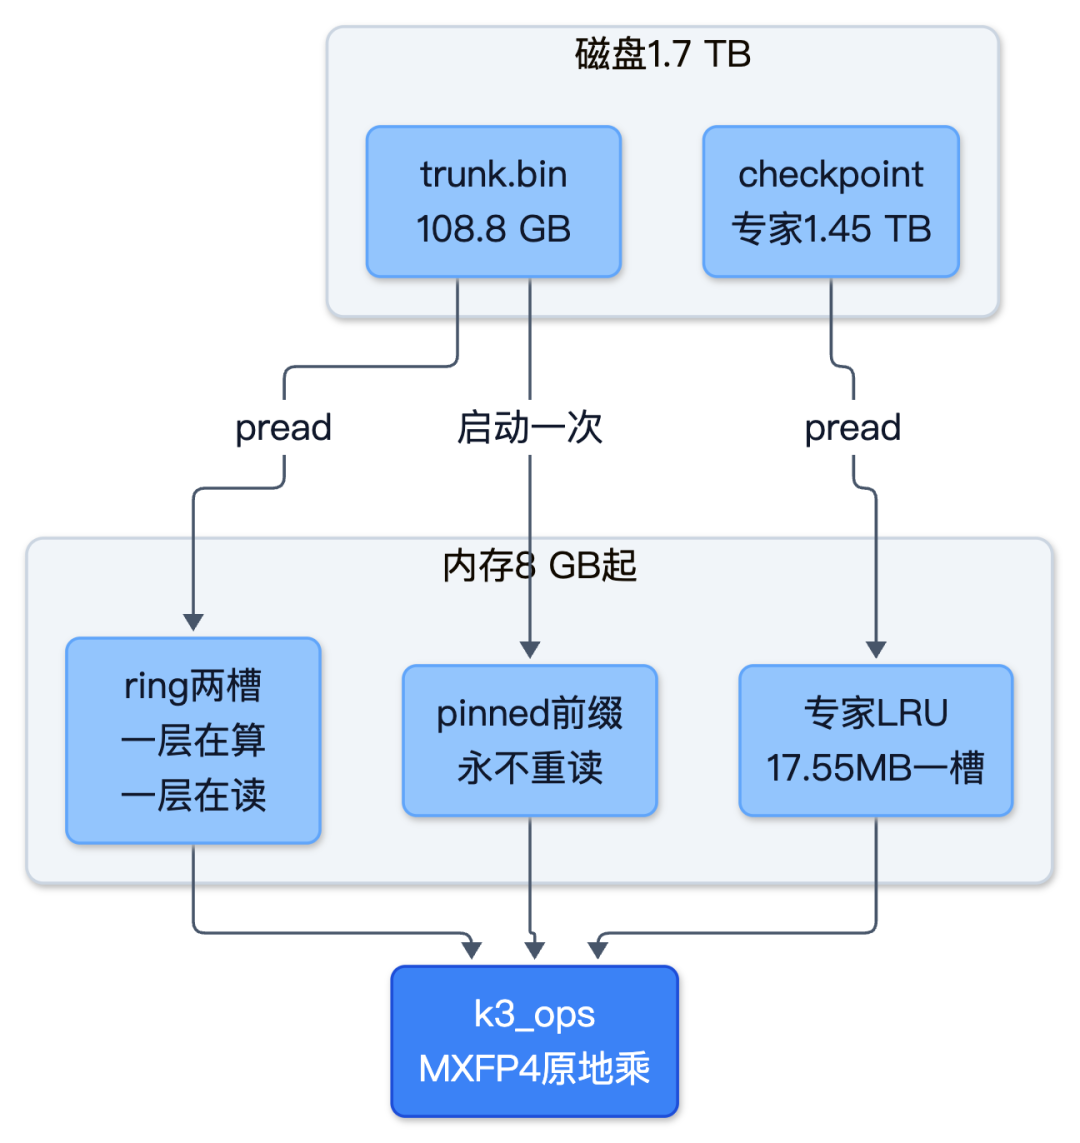
图3
三、四个决定,四种可迁移的手法
3.1 专家权重不反量化,直接从4bit算
一个路由专家3303万参数,反量化成fp32是132MB;一个token要碰1472个专家(92层乘16),光”展宽”就是194GB的纯流量。所以引擎压根不反量化:MXFP4的编码是每32个元素共享一个8bit指数,每个元素4bit,平均0.53125字节/权重。
对比一下:fp32是4字节,bf16是2字节,它是0.53字节——同样的权重,读的字节少了7.5倍。
/* OCP MX E2M1:4bit码直接查表,第3位是符号 */
static const float K3_E2M1[16] = {
    0.0f, 0.5f, 1.0f, 1.5f, 2.0f, 3.0f, 4.0f, 6.0f,
   -0.0f,-0.5f,-1.0f,-1.5f,-2.0f,-3.0f,-4.0f,-6.0f
};
/* 一个字节拆成两个值:内循环一次读8字节=16个权重 */
K3_E2M1_PAIR[b][0] = K3_E2M1[b & 0x0F];  /* 低半字节=偶 */
K3_E2M1_PAIR[b][1] = K3_E2M1[b >> 4];    /* 高半字节=奇 */
这段代码背后有个反直觉的结论:不反量化不只是省内存,它更快。矩阵向量乘本来就是带宽瓶颈,读的字节少7.5倍,等数据的时间就少7.5倍,计算量一点没变。作者的论证是纯字节账而不是跑分——本机单线程跑出MXFP4 13.6GFLOP/s、bf16 18.1GFLOP/s,但这两个数不能互相比,它们是两种精度的峰值,不是同一条路径的前后对比。
代价是精度契约变了。这个内核故意不和”先反量化再乘”逐位相同:它把指数折进权重、把一行拆成十六个独立累加器并行求和。但每个乘积在double下是精确的(3位尾数乘24位尾数,只用掉53位里的27位),重结合只动1个ULP,而测试门槛是1e-6——余量有九个数量级。
可迁移的一点:当精度契约被明明白白写出来——“我不逐位等于谁、但我保证差多少”——优化才敢放手做。含糊的”应该差不多”,最后一定会在某个版本里变成错。
3.2 主干打包:把”随机读”变成”可预取”
93层稠密权重在官方checkpoint里是散的。作者写了个脚本,用93次区间拷贝把它们拼成一个109GB的trunk.bin,第L层落在已知偏移上——此后加载一层就是一次pread,不用解析。
真正关键的不是打包,是顺序:93层每个token都按同一顺序走一遍,预取永远不会猜错。给定内存预算,层不是被LRU轮转,而是被钉住:循环扫描会把LRU打成0%命中,钉住前缀才是对的。
钉住多少层,命中率就是多少。48层钉住、93层总量,命中率就是51.6%——一个可以直接验算的式子,不需要跑模型就能知道自己这台机器的理论命中率。这就是”计数优于秒表”:命中率是计数,不受调度抖动影响。
还有一个细节值得抄:单条顺序pread把NVMe留在队列深度1(发一个、等一个),实测只有3.1GB/s,不到盘标称速率的一半;本来就在并行读的专家路径能到6.7GB/s。于是作者把一层切成64MB的对齐块,用OpenMP并发发出去,把深度补回来。
/* 一层约1.17GB;单条顺序pread只到盘的一半速率 */
const int nchunk = (nb + K3_TRUNK_CHUNK - 1)
                 / K3_TRUNK_CHUNK;
#pragma omp parallel for schedule(dynamic, 1)
for (int ci = 0; ci < nchunk; ci++) {
    int64_t base = ci * K3_TRUNK_CHUNK;
    int64_t rest = nb - base;
    int64_t len  = rest < K3_TRUNK_CHUNK ? rest
                                        : K3_TRUNK_CHUNK;
    pread(tr->fd, dst + base, len,
          lay->file_off + base);
}可迁移的一点:磁盘喜欢”深队列”,不喜欢”大请求”。这不是SSD的怪癖,是所有块设备的共性——把一个大读切成多个并发的小读,往往比换更快的盘更有效,而且不花钱。
3.3 KDA与MLA:让每token的状态与上下文长度无关
K3的93层里,69层是线性注意力KDA,24层是Gated MLA(第4、8、…、92层,加第93层收尾)。
图4|93层的排列:三浅一深,每12层一个残差边界。第0层是唯一没有MoE的dense层;第1–92层按KDA三次、MLA一次的节奏循环;第93层用MLA收尾。每12层落一个AttnRes快照,残差不再是一条线累加。
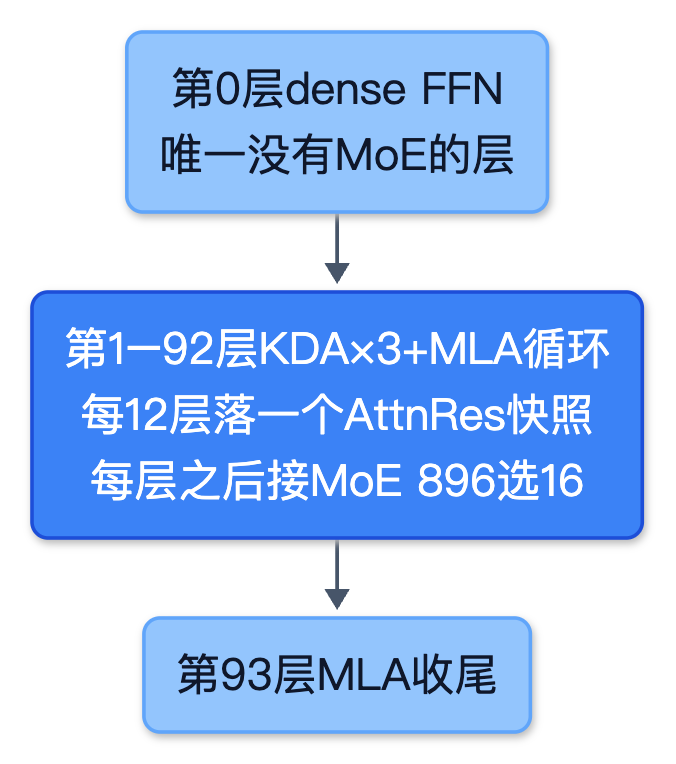
图4
KDA的状态是每头一个128×128的矩阵,与序列长度无关:读到第1000个token和第10个token,状态大小一样。整套递归状态加起来626MB,这也是它敢常驻的原因——不管喂多长的上下文,这个数字都不变。相比之下,MLA每层每个position要缓存2.37MB的展开K/V——真正贵的不是KDA,是那24层MLA。
按这个数算,32000个token的KV就是75GB(我的推算)。反过来看,这也解释了为什么这个引擎在长上下文上没什么可吹的:它省的是权重流量,不是KV流量。KV是随上下文线性增长的,权重是固定的。两者优化手段完全不同,市面上很多”长上下文优化”的文章把这两笔账混着算,结论就会失真。
图5|KDA一步的四个动作,③必须在②之后、④之前。先衰减、再用旧状态读出、再写增量、最后用新状态读输出。顺序反了不会崩,只会静默错。
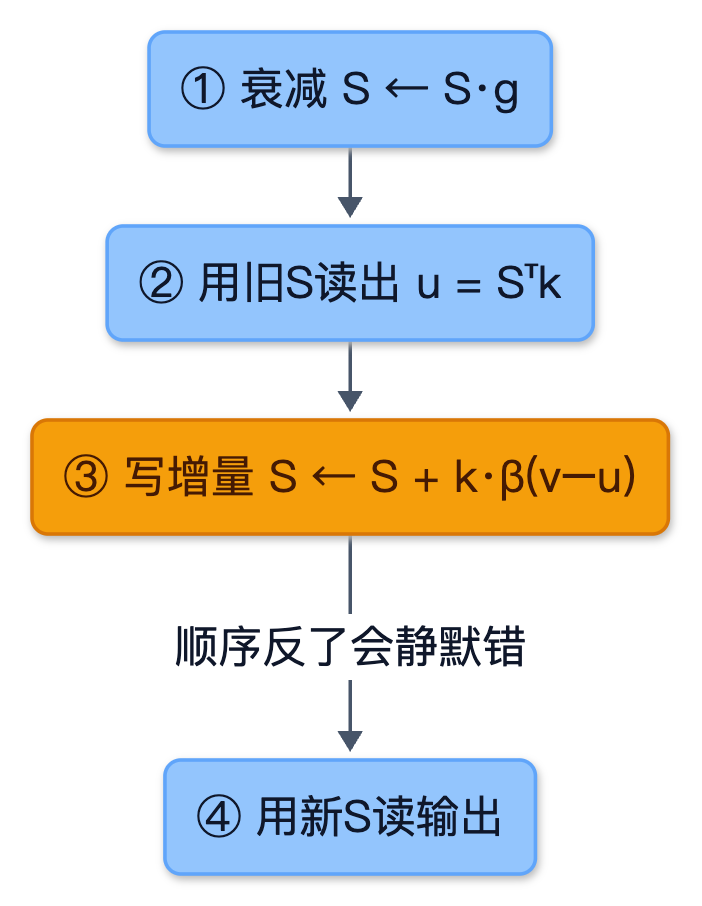
图5
这个”静默错”是全文出现最多的坑:错误实现的输出依然通顺。所以作者给每个模块都准备了一个”错误实现也能通过”的对抗夹具:
-
A_log用linspace排布——按通道误索引会把每个元素都挪位,肉眼看不出来;
-
router夹具让bias在六行里改写五行的top-k,选错专家只看一行是不够的;
-
MLA夹具断言softmax用的是完整head宽度,漏掉rope的64维会静默改变缩放。
测试不是证明写对了,是证明写错了一定会被抓到。这两种测试的写法完全不同:前者只需要一个正确的输入,后者需要专门构造一个”错误实现也会通过”的输入。
3.4 专家缓存基本没用,所以”给谁内存”比”给多少”重要
按直觉,896个专家16个一组,总该有点热子集可以缓存。实测:从28槽加到1344槽(48倍容量),命中率恒为0.0%,每个token照旧读25.83GB。
原因是K3的路由训练用了Quantile Balancing,故意把专家使用率摊平了。10万次专家请求里出现了10010个不同的专家(12.1%),compulsory miss决定了上限——90%的命中率只在192GB以上才出现,那时候模型已经全装下了,缓存也就没意义了。
于是调优结论反直觉但可推导:给主干1GB,确定省1.17GB/token;给专家缓存1GB,在36GB以下省0。同样128GB预算,把”专家优先”改成”主干优先”,端到端从28.6秒降到16.8秒;反过来,224GB配得烂(19.2秒)还打不过128GB配得好。
作者对这个倍数的处理值得单独记一笔:十二个点、单样本、噪声地板33%,所以他不主张”1.69倍”,只主张方向——两个独立预算下Spearman秩相关分别是−0.886和−0.714,加上机制推导。方向硬,数字软,说清楚。
可迁移的一点:缓存命中率不是靠加大缓存刷出来的,它由访问分布决定。先量分布,再定分配——顺序反了,就是在为不存在的热点付钱。
四、动手:没有权重也能验到”逐位相等”
这一章的命令我都实际跑过。环境是macOS 15.7.4、Apple Silicon、24GB内存、Apple clang 17,没有libomp,所以是单线程构建;Linux上直接make即可。
4.1 构建与测试
# 本机github.com不通,代码走jsDelivr拉取并校验
python3 fetch_repo.py
cd repo
# 无OpenMP时可关掉,其余与官方一致
make -j8 CC=/usr/bin/clang OMP_CFLAGS= OMP_LDFLAGS= \
LDFLAGS="-lm -pthread"我这里的结果:构建1.82秒,make test7.67秒,173条PASS。
判据不是”没报错”,是三行具体的输出:
| 判据 | 通过的样子 | 不通过时 |
|---|---|---|
| 退出码 | 0 |
make通用行为下为2;先别改代码,先定位哪一节FAIL |
| 末行 | ALL WEIGHTLESS TESTS PASSED |
逐字匹配,不接受”差不多” |
| oracle门 | GATE 1 到GATE 3b都是exact |
32/32、20/20、20/20,外加两个PASS |
这五道门各自在验什么,值得说清楚,因为它们的失败模式完全不同:
-
GATE 1 teacher forcing:给定真实前缀,每个位置的logits都要和参考实现一致。它验的是前向算得对不对。
-
GATE 1b状态复用:同一段前缀算两遍,logits要逐位相同。它验的是”有没有泄漏状态”——单槽ring被预取覆盖这种bug,就是在这里抓到原型的。
-
GATE 2/3贪心解码与增量:生成20个token,和”整段重算”的结果逐位比对。它验的是KV缓存和递归状态在跨token时是否一致。
-
GATE 3b前缀复用:第二轮沿用前22个token的KV与KDA状态,只prefill新增的10个,logits、KV、状态都要和”整段32个重算”逐位相同。它验的是复用状态时会不会串味。
只跑第一个,你会得到一个”前向正确”的引擎;五个都跑,才有一个”能连续生成、还敢复用”的引擎。
图6|要不要相信这套测试,按这个顺序看。先看末行,再看GATE是否exact,最后看有没有NOT RUN——那个NOT RUN不是通过,是”这条没测”。
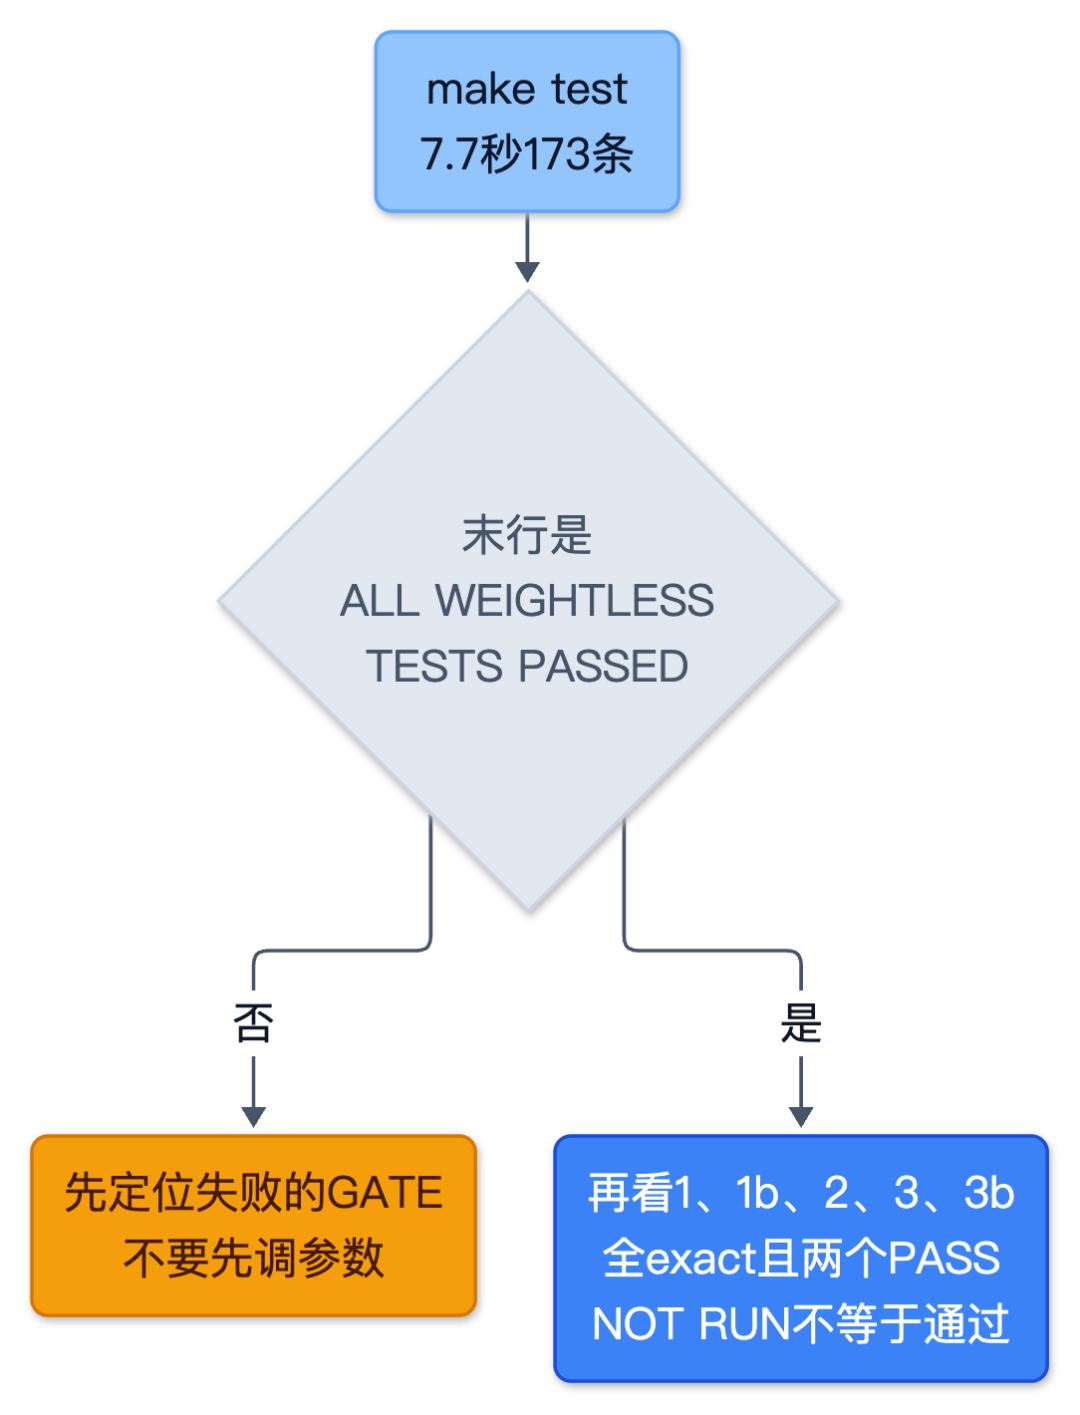
图6
4.2 两个真踩过的坑
坑一:omp.h file not found,装libomp不是唯一解。
-
现象:
fatal error: 'omp.h' file not found,指向k3_run.c。 -
原因:macOS的clang不带OpenMP运行时,而引擎默认按OpenMP编译。
-
正确做法:不想装库就显式传
OMP_CFLAGS= OMP_LDFLAGS=(单线程构建,测试与输出不受影响);要性能就装libomp再传头文件与库路径。注意单线程下跑出来的GFLOP/s不能拿去和作者的多核数字比,我前面引用的两个内核跑分都是单核。
坑二:文件”下载完成”不等于”文件齐全”。
-
现象:拉下来275个文件,
make在深处报No rule to make target 'src/cli/k3_state.c'。 -
原因:CDN的文件清单元数据对刚推送的文件有滞后,清单里少了一批v1.1新增文件,而内容接口本身是新的——所以每个文件都能下,只是少下了一批。
-
正确做法:以tag的清单为准重新对齐(v1.1.0是325个文件),或直接
git clone;下完先核文件数再make。
(还有一个环境干扰:我这台机器的shell里预置了LDFLAGS,Makefile用的是?=,于是-lm -pthread被静默替换掉了。macOS因为libm在libSystem里没报错,Linux上大概率会链接失败——这条是推测,我没实测。)
真要只跑一条,make test里最有价值的其实是GATE 1和GATE 3这一对:前者验单步前向,后者验跨token的状态传递。两个都过,中间那十几条基本是它们的细分;只过一个,说明问题在”状态”而不在”算子”,排查范围立刻小一半。
4.3 不下载1.56TB也能做的两件事
# 复现官方"专家缓存容量"表(需要numpy)
python3 tools/sim_cache.py tests/fixtures/expert_trace.bin

# 内核微基准
make bench && ./bin/bench_kernels前者用仓库自带的10万次专家请求trace,跑出LRU与Belady最优解的对比,我把输出和文档里的表逐格对过,一致;后者给出本机内核吞吐:单线程下MXFP4是13.6GFLOP/s、bf16是18.1GFLOP/s。这两个数不能换算成端到端——按每token约507GFLOP算(我的推算),单线程光算就要三十多秒,而作者那台8线程机器上算是几秒的事。真正的大头是读盘:134.6GB按作者实测的主干吞吐5.4到6.1GB/s,要22到25秒,和26.5秒的实测值对得上。这条比任何解释都能说明:它是I/O问题,不是算力问题。
4.4 环境门槛
| 项目 | 要求 |
|---|---|
| 磁盘 | 约1.7TB空闲,权重与打包主干各占一份 |
| 内存 | 8GB可跑,但只够单请求、短上下文 |
| 编译器 | C99 + libm,OpenMP可选(关掉只是慢) |
| 网络 | 需要HF token,下载以小时计 |
| 权重 | 不下也能跑完全部无权重测试 |
五、边界:哪些话能说,哪些不能说
先说结论:“8GB跑2.78万亿参数”这句话,字面是假的,机制是真的。差的三个前提必须补上。
第一,权重在磁盘上。 那1.56TB的checkpoint加109GB的打包主干,门票是约1.7TB的空闲磁盘,还得有HF token才能下载。内存里的8.24GB是”这一次运行的工作集”,不是模型本身。说”装进8GB”和说”在8GB里跑起来”,差的是同一句话里最重要的动词。
第二,速度是半分钟一个token。26.5秒(8GB档)、19.8秒(64GB档)、5.6秒(128GB以上)。作者自己写得很直白:“我从没打算让它服务任何人。“仓库里还有一份更硬的证据:Jetson Orin Nano Super上单token跑通,峰值内存2.57GiB,四轮token与logits的SHA-256完全一致,但每轮949秒——主干走内置NVMe,专家走外置机械盘。这份数据比8GB那台更有说服力,因为它是四轮重复且哈希相同的。
第三,数字要分级看。
| 层级 | 例子 | 可信度 |
|---|---|---|
| 计数与字节 | 12档内存输出逐个相同、每token恒读25.83GB、48倍缓存0命中 | 硬,不受调度影响 |
| 秒表 | 26.5/19.8/5.6秒、1.69倍、5.4%大页收益 | 软,同配置三次实测spread达33%,作者自己把整页标成”单样本” |
| 单样本推断 | 主干优先相对专家优先的1.69倍 | 方向可信(秩相关−0.886/−0.714),倍数不要引用 |
功能缺口也要说清楚:
-
没有chunked prefill。21000 token的prompt是一次性的二次复杂度前向,基本跑不完。这意味着它只能在”短问题”上用,而短问题恰恰是最不需要2.78万亿参数的场景——这是个真实的产品错配,作者自己也没回避。
-
没有GPU。如果哪天有卡,这套流式设计的大部分收益会立刻消失,因为HBM带宽是NVMe的几十倍。
-
没有质量评测。仓库测的是引擎是否等价于参考实现,不是K3本身好不好用。想看能力,得去官方评测。
-
批次只支持贪心。这不是偷懒:贪心才能保证跨内存档位逐位一致,采样会让”同一份输出”这句话失效。
如果要在自己项目里复用这套思路,还缺三块:一是chunked prefill,把长prompt切成可流式的段,否则长上下文的门槛永远过不去;二是KV的分页与换出,权重既然能流式,KV按理也能;三是采样与批处理,现在的贪心是为了可验证,真要用得补上温度和批。这三块本身都不难,难的是它们每一个都会削弱”逐位相同”这个性质——所以作者是选择不做,而不是做不好——这两件事在README里是分开写的。
还有一处口径要对齐:176KB是v1.0在Linux上的数字。到v1.1加了chat、sampler、状态管理,源码变成十个C文件;我在macOS arm64构建的__text是195KB、文件328KB。量级结论不变,但引用时得带平台和版本。
六、这个项目真正教了什么
如果只记一句话:把”跑得动”拆成”哪些字节必须常驻”,是这类超大模型在消费级硬件上唯一的出路。
再记三句可操作的:
-
先量分布,再定分配——专家缓存48倍容量0命中,说明”给多少”之前必须先回答”给谁”。这个顺序反了,就是在为不存在的热点付钱。
-
把精度契约写出来——“我不逐位等于谁、但我保证差在1e-16量级、门槛卡在1e-6”,是优化敢放手的前提。写不出这句话,说明你还没想清楚这个内核在数学上做了什么。
-
测试要能测出错误实现——每写一个夹具就问一句”如果这里写错了,这条测试会红吗”,不会红的测试就删掉。作者那句复盘值得抄下来:夹具只能证明某个安排被处理了,只有枚举能证明没有漏掉的安排。
至于它慢:半分钟一个token,确实是给人看的,不是给服务用的。但它证明了一件事——同一份权重,从2.57GiB的Jetson到128GB的工作站,输出逐字节相同。这个性质比速度值钱,因为它是可验证的。
参考
-
仓库:
github.com/FareedKhan-dev/kimi-k3-in-c,Apache-2.0,v1.1.0 -
结构与内核:
src/core/k3_ops.c、src/io/k3_trunk.c、docs/ARCHITECTURE.md -
性能与测量:
docs/PERFORMANCE.md、docs/data/(内存阶梯、Jetson四轮原始结果) -
被否决的方案:
docs/notes/compressed-trunk.md、docs/notes/int8-draft-container.md -
本地复现记录:
kimi-k3-in-c-research/build.log、test-run.log -
模型报告:Kimi Team,《Kimi K3: Open Frontier Intelligence》,arXiv:2607.24653
写到这儿,回到那个最容易被跳过的问题:这个”8GB”到底能拿来干什么?我的答案是——它不是给你跑生产推理的,它是给你在没有H100的时候,把一个新模型的结构、权重、数值路径完整走一遍的。你最近一次为了”看清楚一个模型”而重写推理路径,是什么时候?
我是 Aaron,10 年算法工程经验,每周拆一个 AI 新东西的实现细节。 关注「AI 拆解猿」,每周拆一个 AI 协议、框架、源码或架构,直到你能自己动手。
