你用 API 调用大模型时,有一个问题从来没人能回答:服务商说这次回复是 Llama 4 Maverick 算的,你凭什么信?
Anthropic 开源的 FlashProve 给了一个密码学答案:服务商不交出 410GB 权重,也能为每次回复生成一份 18.78MB 的证明,任何人在普通 CPU 上 21 秒独立验证完。这是公开工作里,可验证推理(verifiable inference)规模最大的一档——400B MoE(混合专家模型:4000 亿总参数,每个 token 只激活其中约 170 亿)。
代价同样硬:证明算力约是 vLLM 的 93 倍。
读完这篇你能拿到:
-
可验证推理的三阶段协议,以及撑起它的 5 个核心机制(带公式与伪代码)
-
四条可执行的复现路线:纯 CPU 2 分钟、8 层模型 29 分钟、全尺寸 42 分钟、真 Maverick 数小时
-
5个真实踩坑点,全部来自仓库文档与Issue
-
一个关键判断:它证明的是”权重一致性”,不是”模型身份”
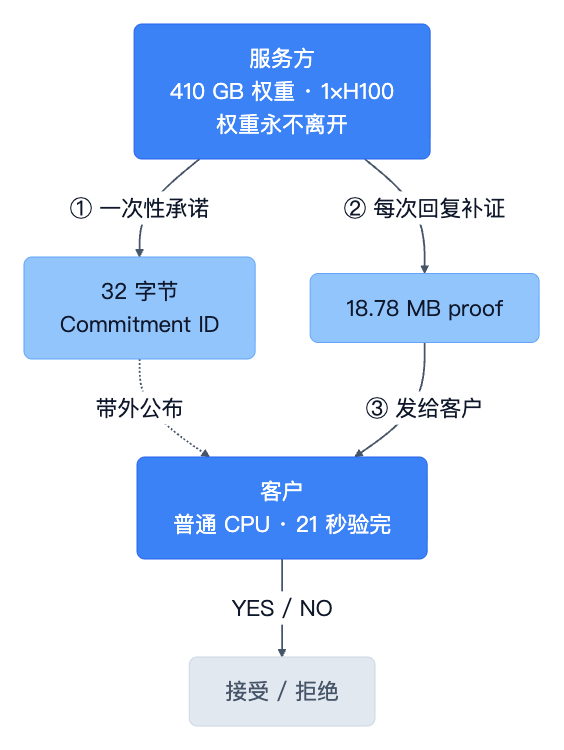
图 1
图 1|一句话架构:一次承诺、逐次证明、CPU 免权重验证。整篇文章都在解释这张图里的三个箭头。
一、Why:当服务商说”我用的是 Maverick”
1.1 四种你无法察觉的作弊
MaaS(Model-as-a-Service)的商业模式建立在一个默认前提上:你相信对方用的是它宣称的模型。但这个前提没有任何技术保障。服务方有动机、也有能力做四件事:
-
换模型:用蒸馏过的小模型顶替大模型,成本降一个数量级,你只看输出质量很难分辨
-
降级:对低价客户、可疑流量、高峰期切到小模型
-
改输出:加规则改写、内容过滤,再返回给你
-
事后抵赖:日志在对方手里,出纠纷时无法作为第三方证据
监管侧要审计,商业侧要按模型计费、要授权合规,两边都需要同一个东西:一份能被第三方独立检查、又不暴露权重的证据。
这个需求听起来简单,做起来极难——因为证据和秘密天然冲突。
1.2 五种”看起来能用”的方案,为什么都不行
| 方案 | 做法 | 为什么不够 |
|---|---|---|
| 权重哈希 | 公布权重的 SHA-256 | 只证明”文件是这份”,不证明”这次推理用了它”。换模型后重新哈希即可 |
| TEE / 机密计算 | 在 enclave 里推理并出 attestation | 要信任 CPU/GPU 厂商与固件;有侧信道;400B 模型根本放不进 enclave |
| 水印 | 输出里嵌统计信号 | 概率性、可被改写洗掉;只能事后取证,无法逐次验证 |
| 抽样重跑 | 审计方拿权重重算 | 需要权重;只能抽查;无法证明”某一次” |
| zkML / zkLLM | 为整次推理生成 zkSNARK | 证明开销随参数量爆炸,公开工作多停在 10M–1B 参数;proof 虽小但生成代价无法承受 400B |
FlashProve 的路线是第五种的变体,但换了底层数学——不用椭圆曲线的 zkSNARK,改用哈希型 IOP。这一换决定了后面所有取舍:
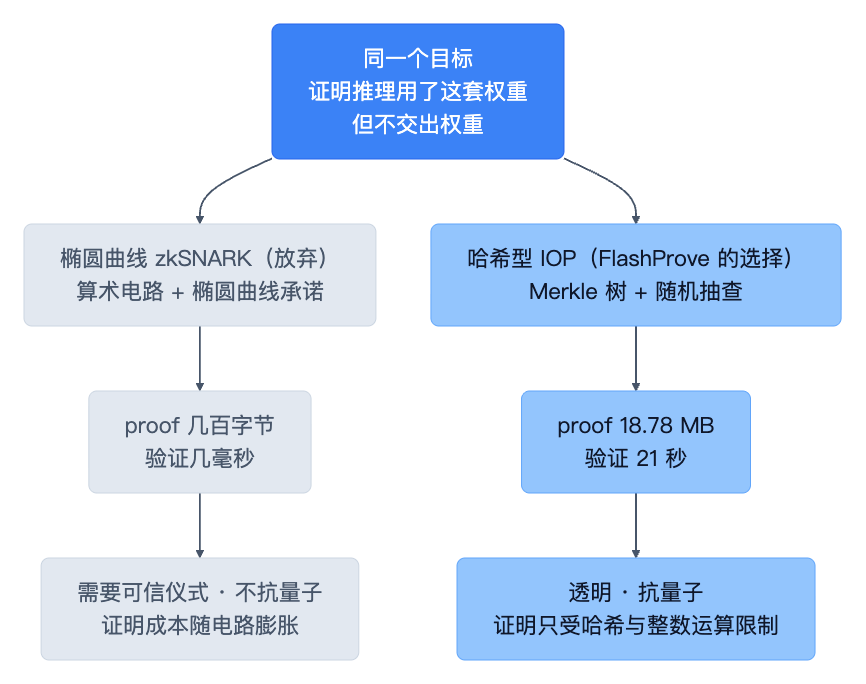
图 2
图 2|两条路线的取舍。zkSNARK(简洁非交互知识论证)把计算摊成算术电路,用椭圆曲线承诺多项式:proof 几百字节、验证几毫秒,但需要可信设置(仪式里留下的秘密,谁保管谁就能伪造证明)、不抗量子、成本随电路规模膨胀。哈希型 IOP(交互式预言机证明)改用 Merkle 树承诺整张表,验证者像抽查作业一样只打开少量位置:proof 涨到 18.78MB、验证 21 秒,换来无需仪式、抗量子、成本只受哈希与整数运算限制。
1.3 真正的矛盾:权重是 IP,证据要公开
把所有方案失效的原因归到一句话:你要证明的东西,恰恰是不能给对方看的东西。
密码学对这个矛盾的标准解法叫承诺(commitment)——把答案装进信封、封口、放桌上:你不能改(binding),但也还没公开(hiding)。
FlashProve 把这个信封做到了 410GB,并且额外解决了两个工程难题:
-
承诺之后,每次推理都要能证明”我用的权重在信封里”
-
证明过程本身不能泄露信封里的内容
前一个是可验证计算问题,后一个是零知识问题。两个都要,且要在单张 H100 上跑 400B 模型。
二、How 宏观:三阶段协议
2.1 一次承诺,逐次证明,随时验证
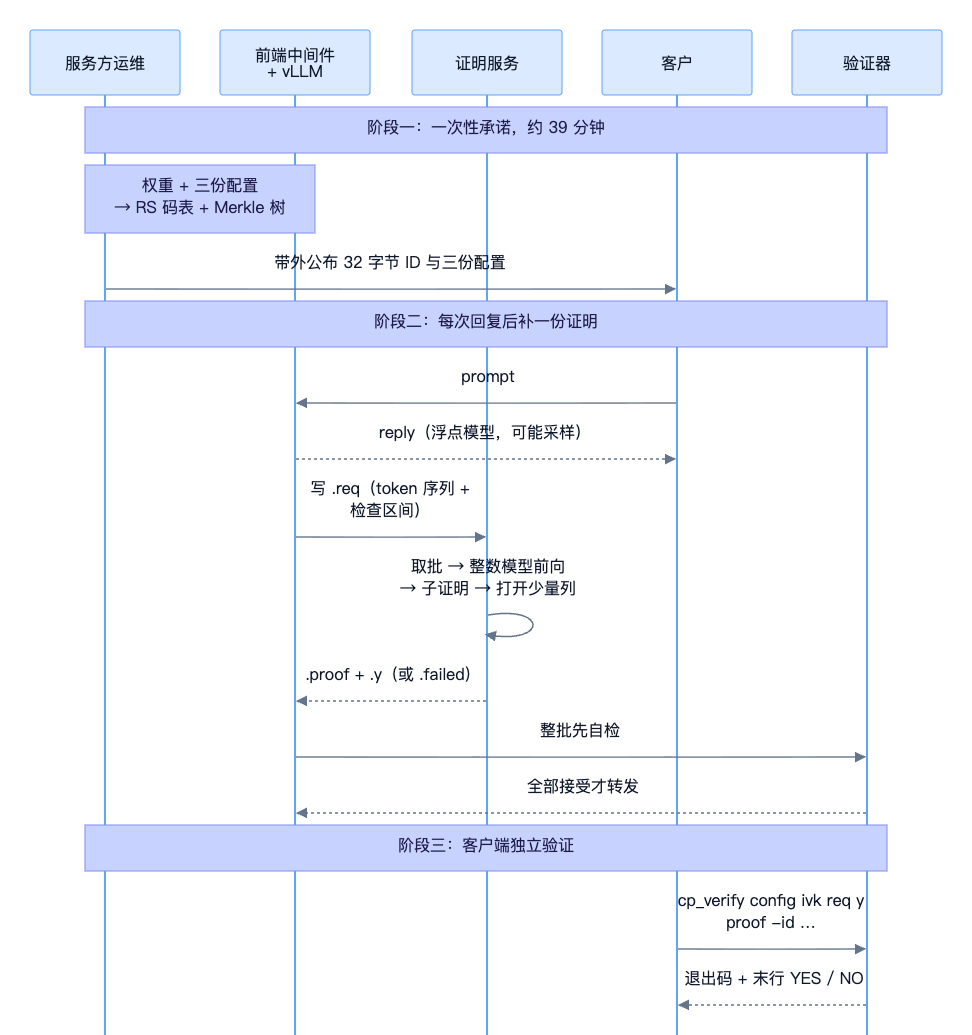
图 3
图 3|全生命周期。特别注意阶段二的顺序:证明是在回复已经生成之后补的,不是推理的一部分。这也解释了为什么它不覆盖采样——证明时只看最终 token 序列。
这三个阶段对应三个程序:cp_commit(承诺)、cp_prove(证明服务)、cp_verify(验证器)。验证器是纯 C++、不依赖 GPU、不需要权重,这是整个设计的价值所在。
2.2 32 字节里装了什么
Commitment ID 是 32 字节哈希,覆盖:
-
三份配置文件(
policy.txt、KL.bin、layout.txt) -
anchor 表的 Merkle 根与形状(anchor 是承诺树的顶层块,用来算 ID 指纹;leaf 是最末级块,每次证明打开的就是它)
-
OOD 采样的 seeds 与 answers
它不覆盖 leaf 文件与 key.bin 内部的子证明——那两项由 cp_verify 读取时单独检查。这个细节后面讲局限时会再出现。
关键点:ID 是带外使用的。你从官网、合同、独立渠道拿到它,硬编码进客户端,而不是从待检查的服务器上拉取。
仓库文档里有一句警告值得抄下来:永远不要把别人发给你的文件算出来的 ID 当作
-id传入。它与那些文件天然匹配,证明不了任何来源。
2.3 三类文件:哪些必须信,哪些必须查
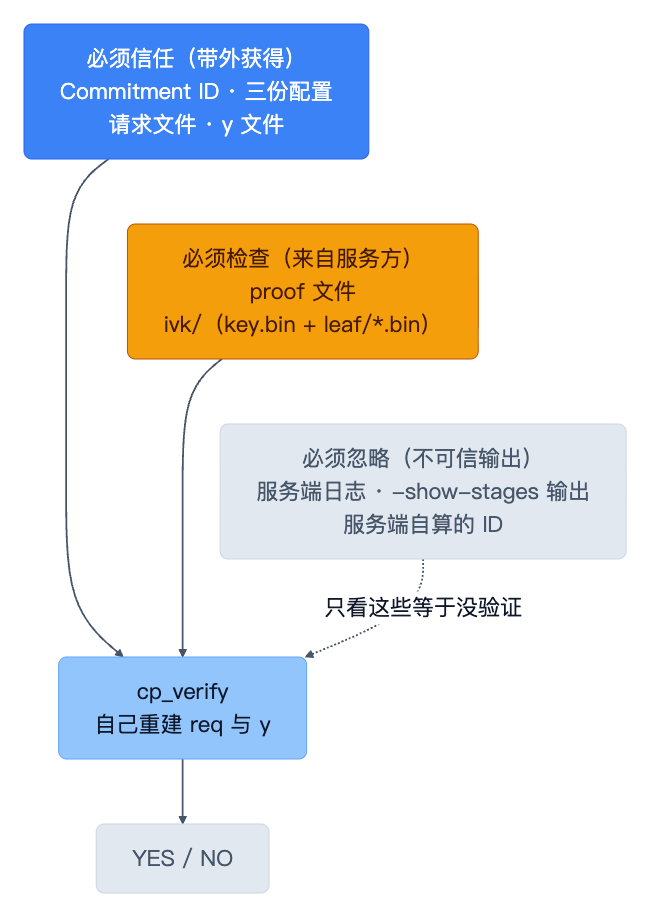
图 4
图 4|信任边界。搞错这张图,后面所有密码学都白搭——验证器的可靠性只在你喂给它正确的公开文件时才有意义。
2.4 为什么它敢上 400B:三个反直觉的决定
| 决定 | 直觉做法 | FlashProve 的做法 | 换来了什么 |
|---|---|---|---|
| 算术 | 证明浮点前向 | 改成整数模型(定点激活 + 查表非线性) | 可精确复现、可代数验证;代价是 top-1 差异 6.81% |
| 验证方式 | 全量重算 | 抽查 (只打开表中少量列) | 410GB 只需打开约 10GB;代价是概率性保证 |
| 权重可见性 | 证明时公开权重 | 掩码隐藏 (RS 码随机尾巴) | 权重始终不出服务方;代价是每请求 1 bit 泄漏预算 |
这三个决定互相牵制:不改成整数模型就没法抽查;不抽查就压不到 MB 级 proof;不加掩码,抽查就等于泄露权重。
三、How 微观:五个核心机制
3.1 机制一:把浮点模型变成整数模型
先定义两个后文反复出现的词。top-1:模型在每个位置给所有候选 token 打分,分数最高的那个就是 top-1;全文说“某个 token 是对的”,意思都是“整数模型在这个位置也选了它”。logit:softmax 归一化之前的原始分数,可以理解成“还没换算成概率的投票数”。
为什么非改不可?浮点加法不满足结合律,舍入规则还依赖硬件。同一段代码在不同 GPU、不同编译器下可能给出不同结果,而可验证计算要求”每一步都能精确复现”。
所以 FlashProve 定义了一个整数版 Llama 4 Maverick,写在 docs/model.md 里,用两个程序实现(Python 参考实现 + GPU 证明器),Lean 里还有第三份。
核心是三个替换:
① 量化权重 + 定点激活。 权重是整数(除 embedding 外落在 −4096..4095),激活用”整数 + 2 的幂尺度”表示。每次乘法之后右移若干位做舍入,舍入规则固定:
rq(a, k) = floor((a + 2^(k-1)) / 2^k) // 除以 2^k,四舍五入,.5 向上一行公式解决”浮点舍入不可复现”的问题:所有运算都是整数,谁都算得出同一个结果。
② 非线性函数全部查表。 GELU、SiLU、softmax 的 exp 都预先算成整数表,前向时只做查表。这是把”不可代数化的操作”变成”可验证的组合问题”的关键。
③ 8 类 range condition。 整数运算必须防溢出。模型被定义成一个部分函数:8 类数值只要有一类越界,模型就没有输出,证明也不成立。
以 RMSNorm 为例,整数版长这样:
Vx    = sum(x[k]^2)
sigma = isqrt(Vx + eps)                       // 整数平方根
Rc    = floor((2^M + floor(sigma/2)) / sigma) // 定点倒数
w[k]  = rq(x[k] * Rc, K)                      // 缩放 + 舍入
nr[k] = clamp(w[k]; 2047)                     // 12 位有符号钳位
没有一处浮点。注意 isqrt 和 floor 都是精确定义的整数操作——这是”可证明”的前提。
代价必须说清楚:整数模型不是浮点模型。仓库实测 top-1 一致率差异 6.81%,logit(每步的原始分数)RMSE 0.035,余弦相似度 0.9954。也就是说,它证明的是”整数模型会给这些 token”,不是你线上那个 BF16 模型会给这些 token。
3.2 机制二:承诺与抽查,410GB 只打开 10GB
问题:怎么在不读完 410GB 的前提下,确认”这份数据整体上没被换过”?
答案:Reed-Solomon 编码 + Merkle 树 + 邻近性测试。三步走。
第一步,加冗余。 把权重按列看成一个多项式在若干点上的取值,再在更多点上求值,得到更长的码字。直觉是:把一句话改写成一首押韵的长诗,改一个字整首诗就不押韵了。任意两个合法码字至少在 n − k + 1 个位置不同——这个数量叫最小距离,冗余越大,距离越远。
第二步,做承诺。 每个叶子 = 一列数据 + 一个随机盐,向上两两哈希成 Merkle 树,根进入 Commitment ID。想验证某一列没被换,只需给出一条从叶子到根的哈希路径(约 log₂n 个哈希),不用给整张表。
第三步,抽查。 验证器随机打开少量列,检查:
-
打开的值确实在承诺的 Merkle 树里(路径校验)
-
这些值满足该满足的代数关系(sumcheck 等)
抽查点的数量决定了安全性:点越多越安全,proof 越大。18.78MB 的 proof 里,Merkle 路径占了 15.84MB(84%)——这就是”抽查”的账单。
一个容易翻车的细节:抽查只能保证”数据接近某个合法码字”,不能保证”接近唯一那个”。当数据落在 list decoding 区域时,可能有多个候选码字,攻击者可以挑一个对自己有利的来解释。
这就是 OOD 采样(out-of-domain)存在的原因:在码的”编码点集之外”再问几个点。真正持有低次多项式的证明者答得出,拼凑假数据的答不出。这些 seeds 与 answers 都被写进 Commitment ID,防止事后挑选。
而把 410GB 的检查压到 18.78MB,靠的是邻近性测试的递归结构:
fold(折叠) 是其中的核心动作:把码字按奇偶位置拆成两半,再用一个随机系数把两半线性组合成一个新的、长度减半的码字——一列数据变两列、查一次相当于查两处。反复折叠,规模指数下降;但每折一次码的参数就变了,所以要靠 code switching 换到同族的另一个码上,保证”折完的东西仍然落在可检查的码族里”。折到常数规模后,验证者只需要检查最后那一点点。
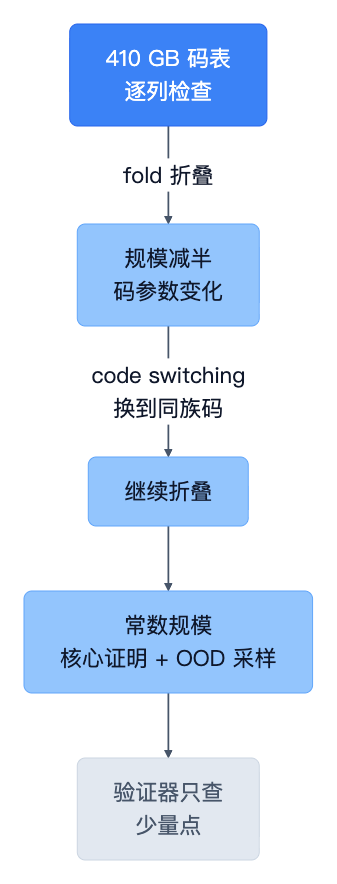
图 5
图 5|邻近性测试的四步。fold 负责缩小规模,code switching 保证折叠后仍在可验证的码族里,OOD 采样负责消除列表解码的歧义。
3.3 机制三:sumcheck,把一百万个点压成一个点
前向计算里有大量形如”这一层的输出等于权重矩阵乘输入”的断言。逐项验证不可能,需要把它变成一条等式。
sumcheck 干的就是这件事:要确认”一百万个数的加权和等于 c”,不用逐个核对;把这一百万个数压成一个多变量多项式,随机取一个点问”这里对不对”。
依据是 Schwartz-Zippel:两个不同的多项式,在随机点上取值相同的概率极小。于是一个关于大量坐标的断言,被归约成关于单个随机点的断言。
sumcheck 跑完之后,剩下的通常是形如 sum_i a_i · f(i) = c 的线性声明,再归约成对承诺表若干 opening 的检查——这里的 opening 就是“打开”:给出某个位置的值,外加一条 Merkle 路径证明它确实在表里。验证者只需要这些点和路径,不用读整张表。
另外两个工具补剩下的缺口。 sumcheck 只能处理加减乘;模型里的钳位、指数、除法是非线性的,写不成多项式,于是用 lookup argument:把“输入 → 输出”预先算成一张表,只证明“我用到的每一项都在表里”,比拟合多项式便宜得多。range check 则防溢出——整数模型要求每个中间值落在指定区间,证明“它没越界”比证明“它等于多少”便宜。
整条证明的骨架就是这套动作的叠加:
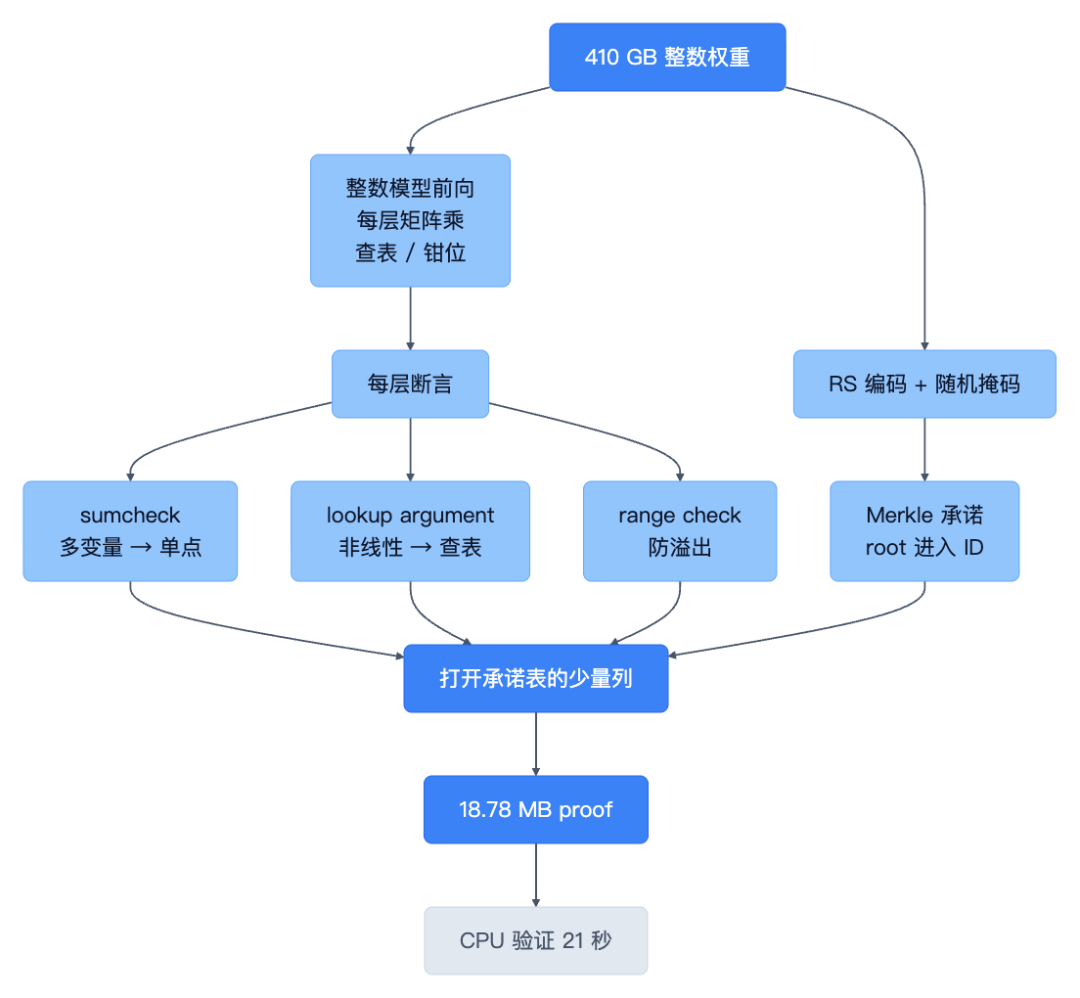
图 6
图 6|从权重到 proof 的完整流水线。左边是数据,中间是”把断言变小”的三个工具,右边是打开的少量列。
3.4 机制四:权重怎么藏,以及”每请求 1 bit”的预算
抽查会打开真实数值。如果打开的是原始权重,那证明一次就等于泄露一部分权重——多证几次权重就被拼出来了。
解法是三重掩码:
| 层 | 做法 | 作用 |
|---|---|---|
| 编码层 | RS 码后追加随机列(随机尾巴) | 让码字本身不含信息 |
| 承诺层 | Merkle 叶子加随机盐 | 防止相同内容产生相同哈希 |
| 计算层 | 每个请求用新随机性重写相关行 | 让不同请求的打开值不可关联 |
掩盖到什么程度?仓库给了精确答案:在 2⁶⁴ 次哈希查询、688,127 次回复的预算内,平均每个请求泄露约 1 bit,验证器所见与模拟器的统计距离小于 2⁻¹⁵⁴。
用人话说:泄露存在,但被压到了”统计上不可区分”的量级。
这里藏着一个致命失效模式:验证器从不检查掩码是否存在。如果硬件故障或代码 bug 让未掩码的值进入了一个”验证通过”的文件,验证器无法察觉——权重就静默泄露了。这是全系统唯一一个”验证通过但仍然泄密”的路径。
3.5 机制五:非交互化,哈希链 + PoW + 三条链
交互式证明需要验证者现场提问。但服务场景里验证者几小时后才上线,得先把证明录下来。
Fiat-Shamir 变换解决这个问题:让哈希函数扮演提问者,挑战 = H(陈述, 承诺, 此前所有消息)。证明者无法预知问题,也就无法针对性造假,整个交互被压成一份静态文件。
为了把”暴力尝试”的成本抬上去,还叠了一层 PoW:20–32 bit,恶意证明者每试一次假陈述要多付 2²⁰–2³² 的计算。
最终一个 proof 里包含三条链:
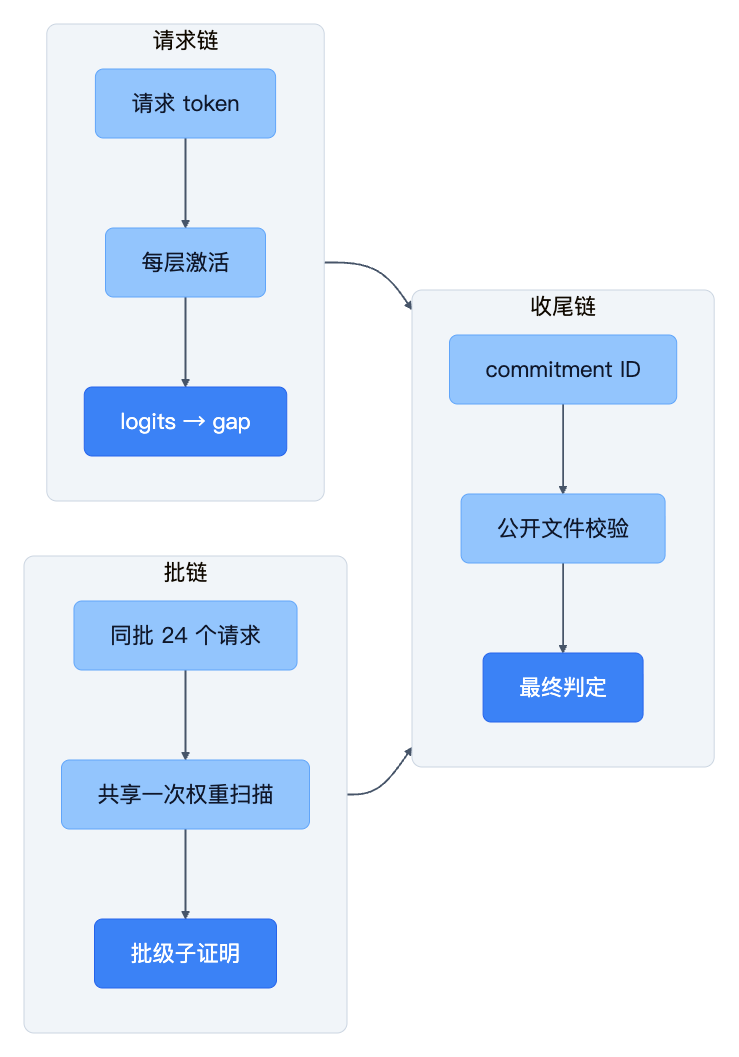
图 7
图 7|三条链。批链是性能的来源(同批共享一次全表扫描),也是安全上最脆弱的地方——64 请求/批在 80GB 卡上会顶到显存上限。
四、Action:手把手跑一遍
先说门槛,免得白折腾:证明侧只支持单张 H100 80GB + CUDA 13.2 Update 2 + x86-64 Linux。没有 H100 也能玩前两条路线——验证器是纯 CPU 的。
这一节不给终端截图:我手上没有 H100 环境,下文所有命令、输出格式与退出码都逐字抄自仓库的 README.md 和 verifier/README.md。P 一张”跑通了”的截图很容易,但那会让这篇文失去唯一的价值——你照着敲,应该得到同样的结果。判断成功与否只看退出码和下面标出的末行关键字,不要凭”看起来跑完了”。
先对着这张图选路线,别一上来就下载 232GB 权重:
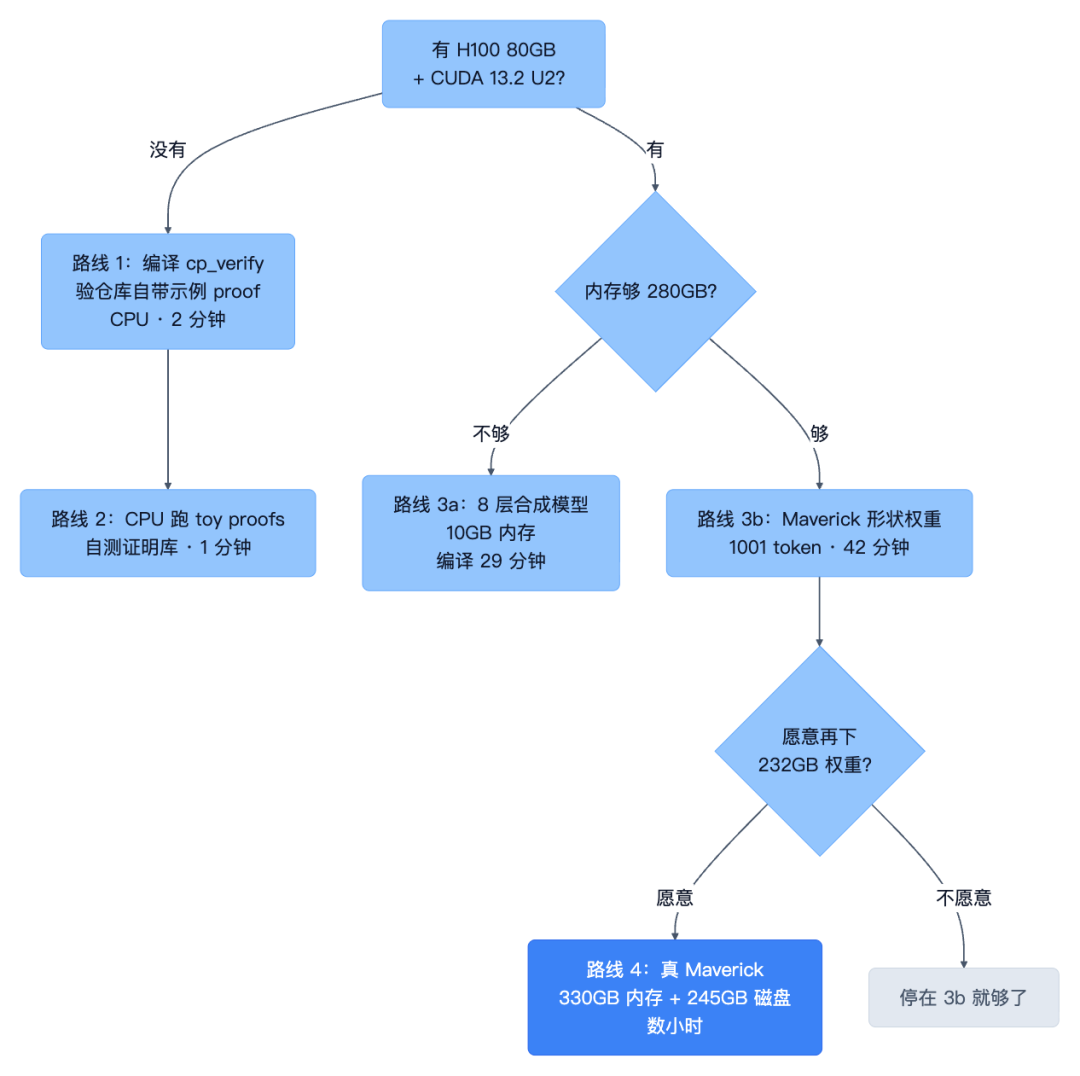
图 8
图 8|四条路线,按你手上的机器选。路线 1、2 只在 CPU 上验证工具链能跑,3a/3b 用合成权重跑通协议实现,只有路线 4 触及真实权重——别拿路线 1 的 YES 当”系统已验证”。
| 路线 | 需要 | 耗时 |
|---|---|---|
| 1 / 2 验证与自测 | Linux + g++ 13+,< 2GB 内存 | 编译 1–2 分钟,验证 < 2 秒 |
| 3a 8 层合成模型 | GPU 栈,10GB 内存 | 编译约 29 分钟,运行 23–30 秒 |
| 3b 全尺寸合成权重 | GPU 栈,280GB 内存 | 约 42 分钟 |
| 4 真 Maverick | GPU 栈 + 330GB 内存 + 245GB 磁盘 | 数小时 |
4.1 路线 1:两分钟验证一份证明
# 从仓库根目录,用普通用户(不要 root / sudo)
verifier/build.sh
# 静默 1–2 分钟,最后一行以 "THE VERIFIER IS BUILT:" 开头,退出码 0
然后用仓库自带的示例 proof 跑一次真实调用:
bin/cp_verify \
  examples/accepted-proof/config \
  examples/accepted-proof/ivk \
  examples/accepted-proof/example.req \
  examples/accepted-proof/example.y \
  examples/accepted-proof/example.proof \
  -id "$(cat examples/accepted-proof/ID.txt)"
期望最后一行是 YES,退出码 0。
这个示例只证明”验证器能工作”——它是小模型 + 合成权重,跟真实 Maverick 没关系。别拿它当”系统已验证”的证据。
4.2 路线 3:在 H100 上证明一个 64-token 请求
examples/quickstart-gpu.sh它会依次编译 cp_verify、cp_commit、cp_prove,然后承诺、证明一个 64-token 请求、再验证。
这条命令可能静默 15 分钟以上(编译 CUDA 很慢),日志写在它自己创建目录下的 quickstart-gpu.log。成功的标志是退出码 0,且出现一行以 quickstart-gpu: all steps ended as expected 开头。
顺手核对一下编译器版本:
grep "Compiled by" quickstart-gpu.log | tail -3
# 每一行都应以 "release 13.2, V13.2.86" 结尾
全尺寸合成权重(不下载真权重,只按 Maverick 的形状造数据):
W=$(mktemp -d) && WORK="$W/example"
prover/examples/run_target_example.sh target_full_f2 "${WORK:?先执行上面那行}"
期望看到 status 0、一行 proof of work:,最后 YES。进度在 $WORK/cp_commit.log。内存不够会在启动时就以退出码 2 结束。
4.3 客户端怎么读结果:退出码比 YES 更重要
bin/cp_verify CONFIG_DIR PUBLIC_KEY_DIR REQUEST_FILE TOKEN_FILE PROOF_FILE -id COMMITMENT_ID| 退出码 | 末行 | 含义 |
|---|---|---|
| 0 | YES / WITHIN LIMITS: … |
精确匹配通过 / 阈值策略通过 |
| 1 | NO: <name> |
拒绝(或本地故障) |
| 5 | NOT CHECKED: <name> |
没有结论。只有 internal-stage / internal-exception-parFor 可重试一次 |
| 14 | NOT-A-VERIFICATION |
调用本身不合法,看 ---- the call ---- 之后的说明 |
| 2, 3, 4, 15 | 命令行或文件有问题、只跑了部分阶段(-key / -leaf)、或只是计划调用(-plan),均无结论 |
两个反直觉点:
-
退出码 0 不等于
YES。WITHIN LIMITS也是 0,但它是阈值策略,保证弱得多。 -
拿到
NO不要试图调试。NO说明证明不成立或文件有问题,唯一正确的动作是拒绝这次回复。
阈值策略要显式传参,且每个值必须与 policy.txt 对应行完全一致:
bin/cp_verify ... -policy clipped-gap,C,THETA,CAP,S,SH4.4 五个真实的坑
坑 1:构建通过,不等于环境对。 三个最容易一起踩的:用 root 构建,bin/ 属主变成 root,之后非 root 构建一律以退出码 2 拒绝;输出目录或它的上级目录允许其他账号写入,脚本直接拒绝构建——否则别人能换掉你即将运行的程序;装了比 13.2 Update 2 更新的 CUDA 照样能构建成功,但这个组合从没被验证过,查日志里每条 Compiled by 是否以 release 13.2, V13.2.86 结尾。
坑 2:批大小拉到 64,显存直接顶满。 文档实测:64 请求/批时显存到 80,629 / 81,559 MiB;用合成权重的 8 次尝试全部没有产出 proof,原因未明。实际按 24 请求/批规划。
坑 3:备份了 isk/,以为能容灾。isk 是服务身份密钥,不可备份、不可复制、不可恢复。它一旦丢失,410GB 的承诺就废了,只能重新跑 39 分钟的 commit,拿到一个与旧 ID 无任何证明关联的新 ID。更要命的是计数器:回退会导致同一掩码用两次,权重可被解出,而且验证器无法检测。
坑 4:把服务器返回的 ID 直接传给 -id。-plan id 和 -show-stages 都会打印”从这些文件算出来的 ID”。它与那些文件天然匹配,传进去必然 YES——但它证明不了任何来源。ID 必须带外获得。
坑 5:拿单请求的耗时去估算线上吞吐。 一次证明 pass 只检查一个 token 位置。prefill 指把 prompt 整体读一遍、算出第一个 token 的阶段,区别于逐 token 生成的 decode。24 请求/批时 prefill 约 110 tok/s,但单请求延迟会被批大小放大:24 个短请求一批,等待约 220 秒。批越大吞吐越高、尾延迟越差,这是个纯工程取舍。
五、它证明了什么,没证明什么
5.1 一个 YES 的四层含义
在 exact match、ID 与 policy 都由客户端自带的前提下,YES 说明:
-
承诺表在代数上”接近”某个由承诺权重构成的合法码字(邻近性测试通过)
-
模型每一步整数运算用到的权重,都能在承诺表中找到对应项(lookup / 线性声明成立)
-
被检查范围内每个 token 都是该整数模型在该位置的 top-1(含 tie 规则)
-
若范围覆盖到窗口末尾,next token 也是 top-1
这四条只关于”权重一致性”。 它们合起来说的是:这套权重确实算出了这些 token。仅此而已。
5.2 七个”证不了”
| 证不了 | 为什么 | 后果 |
|---|---|---|
| 这是 Maverick | provider 自己选权重、自己写配置,ID 只绑定”某套权重” | 可以承诺一个小模型、蒸馏模型,甚至退化模型,然后诚实地证明它 |
| 模型没被”关掉” | KL.bin 的尺度在验证器允许范围内时,可把某些层乃至全部层的贡献舍入为 0 |
一个”全零模型”也能出证;验证器只查数值范围,不查模型是否合理 |
| 和浮点模型一致 | 整数模型是另一个函数 | top-1 差异 6.81% |
| 回复是完整的 | 验证器不知道 end token、不知道 tokenizer | 被截断的回复按更短的回复验证通过 |
| 没有采样 | request 里没有随机种子 | temperature > 0、top-p、beam search 全部无法证明 |
| 是这次请求的新鲜结果 | proof 不含 client、不含时间戳; spool(服务端工作目录)里的 nonce 不进入 proof | 同一份证明可以转发给任何人,也可被反复使用 |
| tokenizer 没被动过 | token 序列到文本的映射不在证明内 | 同一串 token id 可以对应不同文本 |
第一条和第二条最要命。把它们放在一起看:验证器证明”这套权重算出了这些 token”,但”这套权重是什么”完全由 provider 决定。
所以 FlashProve 只在一种场景下有意义:你已经通过带外渠道确认了 ID 对应哪个模型。否则证明再漂亮也是自说自话。
5.3 三层落差:协议、Lean、程序
这是最容易被误读的地方,也是我读完仓库后最想强调的一点。
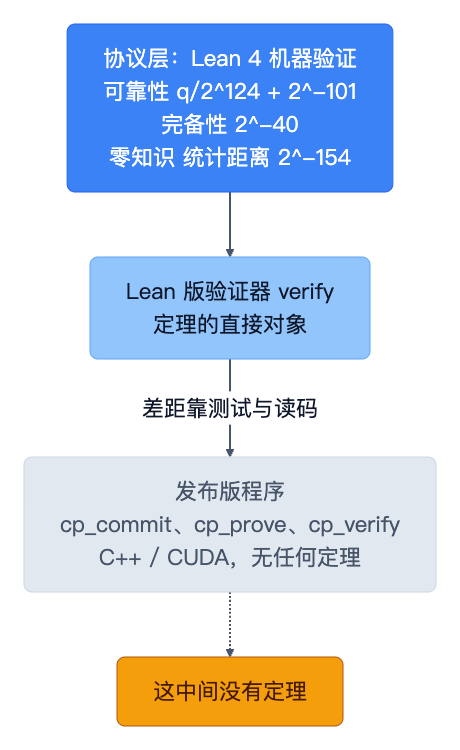
图 9
图 9|三层落差。仓库里 lean/ 有 29,654 个文件,是 C++/CUDA 代码量的 30 倍,全部用来证明第一层。
但第二层到第三层的连接是测试,不是证明。README 里写得很直白:
This is research code. It is tested, not verified: no theorem is about this program, and no security level is claimed for it.
还有几个连带的细节:
-
程序打印的 “128.00 bits” 不是安全等级,是程序自己的误差核算;它默认把 PoW 算进去了,去掉 PoW 后暴力界约 96.23 bit
-
绑定(binding)的书面证明针对的是”ID 不含 OOD seeds”的形式,而程序产生的 ID 含 OOD seeds
-
没有任何独立安全审计;作者自述 AI 写了几乎全部代码、证明与文档
六、局限与思考
6.1 性能账:93× 到底意味着什么
| 指标 | 数值 |
|---|---|
| prefill(24 请求/批) | 约 110–111 tok/s,相对 vLLM 同卡 93.0× |
| 512 路并发 decode | 相对 vLLM 20.1× |
| 验证一份 proof | 21 秒,3.53 GB 内存,单 CPU 线程 |
93× 是每 GPU 的比值。按这个比例线性外推:一台 8 卡 H100 的推理服务,要做到”每个 prompt token 都被证明”,需要约 744 张 H100 等价的证明算力(8 × 93)。
这个数字决定了它现在的定位:不是在线 API 的默认路径,而是抽样审计与争议补证的工具。
一条现实的产品化路径是对高价值请求开启证明:合同金额大的、涉及监管的、客户申诉的。按比例抽证,争议时补证。
6.2 语义账:最强的密码学,最弱的语义
FlashProve 有个结构性尴尬:证明的强度取决于你选哪种验收策略,而两种策略都不理想。
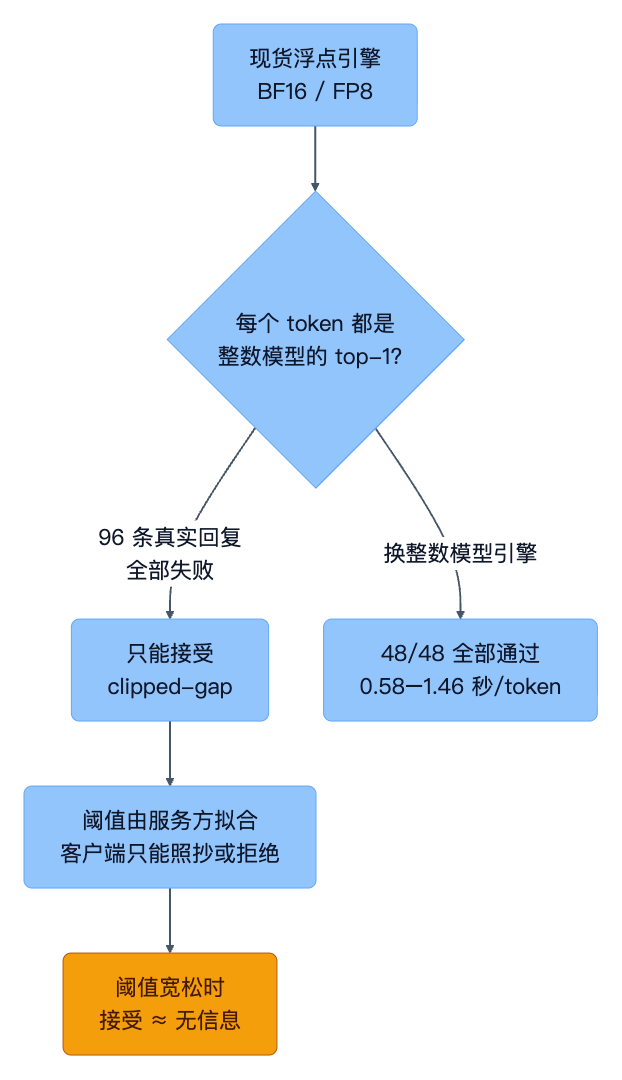
图 10
图 10|两难。exact match 要求每个 token 都是整数模型 top-1——现货浮点引擎根本做不到(96/96 失败)。clipped-gap 让 96/96 都能通过,但它的保证只是”gap 的均值与超阈个数满足你声明的界”。
阈值是 provider 自己拟合的(expect.bin),客户端如果判断不了松紧,作者的建议很直接:只接受 exact match。
再加上”配置可把模型关掉”这一条,语义层的结论是:密码学部分做到了工业级严谨,语义部分还停留在”你要自己判断对方是否诚实”。
6.3 工程账:它是原型,不是产品
-
承诺会耗尽:每 leaf 最多 688,127 个 batch,M 在 commit 时固定,事后不能加。到期只能重新承诺,新 ID 与旧 ID 没有证明关联。
-
单卡单模型:没有多卡、多机、多模型;窗口 1,024 token,长上下文要截断,而截断会破坏跨块注意力。
-
容灾几乎为零:
isk不可恢复,磁盘故障等于重新承诺。 -
示例前端不满足多租户:凭 proof ID + 共享 API key 可以取走别人的 proof。
6.4 我的判断
值得关注的三点:
-
它把”可验证推理”的规模上限从 10 亿参数推到了 4000 亿,而且用的是透明、后量子友好的哈希型 IOP,不走椭圆曲线那条路。
-
3 万行 Lean 不是炫技。这个系统的可靠性论证依赖大量易错的编码论细节(Johnson 半径、列表解码、掩码预算),把验证器形式化至少排除了”实现 bug 导致接受假陈述”这一类错误。
-
它诚实地列出了自己的局限。仓库里有一份
docs/limits-all-rows.tsv,逐条列了所有已知限制;这种自我披露在开源项目里少见。
现在不要指望的三点:
-
不要指望它解决”模型身份”。它解决的是”这套权重的一致性”,身份问题必须靠带外锚定。
-
不要指望它上线到默认链路。93× 的算力成本决定了它只能是抽样或高价值场景。
-
不要把它当”已审计的安全产品”。研究工件、无独立审计、程序无定理,三个条件同时成立。
6.5 一个更根本的问题
把 FlashProve 放到整个”AI 可信”的版图里看,它回答的是最硬、也最窄的一个问题:这次计算是不是这套权重做的。
但它没回答的问题同样重要:这套权重是谁训练的、训练数据是什么、有没有后门、回复有没有被内容策略改写、这次请求是不是真的来自你。
这些问题的答案不在密码学里。密码学能做的,是把”计算完整性”这一块从”信任人”变成”信任数学”。剩下的部分,仍然要靠合同、审计、监管和开源。
这大概也是为什么它被定位成”研究工件”而不是产品:它证明了这条路能走通,但离”能放心依赖”还有距离。
附:参考资料(全部一手)
| 想核对什么 | 看哪里 |
|---|---|
| 定位与快速开始 | README.md |
| 设计与威胁模型 | docs/architecture.md、docs/service.md |
| 到底证了什么、没证什么 | guide/what-is-proved.md、docs/what-is-not-hidden.md |
| 已知局限与性能数字 | guide/known-limits.md、docs/limits-all-rows.tsv、guide/performance.md |
| 形式化验证与数学 | lean/THEOREM.md、paper/(技术报告需另行索取) |
关于本文数字的说明:所有性能与通过率数据均来自仓库文档的实测记录,我没有复现;Lean 定理的边界以 guide/what-is-proved.md 与 verifier/README.md 的自我声明为准。如果仓库更新(当前 Version 0.16.0),细节可能变化。
如果这篇让你对”可验证推理”有了具体的手感,欢迎留言聊聊:在你的业务里,你会为哪一类请求开启证明? 是监管审计、模型授权,还是客户申诉?
我是 Aaron,10 年算法工程经验,每周拆一个 AI 新东西的实现细节。
关注「AI 拆解猿」,每周拆一个 AI 协议、框架、源码或架构,直到你能自己动手。
