原标题:FreeToken: Efficient Edge-Native MoE Serving with Bandwidth-Adaptive Execution 论文链接:arXiv:2608.16157 开源地址:GitHub — FlashML-org/FreeToken 官网:https://flashml.ai 作者团队:UC Berkeley、UT Austin、MIT 等(Song Han、Matei Zaharia、Ion Stoica 等)
一、为什么要读这篇论文?
如果你是一名开发者,可能已经习惯了这样的节奏:本地跑小模型(7B、13B)调代码,一旦需要更强能力,就得把数据发到云端调用 GPT、Claude 或 DeepSeek 的 API。这不仅是钱的问题——隐私、延迟、网络依赖,都是绕不开的痛点。
2026 年,开源权重模型的能力正在以惊人的速度追赶闭源巨头。Kimi-K3、GLM-5.2、DeepSeek-V4-Flash……这些模型的名字频繁出现在各大评测榜的前列。但问题在于:拿到模型权重 ≠ 能在本地跑起来。它们动辄几百 B 参数,传统观念里必须依赖价值数百万美元的数据中心 GPU 集群。
FreeToken 的出现彻底改写了这一等式。它的目标非常直接:把用户已经拥有的个人电脑——从 8GB 显存的笔记本到单张工作站显卡——变成一个能够实际服务前沿 MoE 大模型的统一推理平台。在 RTX 5090 上,FreeToken 能以 22~25 tok/s 的交互级速度跑满 284B 的 DeepSeek-V4-Flash;在 RTX PRO 6000 上,甚至能服务 753B 的 GLM-5.2。而且,它不是某种”蒸馏版”或”量化妥协版”,而是满血模型。
本文将结合论文原文、作者公开的技术细节,以及中文社区的第一手实测反馈,用通俗易懂的方式拆解 FreeToken 的核心设计,并配以论文中的关键图表,帮助你理解这套系统为何能在消费级硬件上实现”数据中心级”的推理体验。
二、背景:MoE 是边缘推理的钥匙,也是绊脚石
2.1 什么是 MoE(混合专家)?
想象一家大型医院,里面有几百位专科医生(专家)。病人来看病时,导诊系统并不会让所有医生都过来会诊,而是根据症状把病人分配给最相关的 2~3 位专科医生。这样既保证了诊疗质量,又避免了资源浪费。
混合专家模型(Mixture of Experts, MoE) 就是这么工作的:模型里有几百个”专家”子网络,但处理每一个 token 时,路由网络(Router)只会从中挑选少数几个(比如 6~8 个)参与计算。这意味着:
-
总参数量可以非常大(例如 284B、753B),决定了模型的知识容量和智力上限;
-
激活参数量却很小(例如 13B、35B),决定了每一次推理的实际计算量。
这种”稀疏激活”的特性,让 MoE 成为在边缘设备上运行超大模型的天然候选者——理论上,你只需要算得动那十几 B 的激活参数,就能享受到几百 B 总参数带来的智能水平。
2.2 但为什么现有的本地引擎跑不好 MoE?
过去两年,社区涌现了不少优秀的本地推理引擎,比如 llama.cpp、Ollama、KTransformers。它们在把小模型搬到笔记本上这件事上立下了汗马功劳,但在面对前沿 MoE 大模型时,普遍存在三个维度的短板:
第一,Prefill 阶段(首 token 生成)拖慢严重。 虽然 decode 时每个 token 只走少数专家,但 prefill 阶段要一次性处理一长串 prompt。比如一个 4k 的代码文件,每个 token 激活 6 个专家,把这些路由集合起来,几乎会覆盖模型中绝大多数专家。结果就相当于要把庞大的专家池逐层从主机内存(DRAM)搬到显存(VRAM),PCIe 带宽瞬间成为瓶颈。传统方案在这一阶段往往卡死数秒甚至更久。
第二,Decode 阶段(逐 token 生成)缓存命中率低。 每个新生成的 token 通常只激活少量专家,但这些专家未必在显存里。如果每次”缺专家”都要等 PCIe 搬运,decode 速度就会跌到完全无法交互的程度。现有系统要么用静态放置(把一部分专家固定放 GPU,剩下放 CPU),要么靠预测预取,但都无法灵活应对 token 级别的路由变化。
第三,边缘硬件千差万别,且资源不专属。 数据中心的服务器是”你的地盘你做主”——所有资源都归模型服务。但个人电脑不一样:8GB 和 32GB 显存的差距巨大,PCIe 版本从 3.0 到 5.0 不等,CPU 从笔记本低压 U 到桌面级 R9 都有,而且用户可能一边跑模型一边开浏览器、打游戏。没有一种”万能配置”能在所有机器上跑得最好。
2.3 FreeToken 的回答:不固定策略,只动态映射
FreeToken 的核心哲学可以用一句话概括:不预先承诺任何固定的卸载(offloading)策略,而是在运行时持续把计算和模型状态映射到当前实际可用的资源上。它不是把 GPU 当作主角、CPU 当作配角,而是把整台机器——GPU、CPU、DRAM、PCIe——视为一个统一的弹性推理平台。
接下来,我们进入 FreeToken 的三大技术支柱。
三、技术支柱一:带宽自适应执行(Bandwidth-Adaptive Execution)
边缘推理最痛的瓶颈不是算力,而是带宽。CPU 和 GPU 之间的 PCIe 通道,以及 CPU 访问主机内存的 DRAM 带宽,都是有限的。FreeToken 的做法不是”拼命减少搬运”,而是让系统根据实时测得的带宽,动态决定哪些计算放 GPU、哪些放 CPU、哪些数据走 PCIe。
3.1 Prefill:全层双缓冲(Full-Layer Double Buffering)
在 prefill 阶段,FreeToken 采用了一种”流水线”式的专家加载策略:
-
GPU 正在计算第 l 层的同时,第 l+1 层的专家通过 PCIe 异步加载到显存;
-
当第 l 层算完,第 l+1 层刚好就位,立刻开始计算。
这种全层双缓冲把专家搬运和计算重叠起来,而不是”搬完再算、算完再搬”,显著压缩了首 token 延迟(TTFT)。论文中的测试显示,对于 4~16k 的长 prompt,FreeToken 的 TTFT 比现有方案低了 42%~58%。
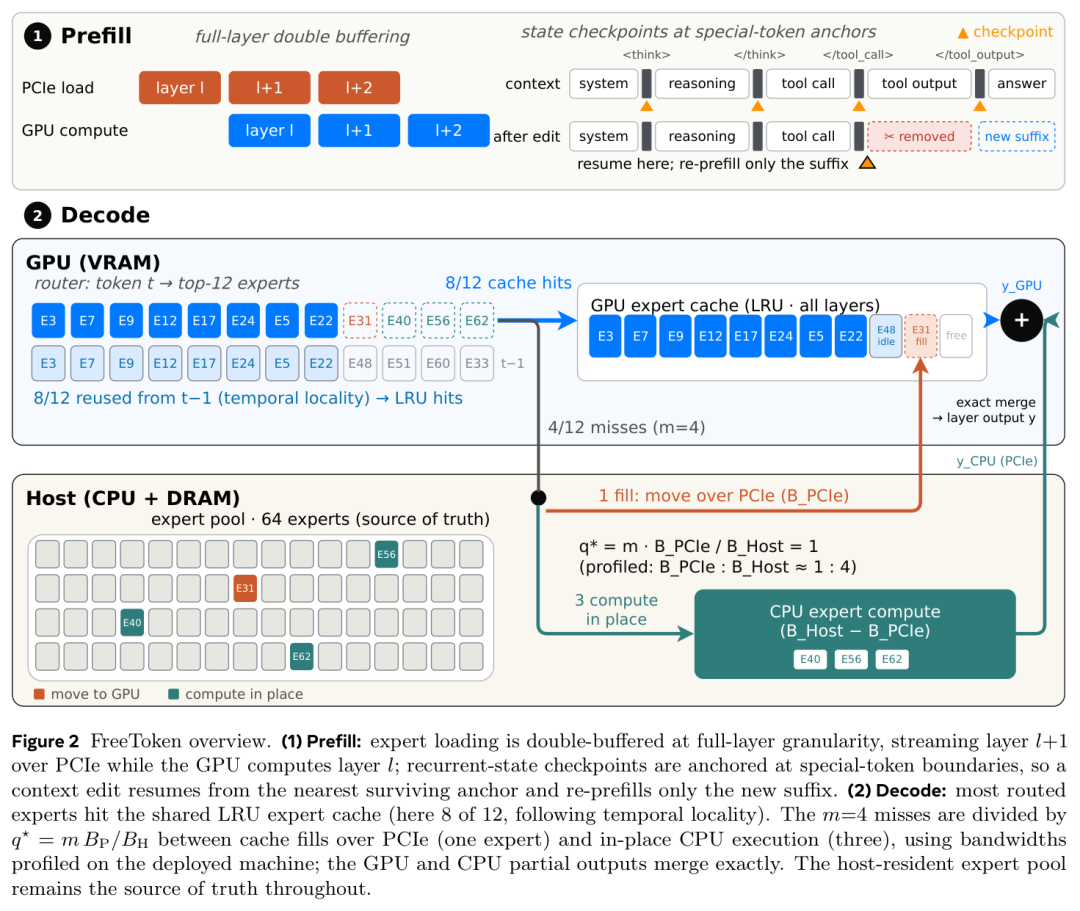
图2:FreeToken 系统概览,展示了 Prefill 双缓冲与 Decode 的 q* 策略
图 2:FreeToken 系统概览。(1) Prefill 阶段:GPU 计算第 l 层时,PCIe 在后台并行加载第 l+1 层专家,形成双缓冲流水线。(2) Decode 阶段:大多数专家命中 GPU 上的共享 LRU 缓存;未命中的部分通过 q 策略在”PCIe 搬运到 GPU”和”直接在 CPU 上计算”之间智能分配。*
3.2 Decode:q* 策略——每个时间步的”最优分工”
Decode 阶段的挑战更微妙。假设当前 token 需要 12 个专家,其中 8 个已经在 GPU 缓存里(命中),剩下 4 个缺失。这 4 个缺失的专家怎么办?传统方案要么全部从 DRAM 搬到 GPU(PCIe 压力大),要么全部放在 CPU 上算(CPU 算力可能不够)。
FreeToken 提出了一种基于实测带宽的 q* 分配策略:
-
m = 当前步缺失的专家数;
-
B_PCIe = 实测的 PCIe 有效带宽;
-
B_Host = 实测的 CPU 访问主机内存带宽。
系统把 q* = m × B_PCIe / B_Host 个专家分配给 GPU(通过 PCIe 搬运),剩下的 m - q* 个专家直接在 CPU 上就地计算。CPU 算完后,结果通过 PCIe 回传给 GPU,与 GPU 本地计算的输出精确合并(exact merge),得到最终的层输出。
为什么这样是最优的?因为 PCIe 和 CPU 内存带宽是竞争同一根主机内存总线的。如果 PCIe 搬太多,CPU 就没带宽读内存;如果 CPU 算太多,又浪费了 GPU 的强劲算力。q* 的公式本质上是让两种资源在同一时间步内达到”带宽平衡”,从而实现该硬件拓扑下的理论最大吞吐。
更重要的是,这个策略是动态的。如果用户后台突然开了个大型游戏,PCIe 可用带宽下降,FreeToken 会在后续时间步自动提高 CPU 就地计算的比例;反之亦然。这让它能稳定适应资源波动。
四、技术支柱二:语义感知缓存(Semantic-Aware Caching)
带宽自适应执行解决的是”资源怎么用”,语义感知缓存解决的是”什么该留下”。
4.1 跨轮次状态复用:Agent 时代的刚需
今天的 AI 应用不再是”一问一答”,而是多轮 Agent 交互——Claude Code、OpenCode、DeepSeek Harness 等工具会不断调用函数、读取文件、追加思考链(Chain-of-Thought)。每次工具调用返回后,上下文都会变长,触发一次新的 prefill。如果每次都要从头算一遍,TTFT 会随轮次线性增长,用户体验极差。
FreeToken 观察到,Agent 的上下文编辑通常发生在语义边界上:系统提示(system prompt)基本不变,用户的最新编辑只影响后面的后缀。因此,FreeToken 在特殊 token 边界(如 <think>、<tool_call>、<tool_output>)处建立轻量级状态检查点(checkpoints)。当一轮对话结束后,只有被修改的后缀需要重新 prefill,前面的状态可以直接复用。
实测表明,这种机制让多轮交互的 TTFT 降低了 65%~80%。
4.2 专家缓存:捕捉 token 间的路由局部性
在 decode 阶段,相邻 token 往往倾向于激活相似的专家(称为”路由局部性”或”时间局部性”)。FreeToken 在所有层之间维护了一个共享的 LRU(最近最少使用)专家缓存。当第 t 个 token 需要某些专家时,如果它们还在缓存里,就直接命中;否则才触发前述的 q* 策略处理缺失。
这种缓存的效果非常显著。在论文的示例中,12 个目标专家里有 8 个可以直接从缓存命中,命中率接近 70%。这让 decode 过程中 PCIe 的抖动大大减少,输出速度更平稳。
五、技术支柱三:弹性边缘资源管理
个人电脑不是服务器,可用内存随时在变。FreeToken 在调度器的安全点(safe points)动态调整 GPU 专家缓存的大小:如果用户关闭了其他应用,释放出更多显存,FreeToken 就会扩大缓存以提高命中率;如果其他应用抢占了内存,FreeToken 就收缩缓存,把专家移回主机内存,而不会崩溃或需要重启引擎。
此外,FreeToken 在启动时采用了一种直接加载到最终布局的策略:专家权重从磁盘读取后,直接写入主机内存中的最终排列格式,省去了传统方案中”先读到一个缓冲区,再拷贝、再 pin 内存”的多重开销。这显著降低了冷启动时间,让用户能更快开始对话。
六、实验结果:从笔记本到工作站的全面跨越
FreeToken 的论文提供了非常详实的实验数据,覆盖了 20 多个 MoE 模型、6 种硬件平台、4 类真实 Agent 工作负载,并与 llama.cpp、Ollama、KTransformers、MoE-Infinity 等主流引擎进行了对比。
6.1 成本-能力帕累托前沿
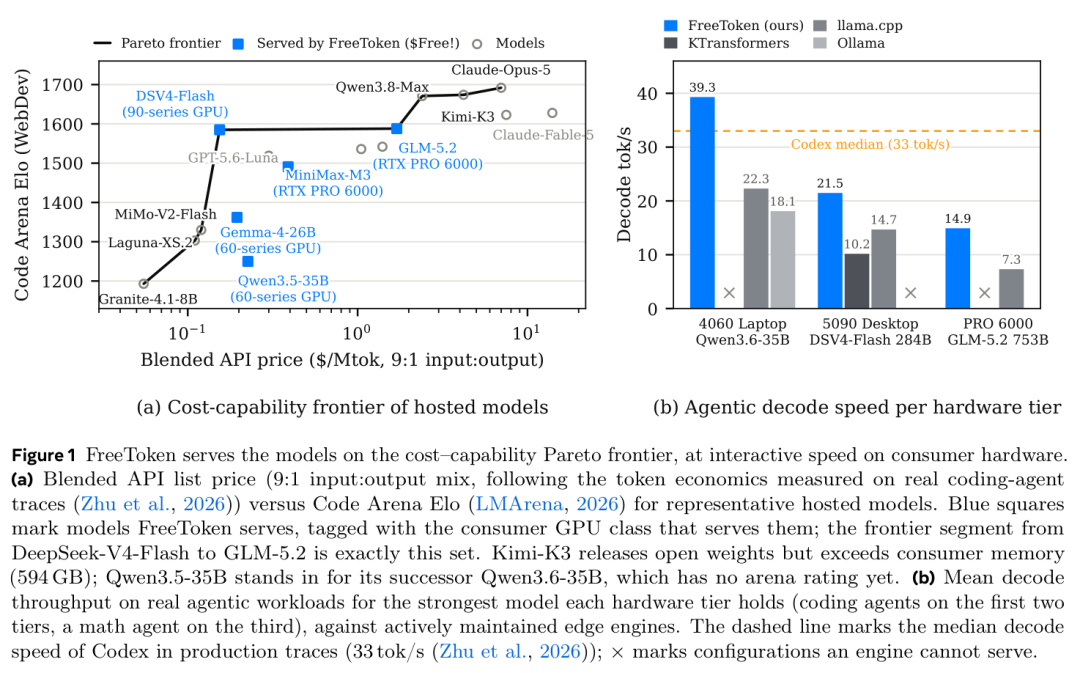
图1:FreeToken 在成本-能力帕累托前沿上的位置
图 1:(a) 展示了主流托管模型的 API 成本与 Code Arena Elo 评分关系。蓝色方块是 FreeToken 能在本地服务的模型,覆盖从 DeepSeek-V4-Flash 到 GLM-5.2 的前沿区间。(b) 展示了在三种典型硬件上,FreeToken 与基线引擎的 decode 速度对比。虚线是 Codex 生产环境的中位 decode 速度(33 tok/s)。
从图 1(a) 可以看出,FreeToken 本地服务的模型恰好落在了成本-能力帕累托前沿上——也就是说,同等智能水平下,本地运行的成本(电费+硬件折旧)远低于持续调用云端 API;而在同等成本下,它能提供的模型质量是最高的。
图 1(b) 则展示了 FreeToken 在不同硬件层级上的实战表现:
| 硬件平台 | 模型 | FreeToken 速度 | 基线最佳速度 | 倍数 |
|---|---|---|---|---|
| RTX 4060 笔记本 (8GB) | Qwen3.6-35B | 39.3 tok/s | ~24 tok/s (llama.cpp) | 1.6x |
| RTX 5090 台式机 (32GB) | DeepSeek-V4-Flash 284B | 22~25 tok/s | ~14.7 tok/s | 1.5x |
| RTX PRO 6000 工作站 | GLM-5.2 753B | 14.9 tok/s | ~7.3 tok/s | 2.0x |
值得注意的是,RTX 4060 笔记本跑 35B 模型的 39.3 tok/s,已经超过了 Codex 在生产环境中位速度的 33 tok/s。这意味着:一个普通大学生的游戏本,本地跑开源模型的速度可以媲美顶级闭源 API 的响应体验。
6.2 端到端性能与稳定性
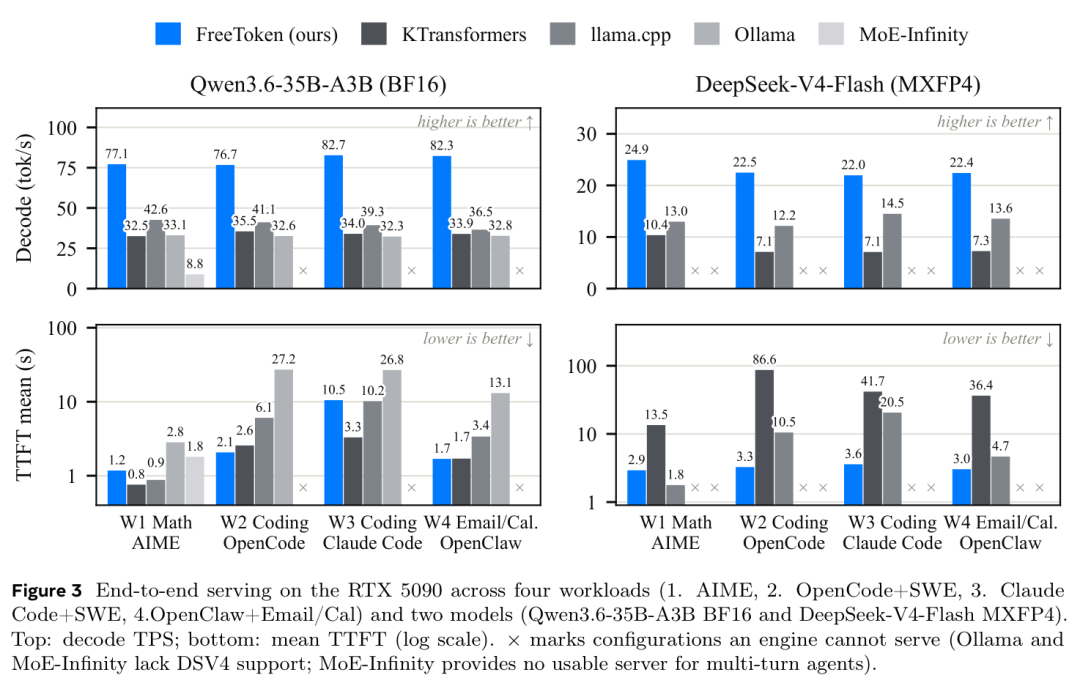
图3:RTX 5090 上的端到端性能对比
图 3:在 RTX 5090 上,FreeToken 与基线引擎在四种真实 Agent 工作负载(AIME、OpenCode、Claude Code、SWE)上的 decode 吞吐与 TTFT 对比。蓝色柱状图为 FreeToken。
从图 3 可以清晰看到,FreeToken 的 decode 吞吐量全面领先,而 TTFT 更是断崖式优势:FreeToken 在所有工作负载上的最坏 TTFT 都控制在 44 秒以内,而每个基线引擎至少在某个场景下超过了 150 秒——后者足以触发真实 Agent 客户端的超时机制。
更重要的是稳定性。当工作负载从单轮对话变得越来越”Agent 化”(多轮工具调用、长上下文)时,FreeToken 的 decode 速度仅下降不到 12%,而竞品引擎出现了显著退化。这说明 FreeToken 的设计是真正围绕 Agent 场景从头打造的,而不是在单轮聊天引擎上打补丁。
6.3 Prefill 与 Decode 的细分表现
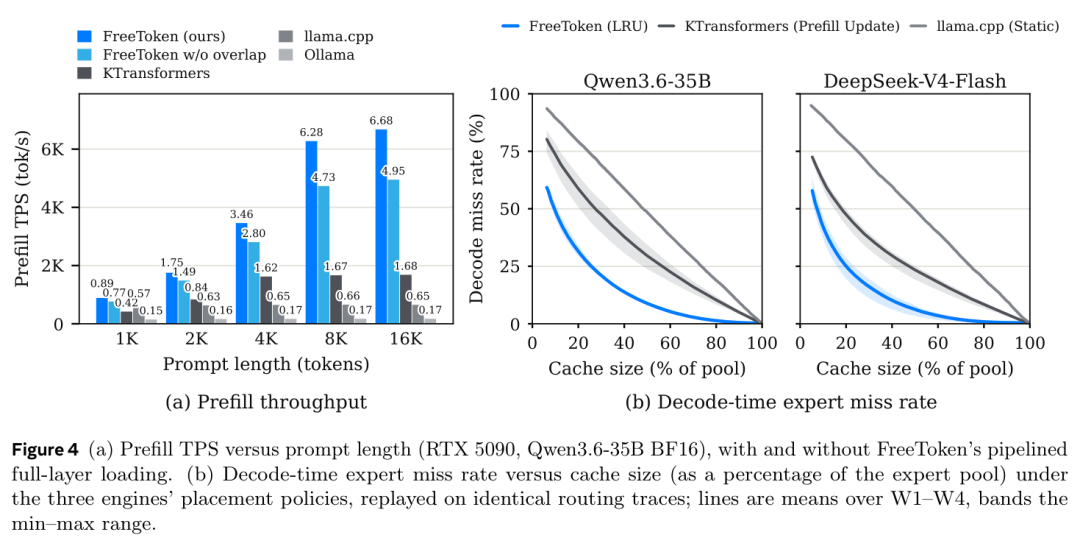
图4:Prefill 阶段性能与长上下文表现
图 4:(a) Prefill TPS 随 prompt 长度变化(RTX 5090, Qwen3.6-35B),FreeToken 在长文本下保持更高且更稳定的 prefill 吞吐。(b) 不同 batch 大小与不同工作负载下的扩展性分析。
图 4(a) 显示,随着 prompt 长度从 512 增长到 16k,FreeToken 的 prefill 吞吐下降幅度远小于基线。这得益于全层双缓冲把 I/O 和计算重叠,而不是让 PCIe 搬运阻塞 GPU。
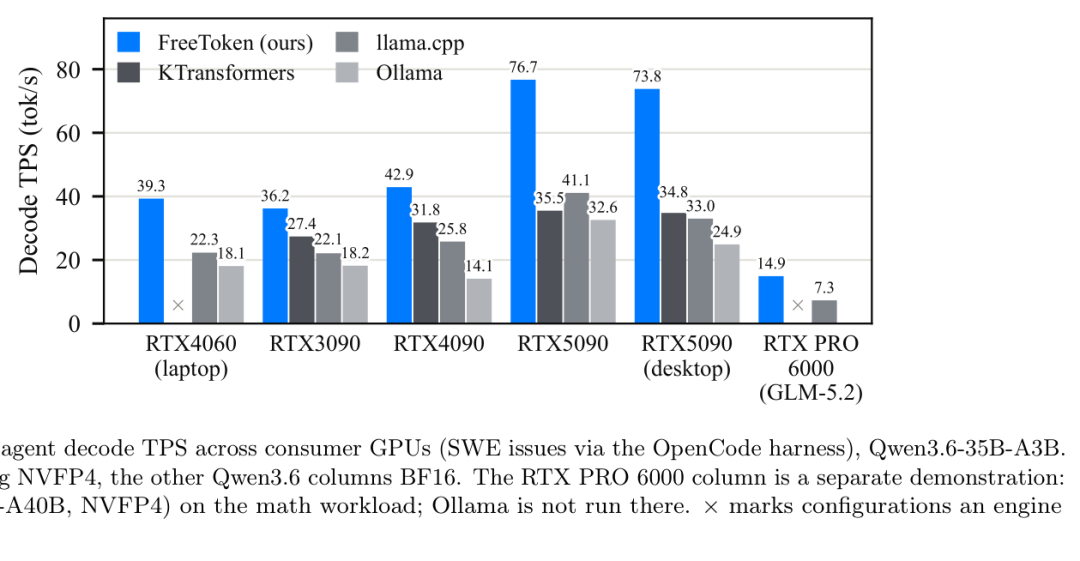
图5:多硬件平台的 Coding Agent 性能
图 5:在五种消费级 GPU 上运行 OpenCode Agent 的 decode TPS。从左到右:RTX 4060 Laptop、RTX 4060 Ti Desktop、RTX 4090、RTX 5090、RTX PRO 6000。
图 5 展示了 FreeToken 的广泛硬件适配能力。从入门笔记本到顶级工作站,它在每一档硬件上都跑出了该级别下的最优或接近最优的吞吐。相比而言,某些基线引擎在特定硬件上直接无法启动(图中以 × 标记),或者速度断崖式下跌。
七、生态与使用:不只是论文,更是可部署的软件
FreeToken 团队没有止步于发表论文。他们在发布论文的同时,就开源了代码,并提供了非常友好的使用方式:
-
一行命令安装:
uv pip install "freetoken[accel]" -
桌面应用:Windows / Linux 的 GUI 客户端已经可用(官网 flashml.ai 可下载)
-
API 兼容:原生支持 OpenAI 兼容接口(
/v1/chat/completions、/v1/responses)以及 Anthropic 兼容接口(/v1/messages),意味着你可以把任何支持 OpenAI SDK 的 Agent 框架(如 LangChain、OpenCode、Dify)的 base URL 指向本地 FreeToken 服务,零改动迁移。
截至 2026 年 8 月下旬,GitHub 仓库已收获近千 Star,社区反馈积极。中文社区也已经出现了多篇实测文章,验证了论文中的性能数据在真实环境下基本可复现。
八、总结与展望
FreeToken 的意义不仅仅在于”让 RTX 5090 跑起了 284B 模型”这个 headline。它真正解决的是一个系统性问题:如何把开放权重转化为开放访问(open access)。
在过去,模型的能力边界由”谁能买得起数据中心”决定。FreeToken 通过全栈协同设计——从模型加载、专家缓存、CPU-GPU 混合执行,到 Agent 状态复用和运行时弹性内存管理——证明了消费级硬件的潜力被严重低估。全球数以亿计的游戏 PC 和工作站,加起来的总算力是一个惊人的数字;缺的只是一套能把这些零散、异构、不稳定的资源调度好的系统。
当然,FreeToken 也不是万能的。它目前主要针对单用户、低并发的本地 Agent 场景设计,多用户并发服务仍然需要 vLLM、SGLang 这类数据中心框架。此外,它的优势在 MoE 架构上最明显,对于传统的 Dense 模型(如早期的 LLaMA-2),带宽自适应执行带来的收益会小一些。
但放眼未来,随着 MoE 成为前沿开源模型的默认架构(DeepSeek、Qwen、GLM、Kimi 均已采用),FreeToken 所代表的”边缘原生(Edge-Native)“推理范式,极有可能成为本地 AI 的基础设施之一。对于每一位希望在自己的机器上拥有顶尖 AI 能力的开发者来说,这都是一件值得兴奋的事。
参考资料
-
Yang, S., Fan, X., Pan, M., et al. FreeToken: Efficient Edge-Native MoE Serving with Bandwidth-Adaptive Execution. arXiv:2608.16157, 2026.
-
FreeToken GitHub 仓库:https://github.com/FlashML-org/FreeToken
-
FreeToken 官网:https://flashml.ai
-
中文社区解读:《单卡 5090 跑满血 DeepSeek V4-Flash,已开源,Token 自由了!》,机器之心,2026.
-
相关基线系统:llama.cpp、Ollama、KTransformers、MoE-Infinity.
我是 Aaron,10 年算法工程经验,每周拆一个 AI 新东西的实现细节。
关注「AI 拆解猿」,每周拆一个 AI 协议、框架、源码或架构,直到你能自己动手。
