港大 HKUDS 出品。它把「一次对话」做成了可恢复的数据库事务,把「教学法」写成了不带一行提示词的纯函数。
先说一个我自己的困惑。
过去两年我们见了不少「AI 家教」「AI 陪练」,演示效果都很好:讲得清楚、有耐心、还会追问。但只要真用上一周,问题就出来了——
它讲得很好,但它记不住你。
上次你学到哪、哪里卡住、哪道题错过、为什么错,全都没有。你换一个会话,它又从头开始热情地自我介绍。你刷新一下页面,正在生成的那段回答直接消失。
这不是模型能力问题。这是产品没有状态。
所以当我翻到 DeepTutor 这个项目,看到它的目录结构里有一整个 learning/ 模块、近两万行只干一件事——判断「你到底学会没有」——我意识到它解决的问题和大多数 AI 产品不在一个层面上。
它 2025 年 12 月 28 日建仓,到今天(2026 年 11 月)不到 11 个月,54,504 star、6,664 fork,Apache-2.0,背后是港大数据智能实验室(HKUDS)。论文挂在 arXiv(2604.26962),自建了一个叫 TutorBench 的评测集,声称个性化指标平均提升 10.8%,在 5 个基座模型上的通用 agentic 推理提升 29.4%。
但读完代码,我认为这个项目真正的价值,不在那些教学功能上。
一、先把它放对位置:它不在 Harness 那一层
讨论 AI 产品时最常见的混乱,是把不同层级的东西放在一起比。
2026 年大家都在聊 Harness——Claude Code、Codex、DeepSeek Harness。它们解决的是同一类问题:怎么让模型能安全地调用工具、管理上下文、在真实环境里干活。
DeepTutor 不在这一层。
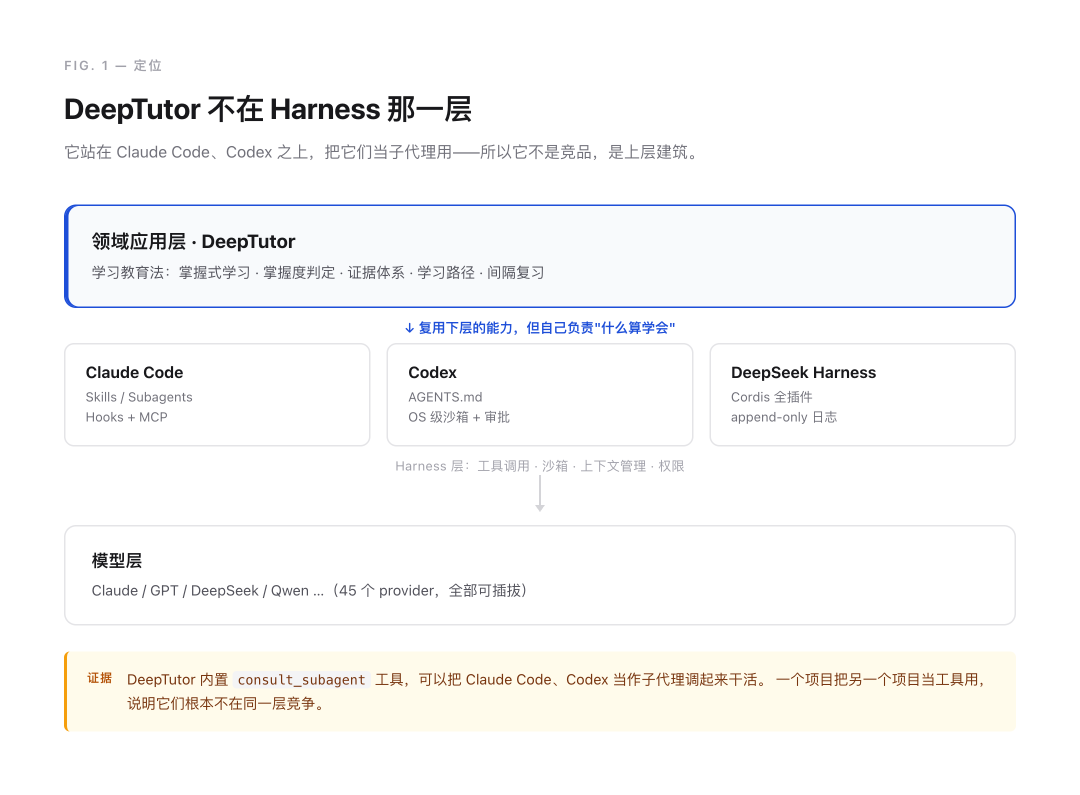
DeepTutor 的层级定位
它站在 Harness 之上。你可以用 Claude Code 当底座,也可以换 Codex,它自己不关心。它关心的是另一个问题:什么叫做「学会了」。
这个判断有个很硬的证据。DeepTutor 内置了一个工具叫 consult_subagent,可以直接把 Claude Code、Codex 当子代理调起来干活。
一个项目把另一个项目当工具用,说明它们根本不在同一层竞争。就像餐厅不会和菜市场比谁的菜更好——它去菜市场买菜。
这个定位区分很重要,因为它决定了你该怎么读这个项目:不要去看它「有哪 10 个功能」,要看它怎么把「教育」这件事拆成代码。
二、第一个反常识:一次对话,被当成一笔分布式事务
普通 AI 应用处理一次请求是这样的:
收到消息 → 调模型 → 流式吐字 → 结束
出错了怎么办?重来。断了怎么办?重发。这就是「喊一嗓子」的做法。
DeepTutor 的做法更像下一笔外卖订单:下单有单号(防重复下单)、有骑手接单(防两个骑手送同一单)、有订单状态流转、送丢了能查、系统挂了重启还能接着送。
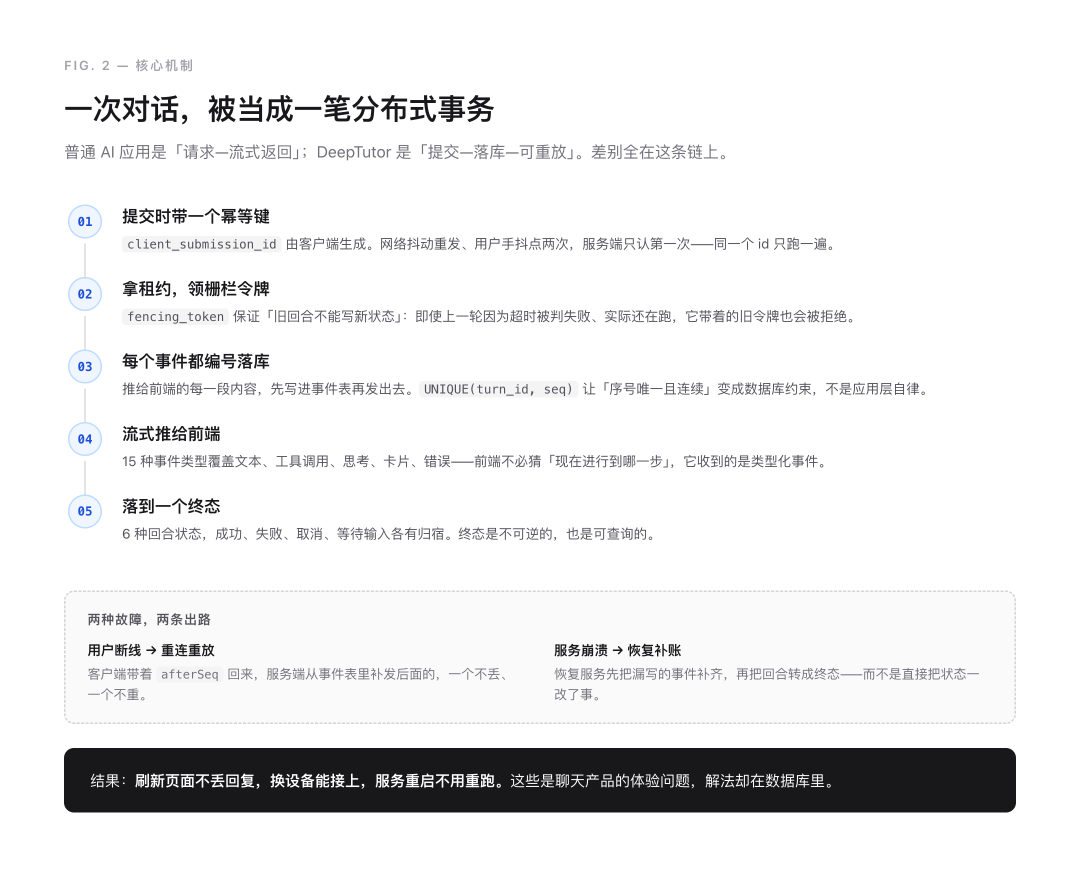
一次回合的完整生命周期
具体做了五件事:
① 幂等键。 客户端提交时带一个 client_submission_id。网络抖动重发、用户手抖点两次,服务端只认第一次。这不是什么新招,但很少有 AI 应用真的做。
② 栅栏令牌(fencing token)。 这个稍微冷门,但很关键。想象一个回合因为超时被判失败,其实它还在后台跑,几秒后它想写状态——如果没防护,它就会覆盖掉新一轮的结果。栅栏令牌的作用是:旧回合带的令牌已经过期,写入直接被拒。
③ 每个事件先落库,再推给前端。 推给浏览器的每一段文字、每一次工具调用、每一个思考片段,都是先写进事件表再有编号地发出去。而且序号唯一性靠数据库约束 UNIQUE(turn_id, seq) 保证,不是靠代码自觉。
④ 断线重放。 用户网络断了再回来,客户端带上「我收到第几条了」,服务端从事件表里补发后面的。一个不丢,一个不重。
⑤ 崩溃恢复。 服务重启后,恢复程序不是简单把状态改成「失败」,而是先把漏写的事件补齐,再转终态。这个顺序很重要——先补账,再结账。
这件事为什么值得抄
因为它把一堆「体验问题」变成了「数据问题」。
「刷新页面丢回复」「换设备接不上」「服务重启任务全丢」——这些在需求评审里通常被归为「体验优化,下个版本再说」。但它们的根因是架构里没有真相源。
DeepTutor 的答案很朴素:把状态机的真相放进数据库,而不是放在某个进程的内存里。
代价是每轮多几次写库。收益是上面那些故障模式一次性消失。
三、第二个反常识:教学法被写成了纯函数
这是我读完最有触动的一段。
大模型产品做「业务规则」,主流做法是写提示词:
你是耐心的导师,请判断学生是否已经掌握……达到 90% 才算通过……
这套写法的问题是:不可测试、不可解释、还会漂移。 同一份提示词,今天判对明天判错;换个模型,阈值全变;用户投诉「为什么说我没学会」,你拿不出任何证据。
DeepTutor 把这套规则搬到了 policy.py——581 行,零 IO,零模型调用,全是纯函数。
它的模块注释第一句就写着:没有 LLM 调用,没有 IO。
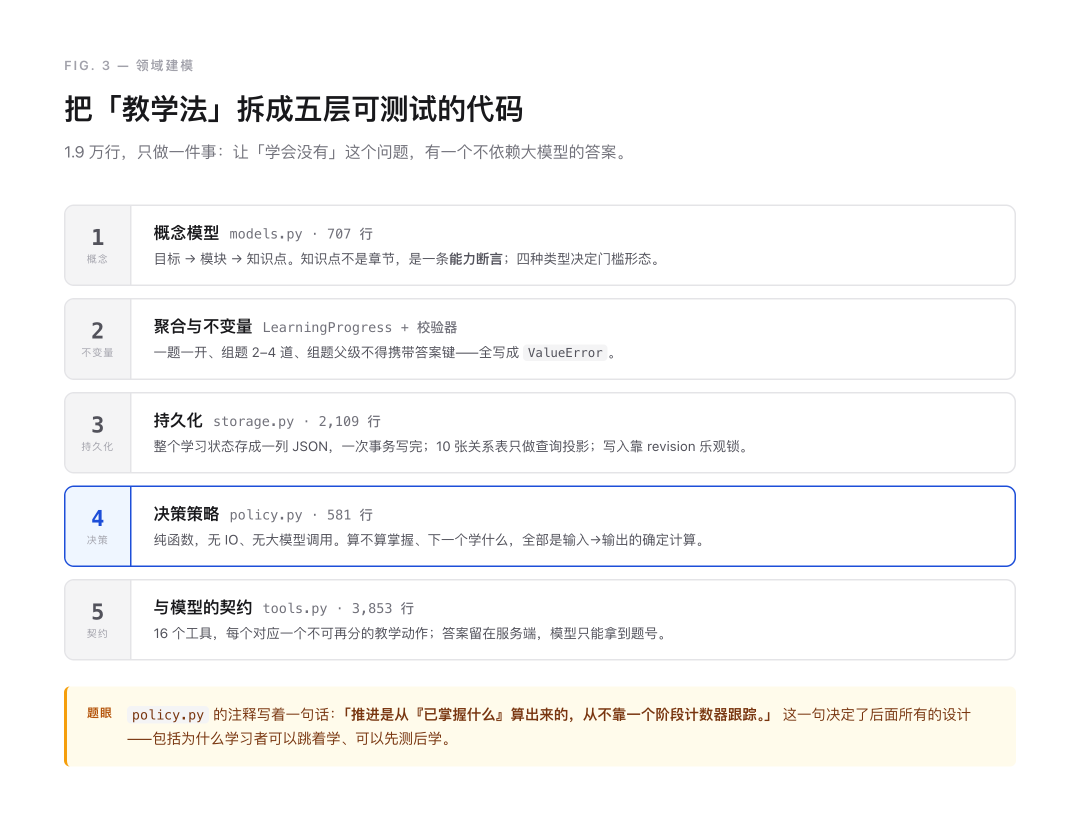
领域建模的五层结构
这套代码分五层,每层都能独立验证:
第一层,概念模型。 学习目标拆成「模块 → 知识点」。关键设计是:知识点不是章节,是一条能力断言。而且分四种类型——记忆、步骤、概念、设计。前两种可以定量判分(门槛 0.9),后两种只能定性判断(学习者用自己的话解释,导师判过/没过)。
为什么必须分?因为「理解」没有唯一答案。硬要定量化,只会逼模型把「理解」降级成「复述定义」。
第二层,不变量。 比如「一条学习路径同时只能有一道未作答的题」、「组题必须是 2 到 4 道」、「组题的父级不许携带答案」。这些全写成了模型校验里的 ValueError——违反就直接抛错,不给「大概对」的空间。
第三层,持久化。 整个学习状态存成一列 JSON,一次事务写完;另外 10 张关系表只做查询投影;写入用版本号乐观锁。这块后面讲代价。
第四层,决策策略。 这一层最关键。
第五层,与模型的契约。 16 个工具,每个对应一个不可再分的教学动作。
一个句子点破了整套设计
policy.py 里有一句话,我认为是整个项目最值钱的一句:
推进是从「已经掌握了什么」算出来的,从不靠一个阶段计数器来跟踪。
这句话在反对什么?反对绝大多数课程产品的做法:维护一个游标,「当前第 3 章第 2 节」。
为什么要反对?因为真实学习不长这样。有人跳着学,有人前面就会、直接测过,有人学到后面发现前面有洞、要回头补。每一种都在挑战游标模型,你得为每种情况写一套状态迁移逻辑,还容易出 bug。
DeepTutor 的做法是:每次重新算。 「下一个学什么」= 先批改待答的题、处理到期的复习,再遍历所有知识点,跳过已掌握的,取第一个没掌握的。
于是跳学、测过、回头补,全都不需要额外代码——因为压根没有状态要迁移。
代价是每次决策都要遍历一遍全部知识点。但一个学习路径通常就 20 到 60 个知识点,这个成本可以忽略。
掌握度是怎么算的
不是让模型「感觉一下」,而是一个 50 行的纯函数模块:
最近 5 次作答,权重从旧到新:(0.5, 0.7, 0.85, 0.95, 1.0)
加权平均后再封顶:只答过 1 次最多 0.5 分,2 次最多 0.8 分
这个「封顶」设计得很巧。它不是乘以系数,而是 min(分数, 上限)——只限制「证据不足时能宣称的最高水平」,不扭曲已有的加权结果。
而且它顺带解释了一件产品上的事:门槛是 0.9,所以至少要答 3 次才可能通过。 所以他们的提示词里专门有一条:禁止导师说「再最后一题」——除非系统已经返回「已掌握」。因为你根本不知道要几题。
四、第三个反常识:出完题,这一轮就该结束
这是全项目最反直觉、也最值得学的一处设计。
旧的做法(DeepTutor 自己早期也这么干):导师出完题,这一轮挂在那里,状态转成「等待输入」,等学习者作答。
听起来很自然,对吧?但它带来一连串麻烦:
-
学习者多久回来,这个回合就挂多久——可能永远不回来;
-
这条学习路径的写锁一直被这个回合占着,别人动不了;
-
学习者不答题,而是问了个别的 → 得当成「对挂起回合的打断」来处理;
-
学习者明天再来 → 也是打断;
-
学习者刷新页面 → 还是打断;
-
前端输入框该显示什么?没有诚实的状态可显示。
新的做法:出题就是这一轮的终点。
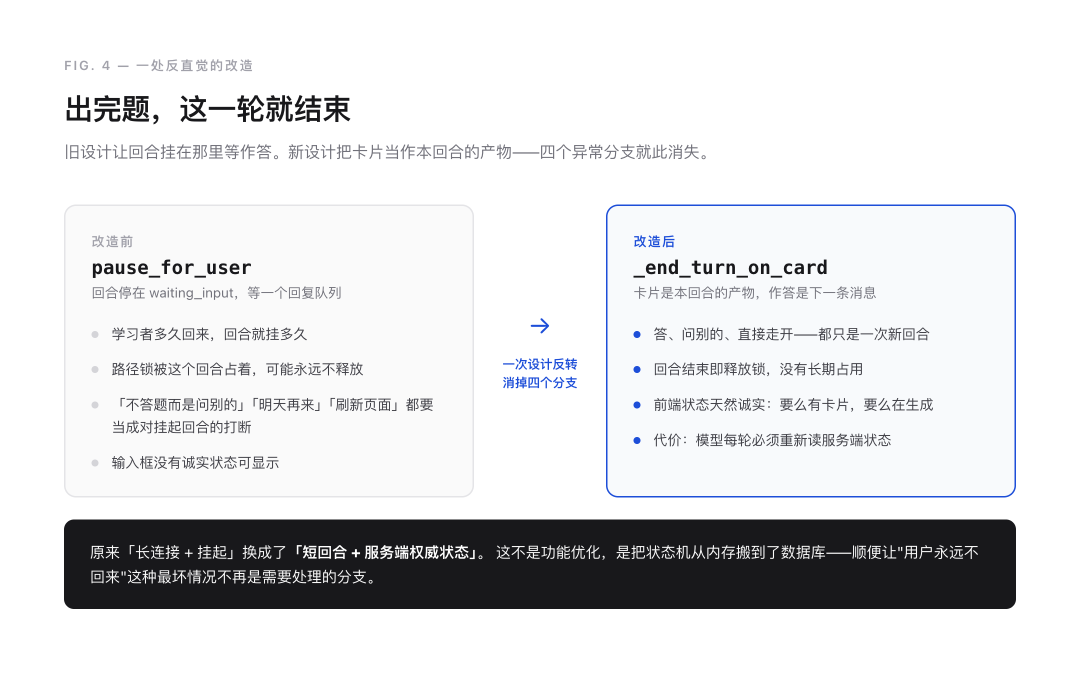
改造前后的对比
卡片是本回合的产物。学习者作答,就是下一条消息——和普通发消息没有任何区别。
于是上面那几条麻烦,全部消失了。不是「处理得更好」,是不存在了。
代码里的注释写得很直白:
一个提出的问题过去会把回合停在
pause_for_user……只要学习者不答,一个活跃回合和这条路径的锁就被占着,可能是永远。 在这里结束,把关系反转了。卡片是本回合的产物;回答它就是下一条消息,和你打一行字完全一样。
这个思路的普适性
任何「需要用户输入才能继续」的流程,都值得用这个视角重看一遍:
挂起等待 vs 结束回合 + 下一条消息。
后者的好处不只是释放资源,更是让每一个用户动作都变成一次干净的、幂等的、可恢复的提交。前端不需要维护复杂的挂起状态,后端不需要处理「挂起期间发生的一切」。
代价也有:模型每一轮都必须重新读服务端状态,不能依赖上下文里那份可能已经过期的快照。这是笔要认的账。
五、两个容易被忽略但很见功力的细节
细节一:答案永不经过模型
出题的时候,正确答案存哪儿?
绝大多数实现是:让模型把答案一起写进对话,判分时再让模型对比。这套做法的漏洞是——只要答案进过模型上下文,泄漏就只是概率问题。用户套话、模型解释时不小心引用、提示词注入,随便哪一种都能拿到答案。
DeepTutor 的做法是:答案存在服务器数据库里,模型只拿到一个题目 ID。
有个专门函数负责这件事,注释只有一句:「投影已持久化的待答状态,但不暴露 expected_answer。」
被排除在外的字段还有:解析、难度、来源证据、是否使用过辅助。全部服务端持有。
甚至选项顺序也会在服务端重新打乱。他们在提示词里明确要求:你给的字母不是学习者看到的字母,所以解释里不要引用「选 A」——按内容说答案,不要按位置说。
这挡住了一类很隐蔽的作弊:如果正确答案总在 A,那么「选 A」本身就是捷径。
细节二:不确定的时候,允许不判分
判分有三条通道:
| 题型 | 判据 | 阈值 |
|---|---|---|
| 选择 | 归一化后全等 | 精确 |
| 简答 | 编辑相似度 | ≥ 0.85,且答案不超过 30 字 |
| 开放 | 关键词覆盖率 | ≥ 0.6 |
三条都搞不定的,交给大模型做语义判分。但这里有个门槛:模型给出的置信度低于 0.8,一律降级为「未评分」。
「未评分」不是「答错」。它意味着这次判定不构成证据——不进掌握度计算,不影响分数,也不记为错题。
为什么必须这样?因为在掌握式学习里,误判的代价是不对称的:
-
把对的判错 → 学习者被迫重做已会的内容,体验崩;
-
把错的判对 → 掌握度虚高,学习效果崩。
两者的公共解不是「把准确率调到 99%」(做不到),而是在不确定时拒绝判定。
这个「逃生舱」的思路,我觉得比判分算法本身更值得抄。
六、它不能做什么
诚实标出边界,比罗列功能有用。
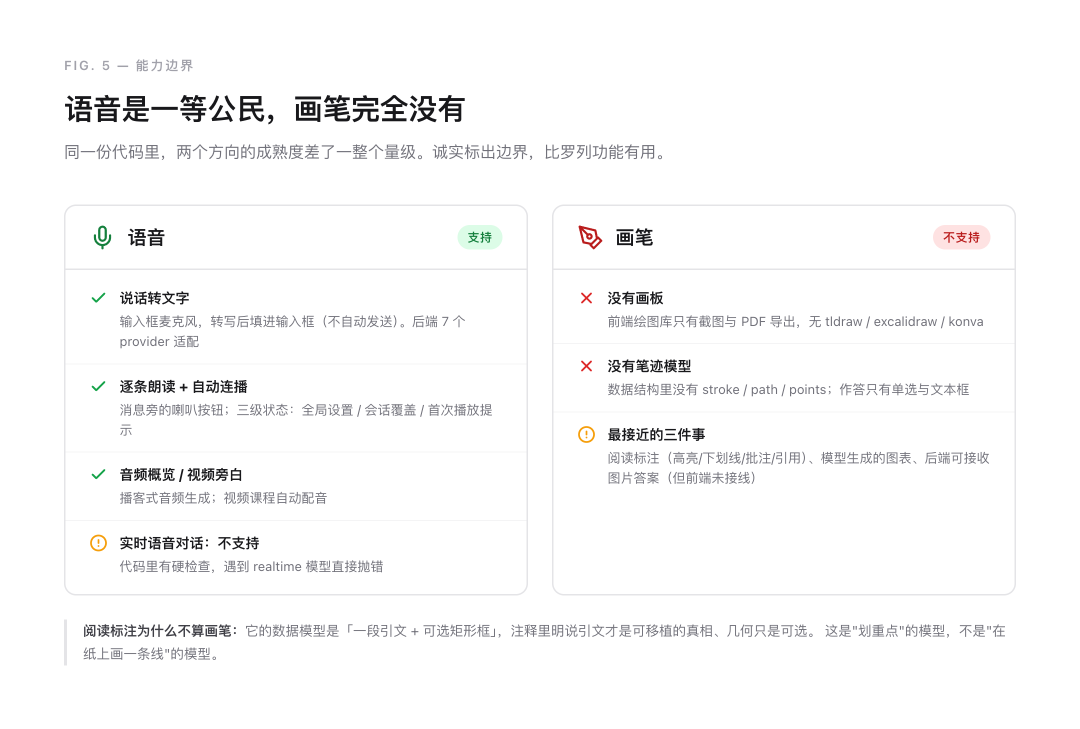
语音与画笔的能力边界
语音:是一等公民。 说话转文字(后端 7 个服务商适配)、消息逐条朗读、自动连播、音频概览、视频旁白,都是齐的。
但它不支持实时语音对话。 代码里有一条硬检查,配置成 realtime 模型直接抛错。所以它是「语音输入 + 语音输出」,不是那种能打断、能抢话的全双工对话。
画笔:完全没有。 前端没有任何绘图库,数据结构里没有笔迹(stroke / path),作答只有单选和文本框。
最接近的三件事也不等于画笔:
-
阅读标注:支持高亮、下划线、批注、引用。但它的数据模型是「一段引文 + 可选矩形框」,注释里明说引文才是可移植的真相,几何只是可选。这是「划重点」的模型,不是「在纸上画一条线」的模型。
-
模型生成的图表:用户看,不能画。
-
后端能接收图片答案:有个接口支持上传带手写公式、草图的答案图片,但前端没接线——全代码库除了它自己,没有任何地方调用。
如果你要做数学、物理这类需要手写作答的场景,这块得自己补。
七、借鉴意义:六条可以直接搬走的做法
前面讲的都是「它做了什么」。这一节讲「你能拿走什么」。
第一条:业务规则出提示词,进纯函数
判据:如果一条规则你能为它写单元测试,它就不该待在提示词里。
DeepTutor 把「算不算掌握」「下一个学什么」全放进 policy.py——无 IO、无模型调用、输入输出确定。
收益:规则可测、可解释、可审计。用户问「为什么说我没学会」,你能量出 0.82 和门槛 0.9 给他看。
适用:任何有「达标 / 不达标」判定的产品——风控、认证、健康计划、客服质检。
第二条:推进靠计算,不靠游标
不要维护「当前第几步」。每次从「哪些已完成」重新推导「下一个是什么」。
收益:跳学、提前测过、回头补漏、中途插入新目标,全都不需要状态迁移。用户走任何非常规路径都是对的。
前提:目标数量在百级以内。上千个目标时,需要在纯函数前加一层索引。
第三条:不可变证据 + 可重算状态
只追加「发生了什么」,把「现在什么水平」当作可以随时重算的缓存。
DeepTutor 里,mastery_levels(掌握度)是算出来的,learning_evidence(学习证据)才是事实。
收益有三个:
-
换算法不用数据迁移,重算就行;
-
误判可修复——把那条证据标为「作废」,重新算;
-
投影表坏了能从证据重建。
注意:证据会无限增长,需要归档策略。DeepTutor 这块还没做,是个已知的债。
第四条:答案留在服务端
凡是「模型不该看到」的数据——答案、评分标准、别人的记录——都存服务端,只把 ID 投影给模型。
收益:泄漏面从「概率问题」变成「结构上不可能」。
配套:投影函数要显式写,别靠「模型传参时记得别带上」这种约定。
第五条:给违规行为留合法出口
这条最容易被忽略,但很实用。
模型想作弊(或者说「想让用户满意」)时,如果你不给它正规动作,它就开始编——「你其实已经掌握了」「这道题算你对」。
DeepTutor 留了四个出口:跳过这题(不给分)、作废这次判定、推迟这个知识点(不算掌握)、记录「讲过了」(不授予掌握)。
关键点:这些工具都不改变认证状态。 它们给的是「体面地继续」,不是「绕过门槛」。
收益:模型卡住时有路可走,不会陷入编造或死循环。这比在提示词里写十遍「不要谎报」有效得多。
第六条:阶段边界用代码强制,别用提示词请求
「出完题就结束」这件事,DeepTutor 是代码保证的:出题工具一返回,运行时直接以空正文结束本轮。
为什么不能只靠提示词?因为这类失败模式的后果是「用户看到混乱输出」——模型先写「我们来做这道题:」,调完工具又写「请选择 A/B/C/D」,重复两遍。
判据:如果某个失败模式会让用户困惑,就值得用代码兜底;提示词只负责让模型理解规则、减少触发。
顺带说一个很聪明的做法:他们给模型定了一条能被自动检查的规则——「如果你这一轮的话以冒号结尾,那么这一轮必须出题」。冒号意味着「下面就是那道题」。这条规则不需要模型理解语义,写个正则就能验。
给模型一条它能自己验证的规则,比给它一段抽象要求有效得多。
八、别照抄的地方
最后说说这套方案的成本,不然容易读成软文。
① 写放大。 每次保存都重写整个状态 JSON。一个 60 知识点、积累几百条证据的路径,序列化成本会随历史线性增长。当前没有证据归档机制。
② 双写不一致。 状态 JSON 和证据投影表在同一事务里写(这点对),但题目交互表的状态流转是独立写入的。极端情况下可能出现「交互记录显示已批改,但主状态里没这条证据」。恢复机制能兜住大部分,但不是数据库级保证。
③ extra="ignore" 的静默丢字段。 模型全部配了这个选项,好处是向前兼容,坏处是字段名拼错不报错,数据悄悄消失。
④ 两套间隔重复并存。 学习路径用的是自研的 FSRS 式调度,练习题库用的是 SM-2 式。两套各自维护到期时间,队列不汇合。这是演进的痕迹,不是设计。
⑤ 门槛的刚性问题。 0.9 的定量门槛意味着至少答 3 次才可能过。对记忆类知识点合理,但对某些学习者可能造成挫败。他们给了两个出口(自称已掌握、推迟),但「自称掌握」不产生证据——UI 必须读「来源」字段才能正确区分,任何漏读的地方都会把两者混为一谈。
九、最后
我想用一句话总结这个项目给我的启发。
它示范了一种把「领域知识」装进 Agent 的方法:不是写更长的提示词,而是把领域里的判断写成可测试的函数,然后让模型去做它真正擅长的事——把结论讲成人话。
在这套结构里,模型负责措辞、举例、追问的角度;代码负责学什么、算不算过、记住什么。
这个分工听着朴素,但它解决了一个很现实的问题:当你需要在生产环境里对一个判断负责时,你不能把判断权交给一个概率模型。
DeepTutor 的教学功能你可以不用,Claude Code、Codex 也照样能用。但它在这两万行里展示的那套工程手法——持久化回合、纯函数策略、不可变证据、服务端持有答案、给违规留出口——几乎可以平移到任何一个需要「有状态 + 可审计」的 Agent 产品上。
这可能才是它 5.4 万 star 里,最该被看见的部分。
如果你还想了解它内部更多的实现细节,可以留言。
参考
-
项目:HKUDS/DeepTutor(v1.7.0,Apache-2.0)
-
论文:DeepTutor: Towards Agentic Personalized Tutoring,arXiv:2604.26962
-
本文所有代码引用基于 v1.7.0 源码,涉及
deeptutor/learning/(13,065 行)与deeptutor/capabilities/mastery/(6,072 行)
我是 Aaron,10 年算法工程经验,每周拆一个 AI 新东西的实现细节。
关注「AI 拆解猿」,每周拆一个 AI 协议、框架、源码或架构,直到你能自己动手。
