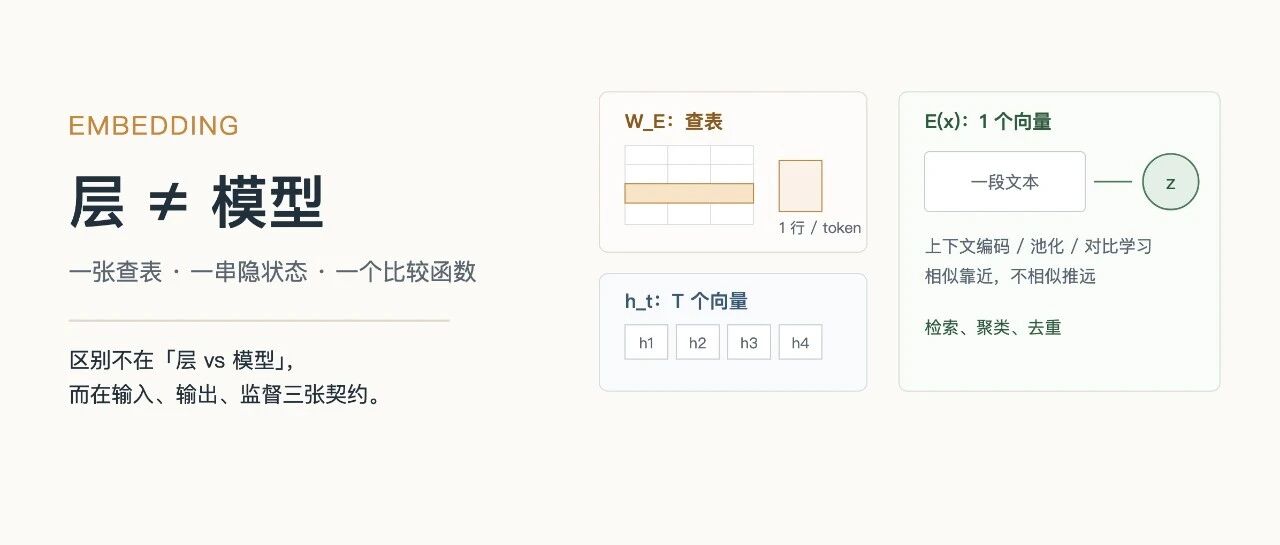
同一个名字,三种东西:一张查表、一串隐状态、一个被训练来比较的函数。
先看一个很容易出现的 RAG 故障。
团队不想再维护一个 Embedding 服务:70B 模型已经在线上跑生成了,直接拿它的第 0 层做向量,不就能省一套模型?于是他们把 70B 的第 0 层截出来,把一段文本的 token 向量平均一下,写进向量库。
结果用户搜「苹果手机怎么重启」,召回一堆「红富士苹果的种植技术」。
团队很困惑:70B、8192 维,怎么会输给几百兆的小模型?
这不是模型不够大,而是把三个同名不同物的东西,混成了一个。
这篇文章只回答一件事:大模型的 Embedding 层、LLM 的隐状态、独立的 Embedding 模型,到底差在哪;工程上又该怎么选。
01 三个都叫 Embedding 的东西
先把它们摆到桌面上。
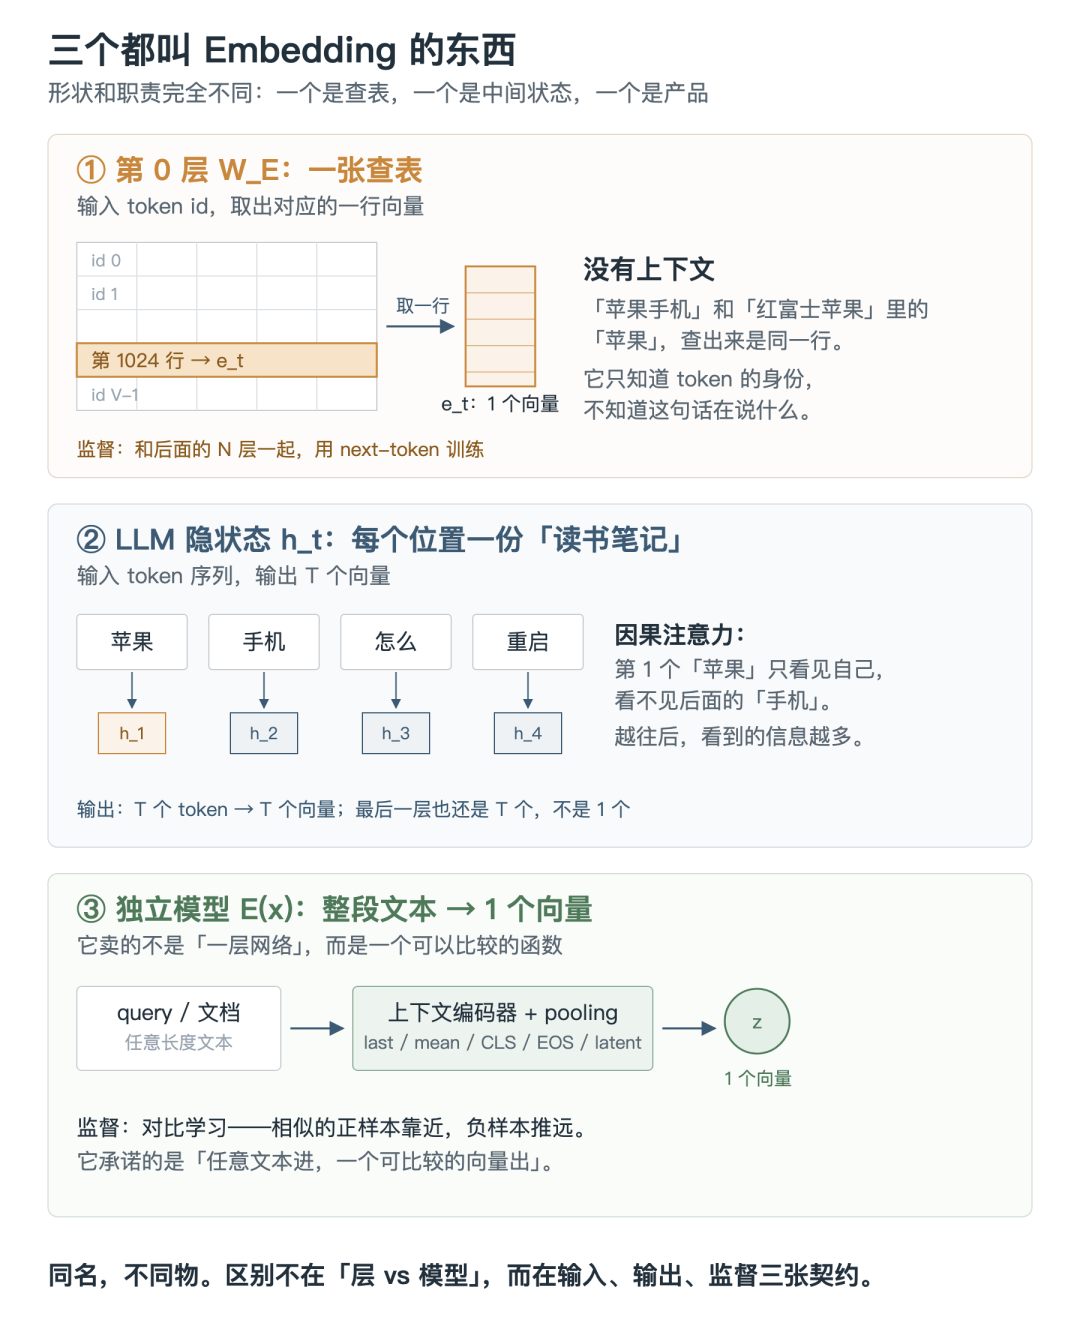
三个都叫 Embedding 的东西
图 1:同名,不同物。一个是查表,一个是中间状态,一个是产品。
第一个:W_E,第 0 层的查表
大模型的第一层,通常是一个 V × d 的矩阵(严格说,这里只讨论 token embedding 的查表,不含位置编码):词表有 V 个 token,每个 token 对应 d 维向量。
输入不是一个词,而是一个整数 id。模型拿这个 id 去矩阵里取第几行:
e_t = W_E[token_id]所以它本质上是一张查表。token_id = 1024 取第 1024 行,token_id = 1025 取第 1025 行。
它没有上下文。「苹果手机」里的「苹果」和「红富士苹果」里的「苹果」,如果 tokenizer 切出来是同一个 id,查到的就是同一行。
你可能会问:word2vec 不也是一张词向量表吗?
不一样。word2vec 是单独训练出来、可以导出、可以拷贝的静态表;W_E 是大模型的一部分,它和后面的几十层一起初始化、一起反向传播。它的每一行之所以长成那样,是为了让后面的注意力层和 MLP 更好地预测下一个 token,不是为了让你算「苹果」和「香蕉」的余弦。
它是一块「工作内存」,不是一本「语义词典」。
第二个:h_t,LLM 的隐状态
把 token 序列喂进模型,每经过一层,每个位置都会输出一个 d 维向量。第 t 个位置的向量,记作 h_t。
注意单位:T 个 token,还是 T 个向量。
它和 W_E 的区别是:h_t 有上下文。比如第 2 个位置的「手机」,经过几层注意力,已经看到了前面的「苹果」;它的向量会同时带着「苹果」的信息。但它仍然是「每个位置一个向量」,不是「整段文本一个向量」。
而且,LLM 是因果的:第 t 个位置只能看 1…t,不能看后面。第 1 个位置的「苹果」只知道自己;最后一个位置才看全句。
这带来一个很关键的后果,后面会展开:同一句话里,不同位置的向量,信息量是不一样的。
第三个:E(x),独立的 Embedding 模型
独立模型对外承诺的事情很简单:
输入:一段任意长度的文本
输出:一个 d 维向量
你给它一句 query,它给你一个向量;你给它一篇文档,它给你一个向量。然后你拿两个向量算余弦,判断它们像不像。
它内部可能是一个 BERT,也可能是一个 7B 的 decoder;可能有 12 层,也可能有 28 层。这些都不重要。重要的是它被训练来完成「文本 → 一个可比较的向量」这件事。
为了做到这一点,它通常要做三件事:
-
把 tokenizer 包进来,直接吃文本,而不是让你传 token id;
-
把 T 个 token 向量压成一个文本向量,也就是 pooling;
-
用对比学习训练,让相似的正样本靠近,不相似的负样本推远。
这三件事,正好对应三张契约。很多模型还会去掉因果掩码,让每个 token 看到整句;但这不是定义,后面会讲。
为什么都叫 Embedding?
因为这个词在过去十年里,外延变了三次。
-
word2vec 时代:embedding 是一张词向量表,一个可以导出的文件;
-
BERT 之后:embedding 是「跑一遍模型得到的上下文向量」,同一句话换一个上下文就变;
-
SBERT / RAG 之后:embedding 是「一段文本对应一个向量」的产品,是向量库里的那条记录。
名字没变,东西变了三次。所以当有人说「大模型的 embedding 更好」时,你首先要问:你说的是第 0 层、最后一层,还是某个独立模型输出的那个向量?
这三个东西,输入、输出、监督都不一样。
02 第一张契约:进去的是 token id,不是文字
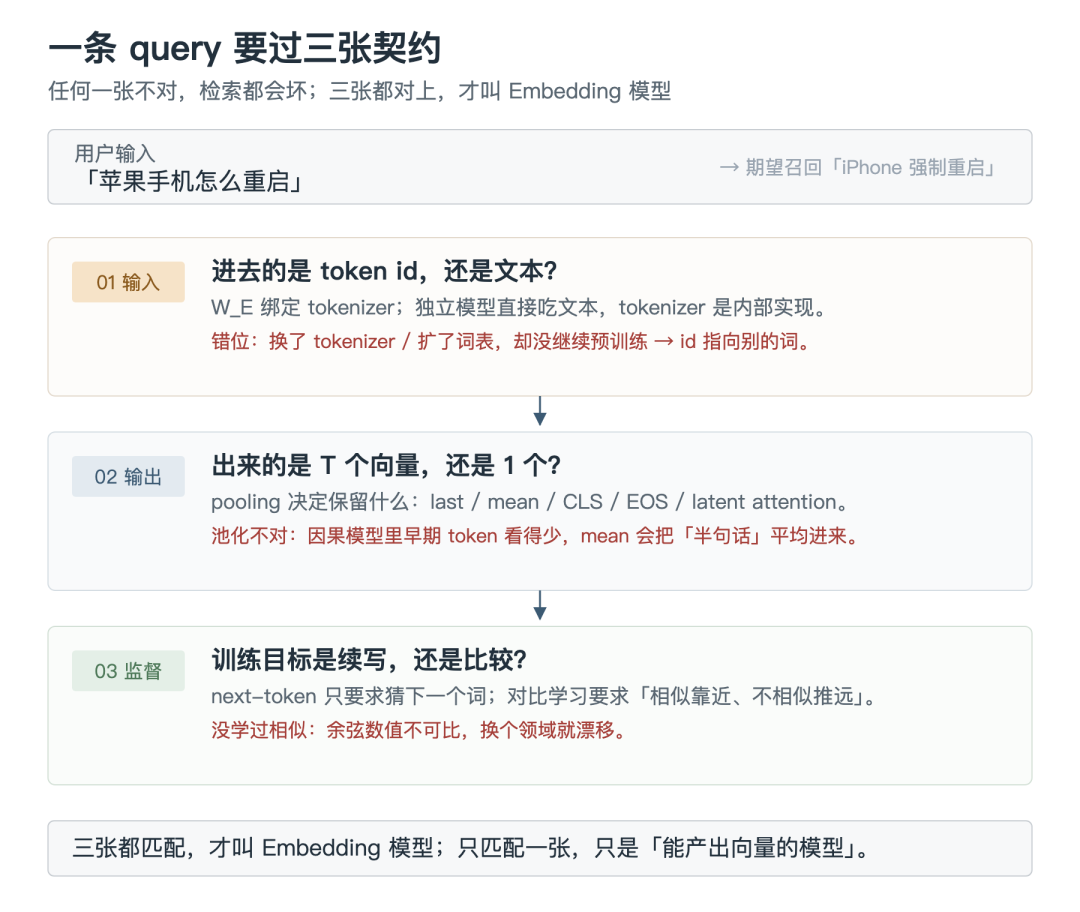
三张契约
图 2:一条 query 要过三张契约;任何一张不对,检索都会坏。
W_E 的输入不是「苹果」这两个汉字,而是 tokenizer 切出来的整数 id。
同一句话,不同的 tokenizer 会切出不同的 token 序列。比如「苹果手机怎么重启」,有的 tokenizer 会切成「苹果 / 手机 / 怎么 / 重启」,有的会切成「苹果 / 手 / 机 / 怎么 / 重 / 启」,还有的会把常见词合并成一个 token。
切法不同,id 就不同;id 不同,查出来的行就不同。
你可以把 W_E 想成一家酒店的房号表:1024 号房住的是谁,取决于这家酒店的前台怎么登记。换一家酒店,1024 号房可能住着完全另一个人。
所以:
-
W_E和 tokenizer 是绑定的。换 tokenizer 不换表,等于把行号全部打乱; -
不能把 A 模型的
W_E拼到 B 模型上。就算形状碰巧一样,id 的语义也对不上; -
扩词表不是「加几行」就完事。新加的行要和旧行处在同一个坐标系里,必须继续预训练,让新向量去迁就旧空间。
独立模型不一样。它对外承诺的是「任意文本」,tokenizer 是它的内部实现。你不需要知道它怎么切词,也不需要把 id 传给它。
这就是第一张契约的差别:一个是模型内部零件,只认自己家的 id;一个是面向用户的产品,直接吃文本。
03 第二张契约:出来的是 T 个向量,还是 1 个
W_E 输出 T 个向量,LLM 每一层也输出 T 个向量,独立模型对外输出 1 个。这里说的是单向量模型;ColBERT 这类多向量模型是另一条路线,输出的是 T 个向量。
中间那一步叫 pooling,中文常叫「池化」。它不是免费的,也不是随便选一个就行。
| 池化方式 | 怎么做 | 优点 | 坑 |
|---|---|---|---|
| last token | 取最后一个位置 | 简单;最后一位看到了全句 | 它是「下一个 token 的查询」,不是「全句摘要」 |
| mean | 所有位置平均 | 稳定、无参数 | 因果模型里,早期位置看得少,等权平均有偏 |
| CLS | 取专门的分类位 | BERT 系常用 | 需要预训练时就有这个位;decoder 模型没有 |
| EOS | 取结束符位置 | E5-Mistral、Qwen3 等常用 | 依赖模板和结束符 |
| latent attention | 学一组 query 做加权 | NV-Embed 报告优于 mean / EOS | 多一组参数,训练要配套 |
因果注意力:同一个词,在不同位置信息量不同
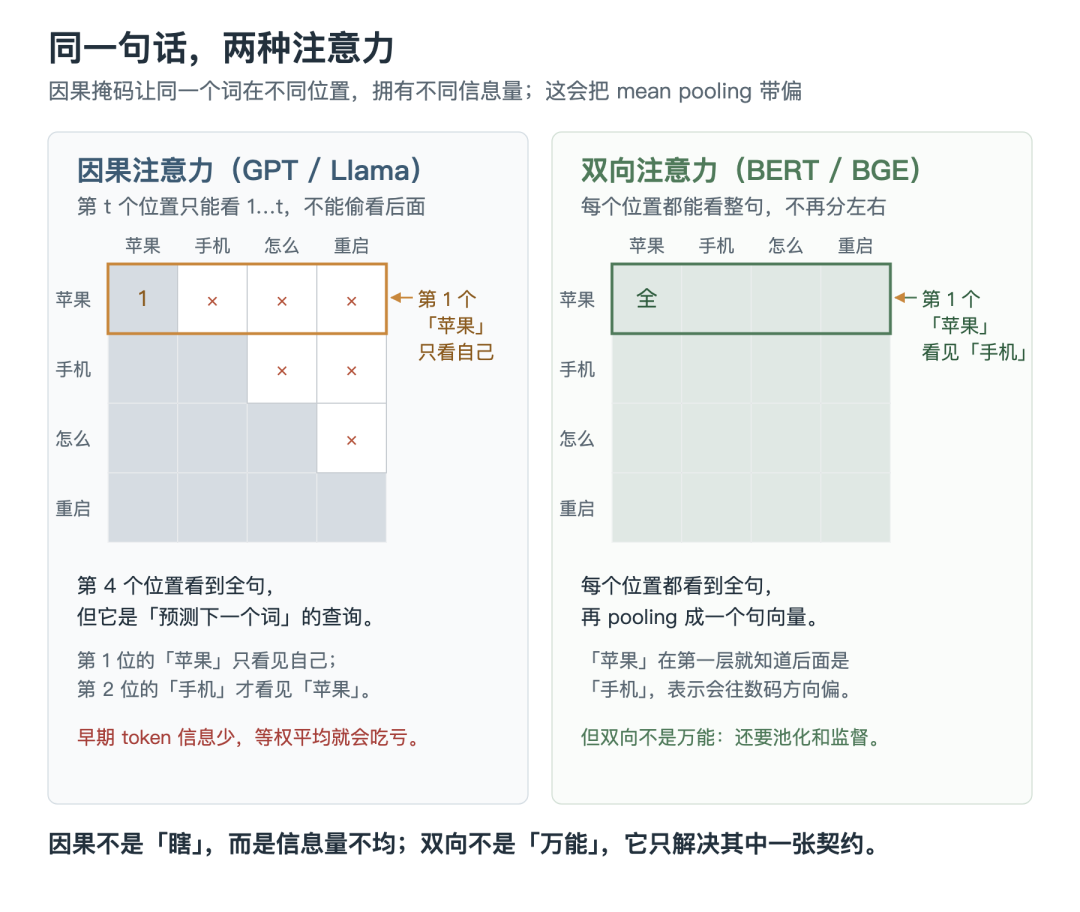
因果与双向注意力
图 3:因果模型里,第 1 个「苹果」只看见自己;双向模型里,它第一层就看见了「手机」。
在 GPT / Llama 这类因果模型里,第 t 个位置只能看 1…t。
所以第 1 个位置的「苹果」,只带着这个 token 的静态含义,永远看不见后面的「手机」;到了第 2 个位置,「手机」才看见前面的「苹果」,表示开始往数码方向偏。
最后一个位置确实看到了全句。但它的训练任务是「拿这个位置的向量,预测下一个 token」。所以它是「下一个 token 的查询」,不是「整段文本的摘要」。
这句话很重要:最后一个位置的表示不是摘要,它是「接下来要说什么」的查询。
也正因如此,同一个前缀,最后一个位置的向量在推理时是固定的:它不知道你实际会接「。」还是「然而」;模型拿它算出的,是下一个词的概率分布。它编码的是「到此为止的上下文」,不是「后面实际发生了什么」。但它的几何,是被「预测下一个词」塑形的,不是被「两句话是否相似」塑形的。
mean pooling 为什么会偏?
把 h_1 到 h_T 等权平均,等于把「半句话的表示」和「整句话的表示」混在一起。
短句影响小;长文档影响大。文档越长,早期位置和末位的「信息量差距」越大,mean pooling 的偏差越明显。
这就是为什么在保持因果注意力的前提下,decoder-based embedder 更常用 last / EOS / latent pooling,而不是无脑 mean。
双向不是教条
很多独立模型确实用双向注意力:BERT、BGE、LLM2Vec 都是这个路子。每个 token 从第一层就能看到整句,「苹果」在第一层就知道后面是「手机」,表示会更准。
但双向不是定义。Qwen3-Embedding 这类 decoder 底座模型也可以很强;它靠指令、对比学习和合适的池化把差距补回来。
所以别把「必须双向」当成教条。双向只是常见做法,真正决定句向量质量的,是池化 + 监督 + 领域匹配。
04 第三张契约:训练目标是续写,还是比较
这是三张契约里最核心、也最容易被口号化的一张。
next-token:目标里没有「相似度」
大模型的预训练目标很单一:给定前 t 个 token,预测第 t+1 个 token。
它的损失函数只关心「下一个词的概率」,不关心「两句话的余弦是否可比」。
这个目标会逼模型学语法、事实、推理,也会逼它把高频词的基准分维持住;但它从来没有要求「任意两句话的向量要能比较」。
所以,你从 LLM 里抽出来的向量,可能包含很多信息,但它的「坐标系」不是为相似度校准的。
顺带说一句 W_U:它是输出侧的反嵌入矩阵,把隐状态变回词表上的打分。W_E 是输入侧查表(V × d),W_U 是输出侧反嵌入(d × V),两者形状互为转置,但作用相反。
有些模型让 W_U = W_E 的转置(权重绑定),有些让它们各自独立。绑不绑是配置问题,不影响「它的列是下一个词的原型」这个事实。
对比学习:把「像」写进损失
独立模型换了一张损失,最常用的是对比学习。
它一次看一批数据:一个 query、一个正样本、一堆负样本。
-
正样本:和 query 语义相同或相关的文本;
-
负样本:batch 里其他不相关的文本;
-
目标:让 query 和正样本的向量靠近,和负样本的向量推远。
用一句话概括:
正样本拉近,负样本推远。如果没有负样本,模型有一个最省力的解:把所有文本都映射到同一个点,loss 直接归零。这就是「表示坍缩」。负样本是那个「不许塌」的约束。
用公式写,大概是:
loss = -log( exp(sim(q, k+) / τ) / ( exp(sim(q, k+) / τ) + Σ exp(sim(q, k-) / τ) ) )分母里既有正样本,也有所有负样本。其中 sim 是余弦相似度,τ 是温度。温度小,梯度更集中在最难的负样本上;温度大,梯度更平滑。
但工程上真正决定效果的,往往不是这个公式,而是数据:
-
batch 够不够大,负样本够不够多;
-
有没有难负例(表面相关、语义不同);
-
query 和文档的长度、分布是否对称;
-
有没有指令前缀,把任务信息告诉模型。
「独立」不是架构,是契约
独立 Embedding 模型可以基于 BERT,也可以基于 LLM。
BGE 用 BERT 编码器 + 对比学习;LLM2Vec 去掉 Llama 的因果掩码,加 MNTP 和 SimCSE;NV-Embed 用 latent attention pooling;E5-Mistral 和 Qwen3-Embedding 用任务指令 + 对比学习。
它们改的都是三张契约里的某几张,而不是从零发明一种网络。
所以「独立」不是一个架构名词,而是一个产品承诺:输入文本、输出一个向量、用相似度监督训练过。
05 70B 的第 0 层,为什么打不过 300M 的 BGE?
把三件事分开看,答案很清楚。
| 70B 第 0 层 | 300M BGE | |
|---|---|---|
| 参数量 | 700 亿(整模) | 3 亿 |
| 这一层看到什么 | 一个 token id | 整段文本 |
| 上下文 | 无 | 双向 |
| 输出 | T 个向量 | 1 个向量 |
| 监督 | next-token | 对比学习 |
| 文本级召回 | 词级、静态 | 为相似度训练 |
第 0 层只有「词身份」,没有上下文。它的参数量可能并不小(词表 × 维度),但仍然只是一张查表;70B 的理解力在中间层和最后一层,不在第 0 层。
就算你取最后一层,它仍然缺 pooling 和相似度监督。
打个比方:
-
70B 的第 0 层像一本巨大的字典,每个字都有一个坐标,但它不会读句子;
-
300M 的 BGE 像一个专门训练过的编辑,读完一段话,写一句摘要,而且知道哪些摘要应该放在一起。
参数是容量,契约是对齐。容量再大,方向不对也白搭。
但也不要反过来说「大模型没用」。
如果你把 70B 的最后一层拿出来,加池化、做对比微调,它可能很强。LLM2Vec、NV-Embed 就是干这个的:它们把 LLM 改造成 Embedding 模型,而不是简单抽一层。
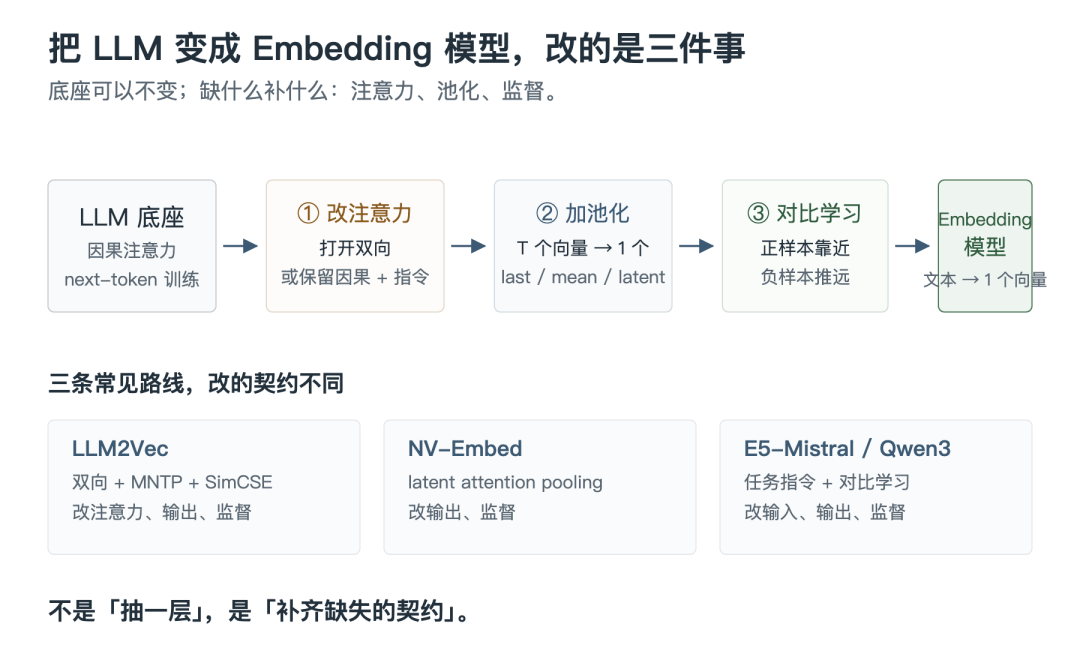
把 LLM 变成 Embedding 模型
图 4:不是「抽一层」,是「补齐缺失的契约」。
成本账也同样不站在 70B 这边:
-
7B 模型半精度加载就要 14GB 显存;
-
70B 更是另一个数量级;
-
8192 维向量写进索引,存储和检索成本都远高于 1024 维;
-
换模型还要全量重建索引。
这也解释了为什么工业界常见的做法不是「直接上 70B」,而是「7B 当老师蒸馏 0.5B」或者「MRL 截断 + 量化」。
06 那为什么有人说「LLM 向量很好用」?
因为大家说的不是同一个东西。
有人说「最后一层平均池化效果不错」,也有人说「一塌糊涂」。两个人都可能没说谎,只是条件不同:
-
用的是第 0 层,还是最后一层?
-
用的是 last、mean、CLS,还是 EOS?
-
有没有做白化、减均值?
-
在通用数据上评,还是在垂直领域评?
-
有没有 rerank 兜底?
-
用的是原始 LLM,还是已经做过对比微调的 LLM2Vec / NV-Embed?
所以「LLM 向量能不能用」不是一个是非题,而是一个条件题。
如果你手上只有 LLM,想判断它的向量能不能用,可以按这个顺序试:
-
先对比 last-token 和 mean:看 Recall@10 差多少;差距大,说明池化是主要矛盾;
-
再试减均值 / 白化:判断是不是公共分量或流氓维度;
-
在你的领域数据上评:不要只看通用榜单;
-
还不够,再做对比微调:LoRA + 正负样本,成本通常比换底座低;
-
最后才换独立模型:因为换模型意味着重建索引。
这个顺序能帮你分清:到底是模型不行,还是池化不对,还是根本没做相似度训练。
07 各向异性:圆锥是真的,但它不是主凶
聊完池化和监督,再拆一个最常见的背锅侠:各向异性。
你可能听过一个很流行的说法:
大模型训出来的向量,全都挤在一个狭窄的圆锥里,余弦都在 0.9 以上,所以 ANN 检索瞎了。
这句话对了一半:现象是真的,机制是错的,处方也跟着错。
高维余弦,本来就该接近 0
先把「随机向量」拿出来看。
在 d 维单位球面上均匀撒点,两两算余弦,均值为 0,标准差约为:
1 / √dd = 8192 时,标准差只有 0.011。
也就是说,随机向量的余弦本来就该接近 0,而不是 0.9。
反过来说,如果你观察到 0.9,通常意味着两件事之一:有一个非随机的共同分量,或者样本本身高度同质。前者就是「各向异性」这个词的来源。
圆锥:余弦被抬高,但排序没坏
假设每个向量都由两部分组成:
-
一个语义部分
x_i; -
一个所有样本共享的方向
u。
把它们加起来再归一化,就得到一个圆锥:所有向量都朝同一个方向偏。
数学上可以证明:如果公共分量和语义子空间正交,且各样本的语义部分范数一致,那么公共分量只是把余弦整体抬高,是一个单调重参数化;按余弦排序和按语义部分排序,结果一样。
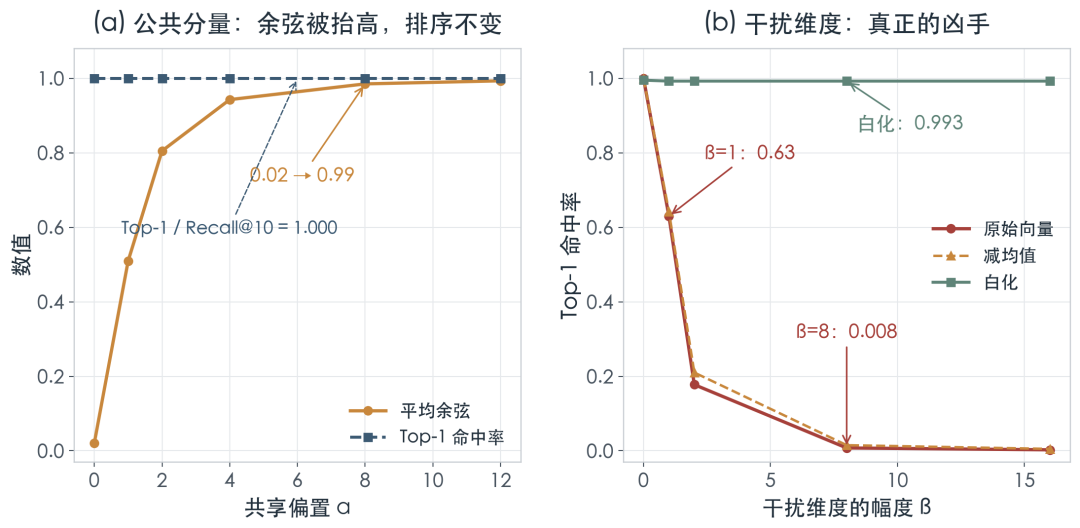
我们用 128 维、40 个主题、3000 条样本做了个实验,逐步加大共享偏置。
公共分量与干扰维度
图 5:左图,公共分量把平均余弦从 0.02 抬到 0.99,但 Top-1 / Recall@10 一点没动;右图,真正的凶手是少数干扰维度。
平均余弦从 0.02 涨到 0.99,Top-1 和 Recall@10 仍然是 1.000。这个实验的语义簇分得很开,检索本来是满分;要看的是排序有没有被改变。
这就是「现象是真的,机制是错的」:在这个受控实验里,圆锥确实存在,但它没有改变排序。它真正的危害在后面:把名次之间的间隔压小,让精度和量化开始决定结果。
真凶一:少数「流氓维度」
在一些真实模型里,少数几个维度会主导余弦,可能只有 1~3 个。它们和语义无关,但方差特别大,会把其他维度的差异压过去。
我们做了个隔离实验:让语义住在第 031 维,在第 4043 维放与主题无关、幅度为 β 的随机噪声。
结果:
-
β = 1,Top-1 掉到 0.63; -
β = 8,Top-1 掉到 0.008,基本归零; -
β = 16时,原始向量只剩 0.0025,减均值也只修到 0.005,几乎没用; -
同一组
β = 16的数据,白化修到 0.993。
为什么减均值没用?因为伤害不在均值里,而在协方差里。白化把协方差矩阵变成单位阵,把方差特别大的方向按比例压回去,所以有效。
但白化也有边界:它假设「方差大 = 不重要」。真实模型里不一定成立,而且估协方差需要足够多的样本。
真凶二:存储精度
还有一个更工程化的凶手:精度。
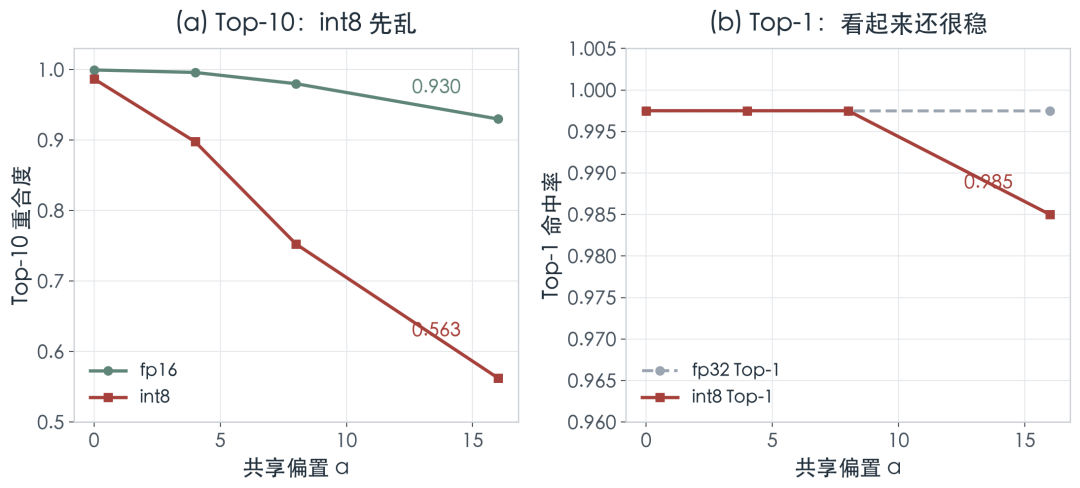
同一批向量、同一套排序逻辑,只把存储精度从 fp32 换成 fp16 和 int8:
精度实验
图 6:α = 16 时,int8 的 Top-1 还有 98.5%,但 Top-10 的重合度已经掉到 0.563。
-
α = 16时,fp16 的 Top-10 重合度还有 0.930; -
int8 只剩 0.563;
-
但 int8 的 Top-1 还有 0.985。
为什么 Top-1 看起来还稳,Top-10 已经乱了?
因为名次之间的真实差距,比浮点分辨率还小:
Top-1 与 Top-2 的余弦差(中位数):约 5.3 × 10^-5
fp16 的有效分辨率(半间隔):约 4.9 × 10^-4
int8 的量化步长:约 7.9 × 10^-3
圆锥本身不改变排序,但在实验里,它把名次之间的间隔压到了浮点分辨率以下。于是「用什么精度存」开始决定「谁排第一」。
处方:先分清是哪一种病
-
公共分量:减均值、白化;几乎免费,但只治这一种;
-
流氓维度:白化(样本要够)、或重训;白化不是万能;
-
精度:fp32 存、分组量化 / 残差量化,或先降维再量化;
-
域漂移 / 池化:换池化、领域微调、混合检索、加 rerank。
顺序很重要:先分清病,再开药。 不要把所有问题都叫「各向异性」。
流形视角:一个解释框架
还有一个更上层的视角:真实文本不在 d 维空间里均匀填充,而是集中在一个内在维度低得多的曲面上。
三维空间里一张揉皱的纸是最好的类比:纸是二维的,但它在三维里被折叠;要描述纸上两点的「真实距离」,得沿着纸面走。
这个「沿着纸面走」的距离叫测地距离。我们常用的余弦相似度看的是夹角,归一化后的欧氏距离看的是弦长;在单位球上,两者是同一件事的两种刻度。它们和测地距离,只在局部近似。
这解释了三个工程动作的必要性:
-
分块:把文档切成语义内聚的块,让局部平坦假设更接近成立;
-
混合检索:BM25 和元数据过滤提供「绝对坐标」,不依赖方向;
-
重排:cross-encoder 把 query 和文档拼在一起过一遍注意力,绕开「各自压成一个点再算距离」的有损步骤。
但要说清楚边界:流形视角是一个解释框架,不是可优化的目标函数。很难把「测地距离」直接写进损失里去训,在线计算它的成本也很高。
08 「生成就是检索」,这句话对吗?
形式上对,契约上不对。
生成下一个 token 时,模型会算:
p(下一个词) = softmax(h · W_U / τ)把 h 当成 query,把 W_U 的每一列当成 key,这确实是一次「软化的原型匹配」:打分是内积,输出是 softmax 后的排名。只有把两边都归一化,它才更接近余弦最近邻。
这个类比很漂亮,也能解释幻觉:模型从 W_U 里检索到了一个语法通顺但事实错误的词。
但它不是「检索模型」,原因有三条:
-
W_U的列是输出原型,不是文档库。 它们代表「下一个词长什么样」,不是「一篇文档的语义」。词表是封闭的、离散的;文档库是开放的、连续的。 -
内积不是余弦。
W_U的列范数没有被归一化,范数大的词天然占便宜;这种偏置和词频相关,不是语义相似度。 -
没有对称性和校准。 检索通常希望
s(q, d) ≈ s(d, q),至少要求不同 query 之间的分数可比;next-token 目标不要求这两件事。
真正的「生成式检索」是另一套:DSI 这类方法把文档 id 当成 token 来生成;RETRO 这类方法先用检索器取文档,再拼进上下文。它们都不是「拿 h 去 W_U 里查文档」。
所以,「生成就是检索」是一句好的直觉,不是一条好的工程结论。
09 Embedding + N 层,是不是广义的 Embedding 模型?
这是理解两者关系时最有意思的一个追问。
答案是:形式上可以这么切,契约上还没完成。
把模型在第 k 层切成两半:
-
左半边:tokenizer +
W_E+ 前k层,输入文本,输出T × d的隐状态; -
右半边:后
L-k层 +W_U,输入隐状态,输出下一个 token 的概率。
左半边确实是一个「编码器」:它把文本变成向量序列。
k = 0 时,它就是 W_E;k = L 时,它就是最后一层隐状态。任意 k 都能切。
但要把它变成「Embedding 模型」,还差两步:
-
pooling:把
T × d压成d,否则你输出的是「每个 token 一个向量」,不是「一段文本一个向量」; -
监督:加对比学习(或至少加一个为相似度设计的头),否则这个向量只是「能算」,不是「能比」。
而且,只要不改注意力掩码,切点就不会改变「因果」这件事:左半边的每个 h_t 仍然只看见 1…t。所以它是因果编码器,不是双向编码器。
一句话总结:
LLM 是一个「可以切出编码器的生成模型」;Embedding 模型是一个「三张契约都对齐的编码器产品」。
两者交集非空,但不等价。
10 工程选型:先问契约,再问成本
如果你只记一张表,记这张。
| 场景 | 建议 | 原因 |
|---|---|---|
| RAG 召回 / 语义检索 | 独立 Embedding 模型 + rerank | 监督和输出契约对口 |
| 聚类 / 去重 | 独立模型 + 白化 | 对阈值敏感,先看分布 |
| 分类 / 回归 | 独立模型 + 线性头 | 训练成本低,部署简单 |
| 离线探索 / 可解释性 | LLM 隐状态 + 池化 + 白化 | 没有线上延迟约束,可以省事 |
| 词级相似 / 静态词表 | W_E |
词级、静态,够用就好 |
| 生产 RAG 直接用第 0 层 | 不建议 | 输入要自己接 tokenizer;输出、监督两张契约不匹配 |
成本账
-
1000 万条 × 4096 维 × fp16,约 82GB;
-
1024 维,约 20GB;
-
int8 再除以 2;
-
7B 模型半精度加载就要 14GB 显存;
-
300M 的 BGE,一张 A10 通常就够用。
常见折中:
-
蒸馏:7B 当老师,训 0.5B 双向模型;
-
MRL 截断:前 128 / 256 / 512 维独立可用;
-
量化:int8 + 重排补精度。
顺序通常是:先降维,再量化;先蒸馏,再谈上大模型。
迁移成本
还有一笔很容易被低估的账:离线建库和在线编码必须用同一个模型、同一个版本、同一套预处理。
换模型 = 全量重建索引 + 双写灰度。
索引小的时候几乎感觉不到;到亿级时,这就是新模型上线的最大障碍。
所以「随手拿个 LLM 的第 0 层来用」的真实代价,往往不在第一天的效果,而在后面每一次模型迭代时的迁移成本。
30 秒自检
下次要选型,先问五个问题:
-
你的输入是 token id,还是任意文本?
-
你的输出是一个向量吗?这个池化方式训练过吗?
-
你的监督目标里有「相似度」和负样本吗?
-
换模型要重建索引吗?预算够吗?
-
有没有 rerank、混合检索兜底?
如果五个问题里有三个答不上来,先别换更大的模型。
最后,三句话带走
-
W_E是模型内部的一张查表,h_t是模型读到某个位置的笔记,E(x)是专门训练来比较文本的函数。 -
它们的区别不在「层 vs 模型」,而在输入契约、输出契约、监督契约是否匹配你的任务。
-
参数是容量,契约是对齐。 不是大模型不行,是它没被要求做这件事。
下次有人再说「大模型的 Embedding 更强」,你可以先问一句:
你说的是哪一层?用什么池化?拿什么目标训的?
这三个问题,比「多少 B」更能决定它能不能用。
延伸阅读
-
Reimers & Gurevych, Sentence-BERT, 2019.
-
Gao et al., SimCSE: Simple Contrastive Learning of Sentence Embeddings, 2021.
-
BehnamGhader et al., LLM2Vec: Large Language Models Are Secretly Powerful Text Encoders, 2024.
-
Lee et al., NV-Embed: Improved Techniques for Training LLMs as Generalist Embedding Models, 2024.
-
Wang et al., Improving Text Embeddings with Large Language Models, 2024.
-
Zhang et al., Qwen3 Embedding, 2025.
-
Timkey & van Schijndel, All Bark and No Bite: Rogue Dimensions in Transformer Language Models, 2021.
-
Ethayarajh, How Contextual are Contextualized Word Representations?, 2019.
-
Kusupati et al., Matryoshka Representation Learning, 2022.
-
Press & Wolf, Using the Output Embedding to Improve Language Models, 2016.
注:图 5、图 6 是合成数据上的机制隔离实验,用来观察因果关系,不是 MTEB 榜单分数;真实模型的数字会受底座、数据、池化和领域影响。
我是 Aaron,10 年算法工程经验,每周拆一个 AI 新东西的实现细节。
关注「AI 拆解猿」,每周拆一个 AI 协议、框架、源码或架构,直到你能自己动手。
