10 月 20 日,DeepSeek 开源了内部推理框架 DeepInfer 和 Token 编解码组件 deepseek-recipe。
同时罕见地公布了一组运营数据:单一集群每天吞吐 155 万亿个 token,每卡每小时收入 38 美金。
模型开源我们见过很多次了。但把「怎么便宜地把模型跑起来」这套吃饭家伙,连同成本账本一起交出来,这是头一回。
先搞清楚:推理框架到底是干嘛的
打个比方。大模型像一位手艺极好的厨师,会做菜,但一位好厨师不等于一家好餐厅。
如果你开的是一家每天接待几百万人、每道菜要求几秒内上桌的餐厅,你需要的就是一整套后厨调度系统。
订单怎么排队、食材怎么提前备好、八个灶台怎么才不空转。推理框架(inference framework)就是这套后厨系统。
它不决定 AI「会做什么」——那是模型的边界。它决定这件事的成本:同样一张 GPU 卡,能同时服务多少人、用户平均等多久、电费和折旧摊到每一次回答上是几毛钱。
DeepSeek 的原话说得比这文雅:「训练使模型学有所成,推理则让模型为人所用。」
这句话背后是真金白银。用户的每一次对话都跑在推理框架上,框架效率差一倍,服务成本就差一倍。所以这次开源的分量,要看放进 DeepSeek 整个开源版图里才清楚。
过去两年,这家公司已经交出了:模型层(V3、R1 到 V4 系列的开放权重)、算子层(FlashMLA、DeepGEMM、DeepEP、TileKernels)、编译层(TileLang)。
这次补上的是最后两块:推理框架 DeepInfer,以及 API 编解码层 deepseek-recipe。从模型到算子到编译器到框架再到 API,开源版图基本闭环了。
一句话:DeepSeek 交出来的已经不只是一条鱼,而是鱼塘、饲料配方和养鱼手册。
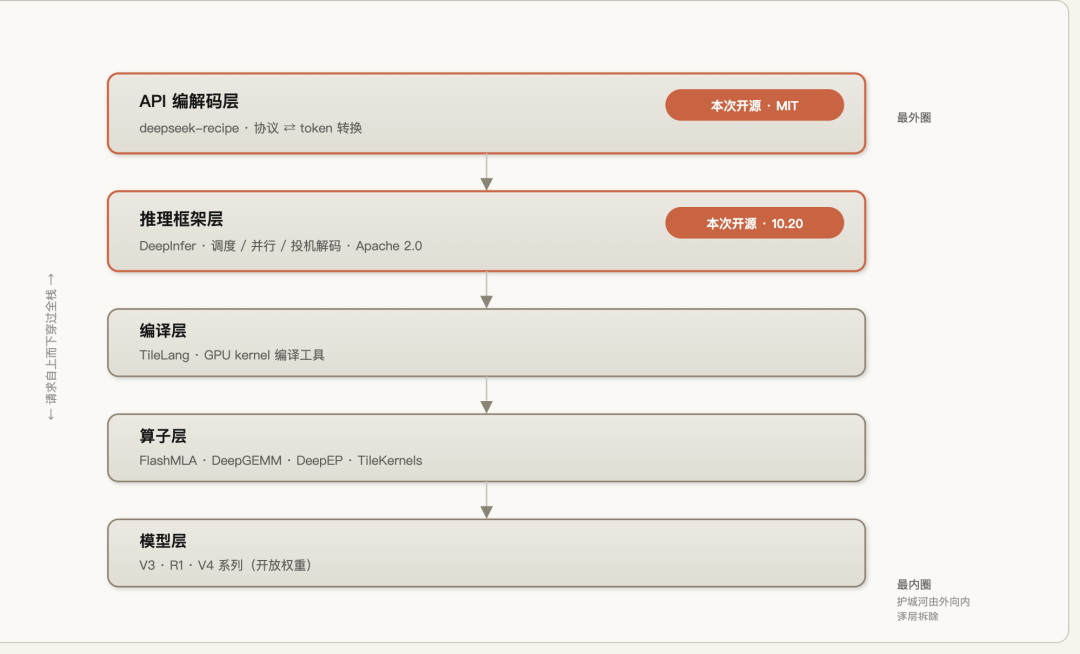
图1:DeepSeek 开源版图五个层次
两个数字:155 万亿 token,每卡 38 美金
先看第一个数:单一集群每天 155 万亿 token 的吞吐。这是全球最顶级的单集群推理规模之一。
再看第二个数:每卡每小时 38 美金收入(按谷价计算,约合人民币 254 元)。换算一下,一张卡满负荷跑一天收入约 6091 元,一个月约 18.6 万元。
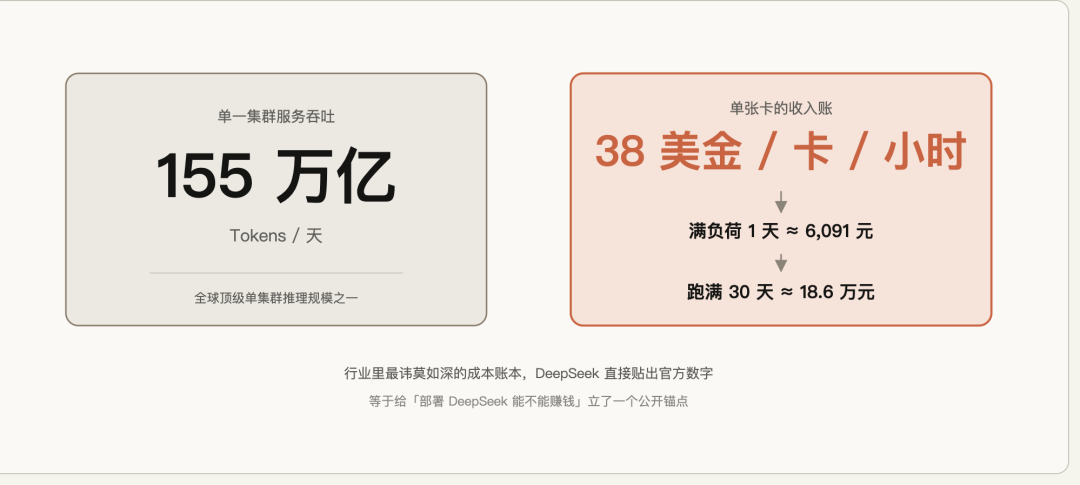
图2:DeepSeek 公布的推理账本
我认为这两个数字才是这次发布里最「刺激」的部分,比代码本身刺激。
原因是:GPU 推理服务的成本账本是行业里最讳莫如深的东西之一。一张卡一小时到底能产出多少收入、毛利几何,各家云厂商把它当商业机密捂着。
DeepSeek 直接把官方数字贴出来,等于给整个行业立了一个公开的锚点——「部署 DeepSeek 的模型,产出能做到这个水平」。
敢这么做只有一种解释:对自家成本结构有碾压级的自信。顺便,也给了所有想私有化部署的人一张「能算得清账」的财务底稿。
DeepInfer 里的硬货,拆几个给你看
DeepInfer 是跑 DeepSeek V4.1 Flash 线上服务的同一套框架,Apache 2.0 协议开源,主要基于 vLLM 构建,也借鉴了 SGLang 和 TensorRT-LLM。
下面挑四个最能代表其工程水平的点讲。
先看一张全局图——一次请求从协议进来到 token 流出去,整个系统长这样:
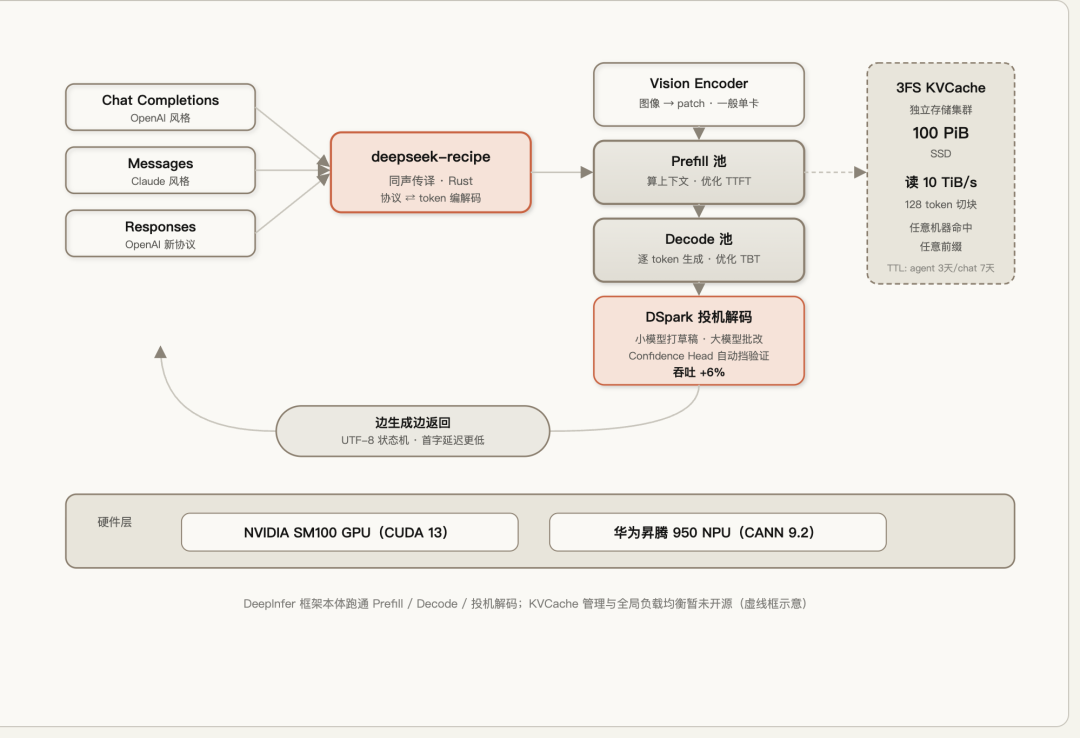
图3:DeepSeek V4.1 Flash 线上推理系统架构
第一个:让「小模型打草稿、大模型批改」学会看菜下饭。
推测解码(speculative decoding)是目前推理加速的主流思路:让一个小模型先一口气「打草稿」写出五六个 token,大模型一次性验证,对的全收,效率大幅提升。
传统做法是固定每次验证 5 个草稿 token,像手动挡汽车。
DeepInfer 的 DSpark 加了个「Confidence Head」:模型自己判断这批草稿靠谱程度,置信度高就多验证几个,没把握就少验证。相当于换成了自动挡。
别小看这一改动,官方数据是吞吐再涨 6%。在 155 万亿 token/天的基数上,6% 约等于凭空多出 9 万亿 token/天的产能。
第二个:一次教科书级的「认怂」。
背景知识:现代模型普遍用滑窗注意力(SWA),只关注最近的上下文,省显存。问题来了——这份滑窗缓存要不要存到磁盘上?存了,万一用户接着聊,就能直接命中,省掉重算。
V4 的做法是存。结果发现:它占掉了近一半持久化缓存容量,命中率收益却换不回来,亏本买卖。
V4.1 的解法很干脆:不存了。没命中就只重算最近 128 个 token(框架里对应的是 SWA Bounded Replay,只重放一个有界后缀)。结果是 Decoder 侧的 prefill 计算量近乎减半。
我认为这是整个技术报告里最有品味的一个决策。工程高手和普通工程师的区别,往往不在于能不能把方案做复杂,而在于敢不敢承认上一版错了,换一条更笨但更便宜的路。
第三个:把 KVCache 搬出家门。
KVCache 是推理的「记忆」,存的是对话已算过的中间结果,命中就不用重算。传统做法放在本机内存里,问题是:用户下一次请求如果被调度到另一台机器,缓存就全废了。
DeepSeek 线上系统的做法激进得多(技术报告披露的设计,对应代码暂未开源,后面会讲):把 KVCache 按 128 个 token 切块,扔到一个独立的 3FS 存储集群上——约 100 PiB 的 SSD,读带宽 10 TiB/s。
这样换来的能力是:任何一台 prefill 机器都能命中任何一份历史前缀。
缓存的保留时长也按业务精细化设置:agent 场景留 3 天,聊天场景留 7 天。这个分配直接指向一个判断——未来的主要负载是 Agent 那种动辄几天的长会话,而非一问一答的短对话。
两个关键取舍(3FS 搬家 + SWA 认怂),画成一张对比图是这样:
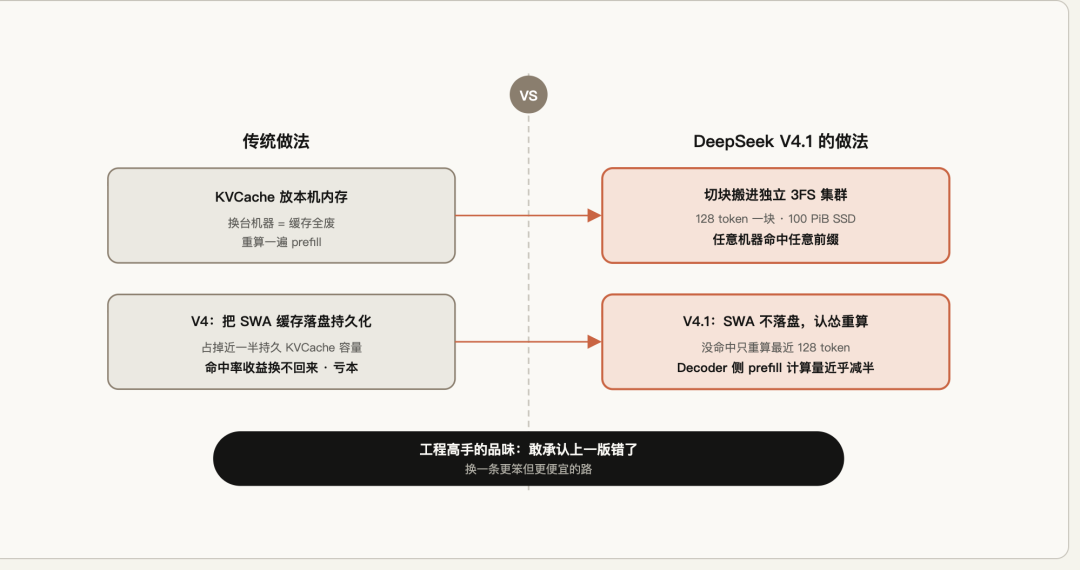
图4:KVCache 的两次关键取舍
第四个:对「可复现」的偏执。
一个很少被媒体报道的细节:DeepInfer 支持 batch-invariant 推理(不管 batch 里混了哪些请求,每个请求的结果都一模一样)和确定性采样(同样的输入和参数,永远得到同样的输出)。
配套的评测体系也做得很较真:AIME、GPQA、HLE 三个基准的参考成绩(Pass@1 分别为 99.9%、93.4%、42.6%)写进了文档。
这个成绩的定位是「部署正确性自检」——你自己搭的服务跑出这个分数,才说明配置没搞错。
顺带一提,DeepInfer 同时支持英伟达 SM100 GPU 和华为昇腾 950 NPU,而且从测试标记到构建脚本看,昇腾是一条持续维护的一等公民路径,不是宣传姿态。
deepseek-recipe:两个项目里最容易被低估的那个
第二个开源项目 deepseek-recipe,乍看很不起眼:一个做「API 协议和模型 token 之间互相转换」的 Rust 库,外加 Python 绑定。
它干的活可以理解为「同声传译」。外部世界说的是 OpenAI 的 Chat Completions 协议、Claude 的 Messages 协议、OpenAI 新的 Responses 协议,模型听懂的是 token 序列。
它负责翻译过去,再把模型吐出来的 token 流翻译回各种协议的流式响应。
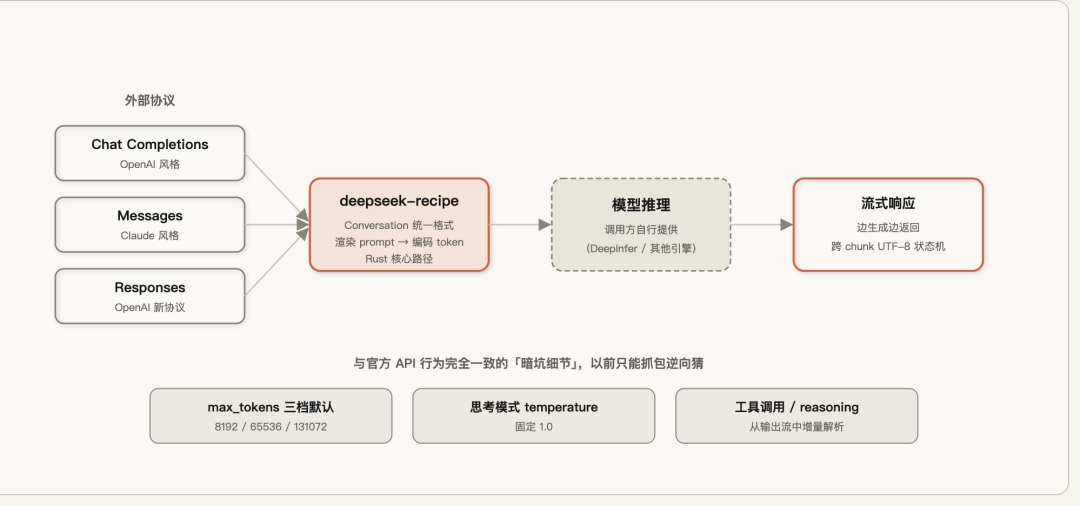
图5:deepseek-recipe 的同声传译管道
为什么说它被低估?因为自建推理服务的人都知道,让模型跑起来不难,难的是「跟官方行为完全一致」。
举个例子:用户没指定 max_tokens 时该给多少默认值?deepseek-recipe 的答案是三档——普通模式 8192,思考模式 65536,思考模式加最大推理力度时 131072。
这种细节,过去只能靠对着官方 API 抓包逆向猜。
再比如思考模式下 temperature 必须固定为 1.0、reasoning token 怎么计数、工具调用怎么从输出流里解析出来——这些「一致性细节」以前全是第三方部署的暗坑,现在直接给源码。
官方说得很直白:处理逻辑与 DeepSeek 官方 API 完整对齐。
还有个性能细节:它的核心路径用 Rust 写,分词从线性处理改成分段并行。这对应技术报告里「分词不能拖慢首字延迟」的目标——用户发一句话,系统光是把文字切成 token 就花掉几十毫秒,是不可接受的。
我的判断是:对做私有化部署的团队,这个「不起眼」的库的价值可能不亚于框架本身。
泼点冷水:它没有你想的那么「拿来即用」
看到这里先别激动,这次开源有三条边界要说清楚。
第一,最关键的两块没开源。DeepSeek 团队自己说了:KVCache 管理和全局负载均衡组件「与内部基础设施耦合较深,相关代码目前尚未完整开源」。
而这两块,恰恰是把「离线推理」变成「扛得住百万人同时在线的服务」的核心。官方 README 也明说,完整服务还需要自己补上 KV cache 系统、Prefill/Decode 分离的部署编排、跨副本负载均衡。
一句话总结:引擎给你了,但整个「车队调度系统」还得自己造。
第二,硬件门槛很高。要求英伟达 SM100 架构 GPU 或昇腾 950 NPU,配 CUDA 13 或 CANN 9.2。这是当前最新的旗舰级硬件,个人开发者基本摸不到,手里有 A100、H100 的也用不上。
第三,明确一下受益人排序:云厂商、要做私有化部署的大型机构、推理引擎开发者是最大赢家;应用层开发者更多是围观学习——当然,围观这份代码本身,就是一堂顶级的大规模系统工程课。
这件事的真正分量
把镜头拉远一点看。
推理成本是大模型普及的最后一道闸门。再聪明的模型,如果每次对话贵到用不起,就只能是演示品。
过去两年,行业靠模型压缩、靠 MoE 架构、靠 API 降价,把成本打下来了一个数量级。但「怎么在超大规模集群上把 GPU 效率榨到极致」这门手艺,一直锁在少数几家公司的机房里。
DeepInfer 的开源,等于把这门手艺的图纸挂到了公网上——而且和之前开源的模型、算子、编译器拼在一起,就是一条从权重到服务的完整生产线。
一家公司把商业化最核心的效率秘密持续公开,逻辑上只有一种自洽的解释:它赌的不是「我比别人藏得好」,而是「我比别人跑得快」。
开源版图每扩大一圈,全行业在它这套栈上建设的沉没成本就多一分,它下一次发布的杠杆就长一寸。
至于这套赌法成不成立,得看后续:官方承诺了「新模型的推理代码及后续优化将在 DeepInfer 持续更新」。这句话兑现的那天,才是检验诚意的时候。
如果你身边有做推理部署或 Infra 的朋友,把这篇转给他——这两个仓库值得他花一个晚上。
自我介绍
大家好,我是Aaron。过去一直从事算法领域相关工作,自工作以来,一直持续在关注算法相关技术的发展,当前除了在工作中会进行一些AI的落地实践,工作之余也在通过AI辅助编程做一些有趣的探索。我会持续更新AI实践过程中的心得体会,以及AI知识分享。欢迎大家关注我关注公众号,以便第一时间收到更新推送。
