引言:为什么”文件格式”这个老话题突然又热了
文件格式是数据基础设施中最”底层”也最”沉闷”的一层——一旦定型,十年难改。正因如此,当 2023 年之后 Lance、Vortex、Nimble 等新格式接连出现、学术界连发 FSST / ALP / FastLanes / BtrBlocks 等高引论文、连 DuckDB 都开始内置新格式扩展时,这个信号就不容忽视了:触发这一轮变革的不是某个单点技术,而是硬件与负载的同时换轨。
硬件侧的根本变化可以用一句话概括:瓶颈从 I/O 搬到了 CPU。十年前设计 Parquet/ORC 时,优化目标是让机械硬盘和千兆网络上的每一秒等待都物有所值——所以用大 Row Group、大 Page 摊薄寻址成本,用重型块压缩(Snappy/Zstd)换取更少的磁盘字节。而今天,NVMe SSD 提供数十 GB/s 的持续读取和数十万级 IOPS,100GbE 网络让数据”瞬间到位”,结果往往是:数据已经躺在内存里了,CPU 还在忙着解压。通用解压吞吐量级在个位数 GB/s,与硬件能力差了一个数量级以上。
负载侧的变化同样剧烈。AI 训练与推理带来了全新的访问模式:数万列的特征宽表(每个模型迭代都在加列)、固定维度的 Embedding 向量、训练时每个 epoch 的全局 shuffle(本质是大规模随机访问)、RAG 场景中的向量检索与全文检索、以及图片音频文档等多模态大对象。这些负载没有一种是为”大块顺序扫描”设计的——而顺序扫描恰恰是 Parquet 的舒适区。
这篇文章要回答三个问题:这一轮技术变革的核心内容是什么?各方势力的真实格局如何?未来五到十年会走向哪里?
一、第一性原理:列编码到底在优化什么
要理解这一轮变革,必须先回到最底层的问题。行存储中同一行的不同列交织在一起,编码器看到的是高熵字节流,只能退回通用压缩。列存储的根本价值在于:它把同一列、同一物理域的值聚在一起,数据的分布规律性才第一次完整暴露——一列时间戳几乎单调、一列国家名只有两百个取值、一列价格集中在某个数量级。编码的全部威力来自利用这些规律。
列编码的第一性原理因此可以表述为:用分布的冗余度,去换取三种资源——存储字节、带宽、CPU 周期。难点在于三者并非总同向,设计艺术在于找帕累托前沿。
这里有一个贯穿全文的核心区分:
| 维度 | 轻量级编码(LWC) | 重量级块压缩 |
|---|---|---|
| 代表 | Dictionary、RLE、FOR、Delta、Bit-packing、FSST、ALP | LZ4、Snappy、ZSTD、gzip |
| 数据感知 | 是(理解类型与分布) | 否(对字节流盲目) |
| 解码速度 | 极快(每秒数十亿值) | 慢(GB/s 级) |
| 随机访问 | 通常保留(可单独取第 i 个值) | 必须整块解压 |
| 压缩态计算 | 可以不解码直接过滤/比较/聚合 | 与计算互斥 |
| SIMD/GPU 友好 | 可设计为完全数据并行 | 字节流有数据依赖,难以并行 |
| 压缩率上限 | 中高 | 最高 |
块压缩这条路的天花板已经被 ZSTD 摸到,而 LWC 这条路同时打开了”压缩态计算”的新维度——这才是性能引擎真正在意的东西,也是过去六年学术界全部主攻的方向。
评价一种编码的完整框架是六元组:压缩率、解码吞吐、编码吞吐、随机访问、可计算性(能否在编码态执行算子)、硬件友好度与自适应性。经典通用压缩在第一项上不弱,但在后四项上几乎全输;第二波 LWC 的全部创新,正是在保住前两项的同时把后四项拉满。
二、学术主线:轻量级编码的两波浪潮
2.1 奠基(2006–2016):两条独立的主线
现代列编码有两篇 2006 年的奠基论文,恰好对应”省空间”与”提速度”两个方向,后来合流:
Abadi 等《Integrating Compression and Execution in Column-Oriented Database Systems》(SIGMOD 2006) 确立了至今仍是北极星的思想:不要把解压当作执行前的独立工序,而要让算子直接在压缩数据上运算——延迟物化(late materialization),尽可能晚地把编码码字翻译回原值,理想情况下根本不翻译。今天 Velox 的压缩态执行、StarRocks 的低基数优化,本质都是这篇论文思想的工程兑现。
Zukowski 等《Super-Scalar RAM-CPU Cache Compression》(ICDE 2006) 关注另一面:解码必须够快才不会成为新瓶颈。它提出 PFOR/PFOR-DELTA/PDICT 这组超标量友好的编码——异常值单独 patch、主路径无分支,让乱序多发射 CPU 流水线吃饱。这是一切”SIMD 友好编码”的祖先。
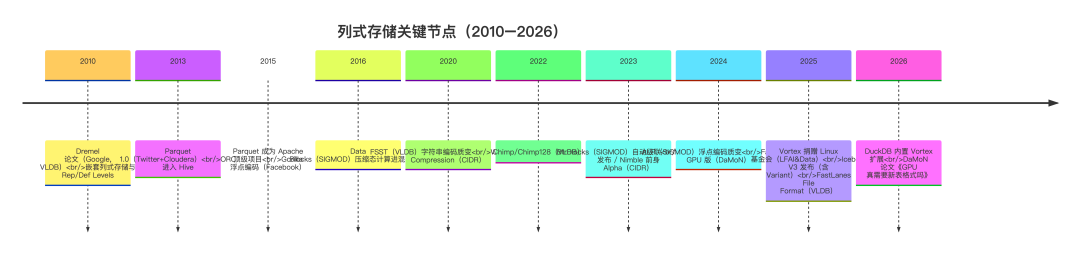
随后的《Data Blocks》(SIGMOD 2016)在 HyPer 上把向量化与编译同时作用于压缩存储,是压缩态计算在混合 OLTP/OLAP 引擎里的完整落地;《White-box Compression》(CIDR 2020)提出让系统显式”学习”列的紧凑表示并暴露给执行器,是 BtrBlocks/FastLanes 可级联编码思路的直接前身。
2.2 第二波(2020–2025):三块关键拼图 + 一个自动组合器
经典编码解决了整数与低基数,但两个高价值数据域长期没有好答案:字符串和浮点。第二波工作精准补上了这两块,并在布局层做了一次彻底的 SIMD 化重构。这一波几乎由 CWI(Boncz 组)与 TUM(Leis 组)联手主导。
FSST:字符串的质变(VLDB 2020)。用一张静态符号表(最多 256 个、长度 1–8 字节的符号),把高频子串替换成 1 字节码字。符号表小到常驻 L1 cache,解码用一次非对齐写即可拷贝整个子串。它带来三个对计算引擎极其友好的性质:随机访问(非块式,可单独解出第 i 个串);等值比较免解压(FSST 保证相等的串其压缩形式也相等,join/聚合可直接在压缩串上做);谓词下推与延迟物化(选择谓词可下推到压缩域)。解压速度与 LZ4 相当或更优,压缩率显著更好。FSST 已被 DuckDB 采用,并成为 BtrBlocks、Vortex 的标准字符串组件。
ALP:浮点的质变(SIGMOD 2024)。浮点压缩这条线的演进史本身就是一部”弯路史”:Gorilla(Facebook,VLDB 2015)存相邻值 XOR,成为时序监控的事实标准;Chimp/Chimp128(VLDB 2022)、Patas、Elf 相继改进,但有个尴尬的结论——它们的压缩率并不比 ZSTD 更好,解压却比 Delta/FOR 慢得多。ALP 的突破来自一个对真实数据的洞察:大量”浮点”其实来自有限位数的十进制(如 3.25、-6.425——价格、评分、坐标、指标),于是把 double 无损地转成两个整数列(有效数字 + 指数)外加少量异常 patch,然后复用 FOR/Bit-packing 这套 SIMD 极快的整数编码。硬数据:压缩率比 Gorilla 高约 50%、比 Chimp128 高约 24%、与 ZSTD level-3 相当;以每周期处理元组数计,ALP 约 2.6,而 Patas 0.157、Gorilla 0.047、Chimp128 0.040——快一到两个数量级。DuckDB 已用 ALP 取代 Chimp128 与 Patas,实测解压比 Patas 快 2–4 倍、压缩率翻倍。
FastLanes:布局层的釜底抽薪(VLDB 2023)。如果说 FSST 和 ALP 解决”编码什么”,FastLanes 解决的是”怎么排布字节才能让解码吃满任意 SIMD 宽度”。两个核心思想:其一,统一转置布局——把每 1024 个元组按固定的 “04261537” 交错顺序重排,消除 Delta/Dictionary 这类有数据依赖编码的顺序依赖,让每条 SIMD 指令都处理互相独立的值;其二,虚拟 1024-bit 指令集(FLMM1024)——不针对当下最宽的 SIMD ISA 优化,而是面向一个虚拟的 1024-bit 寄存器定义算子,能被所有现存 SIMD 方言(AVX2/AVX-512/NEON/SVE)乃至纯标量代码实现。结果反直觉且惊艳:用标量代码每秒解码超过 1000 亿个整数——交错布局让标量解码也能被编译器自动向量化,顺便消除了平台相关 intrinsic 的技术债。2024 年 DaMoN 有 GPU 加速版本;2025 年的 The FastLanes File Format(VLDB)进一步贡献了”两阶段编码表达式搜索”和支持部分解压的 API。
BtrBlocks:自动级联(SIGMOD 2023)。有了编码池,下一个问题是”对每列每块该选哪个、要不要套娃”。BtrBlocks 的答案:级联/递归编码(一种编码的输出再被另一种编码,如浮点拆成整数列后各自递归选 RLE/FOR/Bit-packing)+ 采样选择(对每列取样,三轮内试遍可行方案,按压缩率×解码速度挑最优,带早停)+ 刻意避开通用压缩、偏好完全数据并行的 LWC。Parquet 的 “dictionary→RLE→Bit-packing” 是一条硬编码的固定级联,BtrBlocks 把它变成数据驱动的任意组合。
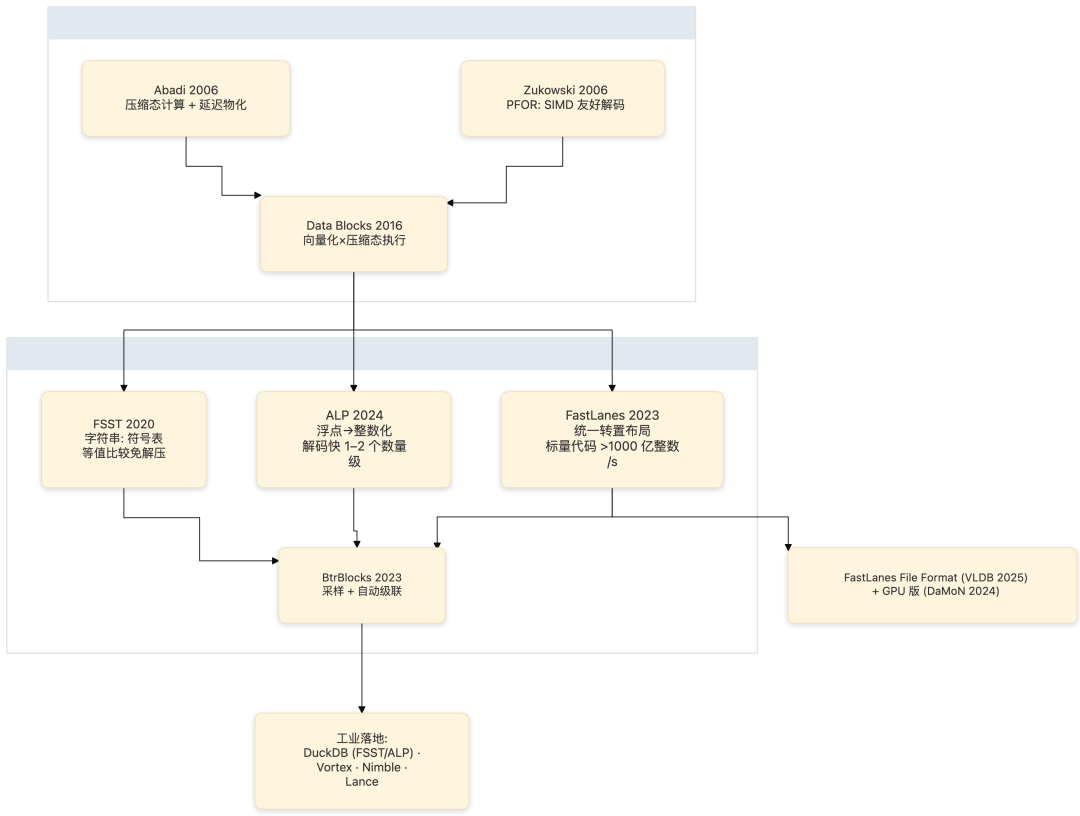
一个值得注意的判断:这四项工作的共同前提是”编码不再只是存储态的事,而是贯穿存储、传输、计算三态的一等公民”。轻量级编码正在从”块压缩的前处理”升级为”可被计算引擎直接运算的物理表示”——这是理解全部后续格式竞争的钥匙。
三、Parquet 的结构性局限:被反复点名的四宗罪
工业文件格式普遍是”LWC 编码(per page)+ 块压缩(per column chunk)“两层模型。Parquet 在过去十年极其成功,但作为 2013 年的设计,其结构性局限在今天被多方实测确认(《An Empirical Evaluation of Columnar Storage Formats》,Zeng 等,VLDB 2023):
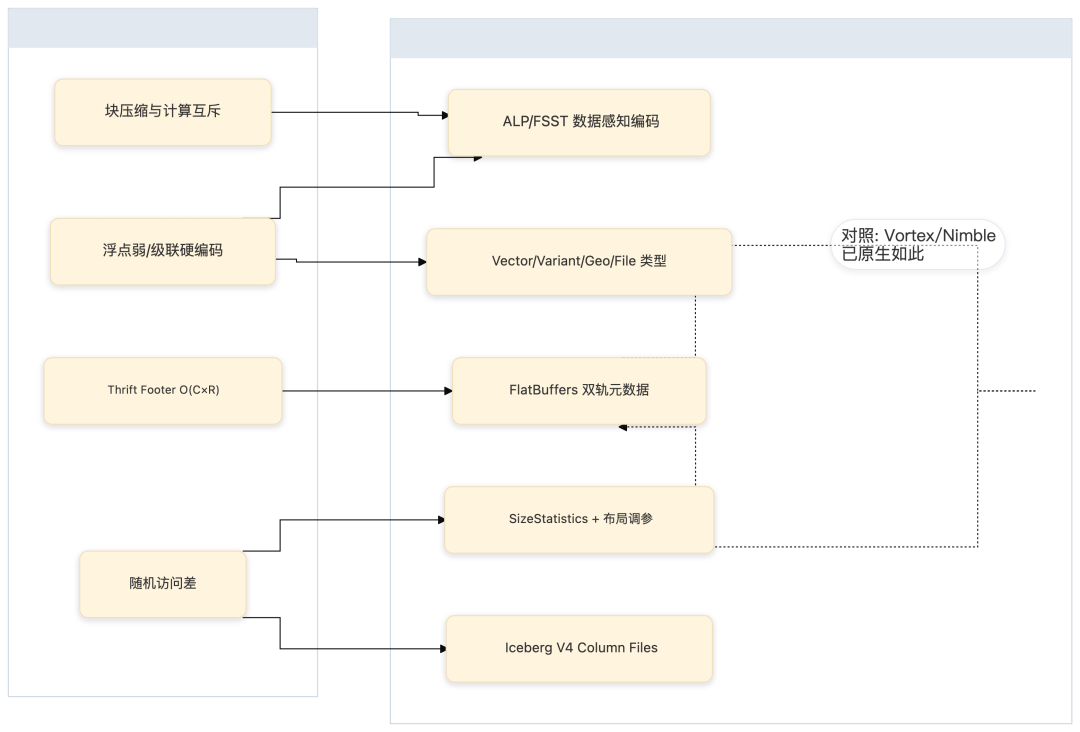
其一,块压缩与计算互斥。 Parquet 是 block-compressed 的,引擎必须先解压整页才能过滤、解码、取值,无法在压缩段上直接运算。这与压缩态计算的整个潮流方向相反。
其二,浮点编码偏弱、级联硬编码。 没有 ALP 级别的浮点方案;编码级联路径固定,无法按数据分布自适应组合。
其三,宽表元数据是顺序解码的。 Footer 用 Thrift Compact Protocol 序列化(ORC 用 Protobuf,同样问题),只支持从头到尾线性扫描。列数 C × Row Group 数 R 的元数据构成 O(C×R) 解析陷阱:即使查询只涉及一列,也必须解析物化完整元数据树。ML 宽表动辄上千上万特征列,Footer 解析从毫秒级膨胀到秒级。Thrift Footer 中还存在大量重复信息(如 path_in_schema 在极端宽表中可能占据 Footer 体积一半以上)。
其四,随机访问差。 面向顺序扫描设计,最小读取粒度 Page 常接近 1MB,点查一条记录要读取并解压整页——而 ML 训练 shuffle、向量检索、特征抽取全都是随机访问负载。
正是这四点,催生了三个意图取代 Parquet 的新格式——它们分别代表三条不同的技术路线。
四、挑战者全景:三条路线的深度解剖
4.1 Lance:抛弃行组的”革命派”
Lance(LanceDB,2023)是”从零为 AI/ML 重新设计”的代表,其论文标题就是宣言——《Lance: Efficient Random Access in Columnar Storage through Adaptive Structural Encodings》,直接挑战”列存天生不擅随机访问”的成见。
最根本的设计变化:解耦的列式页面(Decoupled Column Pages)。Parquet 将数据按行切成 Row Group,行组内所有列的行数完全一致,形成规整矩形。Lance 完全抛弃行组概念,每一列是一个独立的数据流,各自按物理大小(推荐约 8MB)切页。直接后果:不同类型列的一页包含的行数不同——INT64 列一页约 100 万行,6KB/行的高维向量列一页只有约 1300 行。这解决了 Parquet 行组在”窄列与宽列共存”时的经典尴尬:要么让 embedding 这类宽列把行组撑得巨大,要么让窄列在行组中数据量过小。
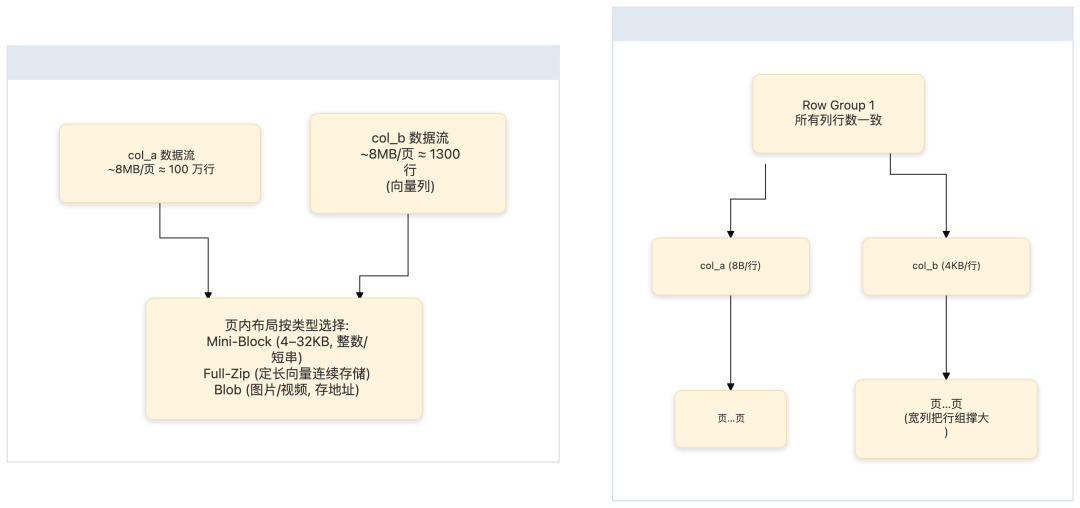
页内布局按数据特点自适应:Mini-Block 布局(4–32KB)服务整数与小字符串的细粒度随机访问;Full-Zip 布局为定长向量连续存储以减小元数据开销;Blob 布局存图片视频等大对象。zonemap 仍按固定行数维护(而非按页),1M 行切成一串 8MB 页存储,页本身即并行单位。
更新与版本:安全的”追加-提交”模型。数据集是一个目录,任何修改(增删改、加列)都遵循 append-only 与 immutable 原则:加列时把新列写入全新文件、旧文件完全不动,创建同时引用新旧文件的新 Manifest,最后原子性更新 _latest.manifest 指针。代价是需要后台 compaction/vacuum 回收垃圾;收益是零成本版本控制(时间旅行)——这对 ML 实验的可复现性至关重要。
索引是一等公民。Lance 原生支持数据库经典索引(B+ 树、Bitmap、Bloom Filter、Zonemap、倒排索引)与向量索引(IVF、PQ、HNSW),使随机访问的高效真正兑现为检索能力。LanceDB 作为嵌入式向量数据库(“向量界的 SQLite”)已在 AI Agent 生态中获得大量真实采用——它的新增列零拷贝设计,正是为了 ML 场景”常常要加很多新特征列”的痛点。
与 Lance 相对的是学术界的Bullion(“改良派”):接受 Parquet 的行组设计并在此基础上改进,额外做了数据合规性删除(deletion compliance,可立即删除某条数据而非靠 compaction 延后)和多模态存储优化(质量感知行重排、视频关键帧混合存储),并探索把量化(quantization)这类有损但可接受的编码纳入列存编码框架。Bullion 尚未开源,更多是学术验证。
4.2 Vortex:研究即产品的”体制内挑战者”
Vortex 是三个新格式中最激进、也最值得严肃对待的一个——因为它不是实验室原型,而是带着工程完成度和重量级背书进入市场的:
-
2025 年 8 月由 SpiralDB 捐赠给 Linux 基金会 LFAI&Data(注意:是 LF 而非 Apache),获得 Microsoft、Snowflake、Palantir、NVIDIA 背书;
-
格式自 0.36.0 起视为稳定,承诺未来所有版本可读 0.36.0+ 写入的文件;
-
Microsoft 已在 Iceberg 中用 Vortex 直接替换 Parquet 跑 TPC-DS SF=1000(Spark):运行时降约 30%、存储降约 20%;
-
DuckDB 于 2026 年 1 月发布 Vortex 扩展,读写支持开箱即用。
Vortex 的设计吸收了第二波编码的全部成果,四个特征构成其骨架:
其一,压缩态计算是一等能力。 因为 Vortex 知道每段数据的编码布局,它能在压缩数据上直接执行任意表达式——过滤表达式可在存储段内求值而无需解压。这把”谓词下推”的边界从扫描算子推进到了格式内部。
其二,直接采用 ALP(浮点)、FSST(字符串)与级联编码,每个数组携带惰性统计(lazy statistics)供压缩器与 compute kernel 使用;与 Apache Arrow 零拷贝互转。
其三,极简 Footer + 零解析元数据。 文件尾部只有一个极小的 postscript(版本 + 长度 + 魔数 VTXF),指向 FlatBuffers 序列化的 dtype/layout/footer 段——宽表场景下元数据可随机访问、按需解析,从根上绕开 Thrift 的 O(C×R) 陷阱。
其四,可演进的 Editions 机制——这是 Vortex 最独特的设计。 Footer 规范保持极简,以日期戳(YYYY.MM.DD)发布”被祝福的编码/布局集合”(blessed set):老 Reader 永远能读老 Edition,Writer 可配置目标兼容窗口。这优雅回答了一个所有格式都会遇到的死题——如何持续吸收新压缩研究成果(学术界的 SOTA 演进比布局快得多)却不破坏兼容。
官方性能口径(vs Parquet+zstd):随机访问快约 100–200 倍、扫描快约 2–10 倍(官方亦称 10–20 倍)、写入快约 5 倍,压缩率相当。其长期目标包括 S3 数据直解到 GPU(跳过 CPU)。
4.3 Nimble:Meta 的仓库级豪赌
Nimble(Meta,原名 Alpha,源自 CIDR 2023 论文《Shared Foundations: Modernizing Meta’s Data Lakehouse》)代表第三条路线:不是创业公司或研究组的试验,而是一家巨头把自己的整个数据仓库迁移过去的工程决断。
面向 ML 宽表训练场景,Nimble 的关键改造:元数据用 FlatBuffers 以便只解码用到的列(直接解决 Thrift 顺序解析之痛);支持级联/递归编码且刻意解耦”stream 编码”与”物理布局”(因为编码 SOTA 演进快,布局演进慢);自适应编码选择通过”编码历史回环数据库”(encoding history loopback DB)按历史数据模式挑最优;工程上还做了特征扁平化(把 n 个特征当 n 列而非一个 map)、特征重排(常一起访问的特征排相邻磁盘位置)、合并读(选中特征流打包成单次 IO)——这一组”读取侧编排”优化是超宽特征表场景的独门经验。
4.4 格式对比矩阵
| 维度 | Parquet | ORC | Lance | Vortex | Nimble | FastLanes FF | Bullion |
|---|---|---|---|---|---|---|---|
| 设计年代 / 主战场 | 2013 / 通用分析 | 2013 / Hive 生态 | 2023 / AI/ML 随机访问 | 2024–25 / 通用+多模态 | 2024 / ML 宽表+分析 | 2025 / 研究参照实现 | 2025 / 学术(ML 训练) |
| 元数据协议 | Thrift(顺序) | Protobuf(顺序) | 自定义(轻量随机) | FlatBuffers(极简 footer) | FlatBuffers | FlatBuffers | — |
| 行组/页面模型 | 行组对齐 | 行组(Stripe) | 列解耦独立页 | Layout 树 | stream 与布局解耦 | 转置布局 | 保留行组(改良) |
| 编码可扩展性 | 固定集合 | 固定集合 | 自适应结构编码 | 可插拔 + Editions | 可插拔 + 历史回环 | 级联表达式搜索 | 级联 + 量化 |
| 压缩态计算 | 否(块压缩) | 否 | 部分 | 一等能力 | 部分 | API 级支持 | 部分 |
| 随机访问 | 弱 | 弱 | 强(1–2 个数量级提升) | 强(100×+) | 中 | 中 | 中 |
| 二级/向量索引 | 无(依赖外置) | 无 | 原生(IVF/PQ/HNSW/倒排) | 计划中 | 无 | 无 | 无 |
| 治理归属 | Apache | Apache | LanceDB(开源) | Linux 基金会 LFAI&Data | Meta(开源) | 学术 | 学术(未开源) |
| 生态采用 | 全引擎、EB 级存量 | Hive 系 | LanceDB/AI Agent 栈 | DuckDB 扩展、MSFT Iceberg 试验 | Meta 内部 | 研究原型 | — |
三条路线的分野现在很清晰:Lance 赌的是”AI 原生负载值得一个专用格式”;Vortex 赌的是”可以在 Iceberg 体系内整体替换 Parquet”;Nimble 赌的是”一家公司的仓库现代化足以验证新范式”。它们互不取代,但共同改变了市场的可能性边界。
五、被低估的另一半:执行侧的压缩态计算革命
讨论格式竞争时最容易忽略的事实是:“在编码码字上直接算”早已是主流 OLAP 引擎的标配,比新格式的普及快得多。
Velox 的压缩态执行(Meta)。这个被 Presto/Spark/PyTorch 数据加载复用的 C++ 向量化执行库,让编码拥有双重身份——既是数据压缩,也是”基数缩减/放大算子(filter、join、unnest)输出”的表示。一次过滤的结果可以表示成”在原数组外面包一层 dictionary/selection vector”而无需物化新数组;真正的解码被推迟,甚至完全避免。Velox 还会在处理连续批次时自适应学习(动态决定谓词求值顺序、是否物化)。
StarRocks 低基数全局字典。对低基数字符串列维护跨 segment 的全局字典,在优化器层把字符串的 GROUP BY、谓词、COUNT(DISTINCT)、甚至部分 join 改写为在整数字典码上执行——扫描、哈希、聚合全程不碰原始字符串,只在最终输出物化回串。这是把 2006 年 Abadi 的延迟物化做进了 Cascades 风格优化器的改写规则里,性能提升常以数倍计。
ClickHouse 的 LowCardinality 与 CODEC 体系。LowCardinality(String) 把低基数(经验上 < ~10k distinct)字符串声明为字典类型,存储降约 3–10 倍并加速 GROUP BY;两阶段 CODEC 语法 CODEC(DoubleDelta, ZSTD(1)) 把”轻量编码 + 字节压缩”的两层模型暴露得最直白——时序场景 DoubleDelta+ZSTD 压缩比可达 1:800+。
分布式场景的杠杆放大。FSST/字典让 join/agg 的哈希表更小(放得进 cache、减少 spill)、shuffle 网络字节更少(传码字而非原值)、broadcast 小表更小。编码不仅省存储,还直接压低了分布式执行里最贵的两项成本——网络与内存。中间结果也是编码的,收益贯穿整条执行管线而非只作用于扫描入口。
这一侧的事实对格式竞争的含义是深远的:既然引擎已经会把算子下推到编码态,那么”格式是否暴露编码语义给引擎”就成了新的竞争力维度。 Parquet 的块压缩把数据遮在字节流后面,引擎想下推也无从下手;Vortex/FastLanes FF 把编码布局做成格式契约,下推边界直接推进到存储内部。Format 与 Engine 的职责边界正在被重画——这是我判断未来格局的关键变量之一。
六、Parquet 阵营的反击:兼容约束下的谨慎进化
面对四宗罪与三个挑战者,Parquet 社区(Apache)的应对不是推倒重来,而是”双轨兼容”哲学下的定向修补。其依据的判断是:Parquet 的核心资产不是某项技术,而是它作为开放数据生态共享互操作层的地位——上层连接 Iceberg/Hudi/Delta Lake,横向服务 Spark/Trino/DuckDB/ClickHouse,背后是 EB 级存量数据与十年生态投资。一个成为行业标准的格式必须一边解决历史问题,一边保持数以 EB 计的数据仍然可读。
元数据快速路径(攻”四宗罪”之三)。社区正在讨论用 FlatBuffers 为 Footer 建立新快速路径:Writer 仍生成含 Thrift Footer 的标准文件,同时把 FlatBuffer 元数据写入保留字段;旧 Reader 安全忽略未知字段,新 Reader 识别特定 UUID 后直接走随机访问路径。实测锚点:10 万字符串列 × 20 Row Group 的合成场景,生成 Thrift 代码解析需约 3380ms,arrow-rs 定制优化后约 1016ms,去掉统计信息后约 367ms——说明代码优化很快撞上协议天花板;而 Databricks 一个 2.9 万列 × 78 Row Group 的生产案例中,新元数据表示把 Footer 从 367MB 压到约 50.4MB(-86%),解析提速约 40 倍。
数据感知编码(攻其一、其二)。ALP 提案已完成社区投票(相较 ByteStream Split 解压吞吐约快 3 倍,不叠加 Zstd 也有约 1.5 倍压缩收益),FSST 提案推进中(约 Plain+Dictionary 的 2.45 倍压缩率,符号替换无数据依赖可并行,支持压缩字节上的过滤下推)。这与学术界第二波的方向完全咬合——事实上 FSST/ALP 本就是社区在 DuckDB 等引擎验证过的成熟技术,进入 Parquet 标准是水到渠成。
GPU 友好化(攻其四的一部分)。两条机制:SizeStatistics(记录 BYTE_ARRAY 原始负载大小,让 GPU kernel 启动前能估算输出显存、合理分批);以及写入侧调参——DaMoN 2026 论文《Do GPUs Really Need New Tabular File Formats?》证明,针对 GPU 重写 Parquet(增加 Page 数量、优化 Row Group 大小、选合适编码、跳过无关数据)后读取带宽可从约 1GiB/s 提升到 125GiB/s,跑满 4 块 NVMe。“不是格式死刑,是布局调参”——一个 CPU 导向的 Column Chunk 只有一个大 Page,对 GPU 是一个串行任务;拆成上百个小 Page 就是上百个并发 kernel block。这篇论文的实验方法虽有可商榷之处,但”提高并发度、重新调参”的思路与多方工程经验一致。
类型系统扩张(攻”AI 数据类型缺口”)。这是 Parquet 演进中最”广”的部分:
-
FLOAT16:已可基于 2 字节 FIXED_LEN_BYTE_ARRAY 表示,支持严格全序语义(正确处理 NaN、±0.0);
-
Variant:半结构化数据的列式化,核心是 Shredding——高频访问路径自动拆为独立强类型物理列(享受列式编码、统计、谓词下推),长尾留在 Variant 主体。其落地是开放社区协作的范本:Databricks 在 Spark 实现后,Snowflake 建议推回 Iceberg 社区,经历约两个月讨论,Spark/Iceberg/Parquet 三方最终共识把物理表示收敛到 Parquet(arrow-rs 的 Variant 支持已进入 API 收尾阶段,实验标志正在移除)。Iceberg V3(2025 年春季获批)已含 Variant;
-
Vector:固定维度向量目前存成三层可变长 LIST,每个元素额外写 Repetition/Definition Level,读取性能只有 FixedSizeList 的约三分之一。社区在讨论三种方案——FLBA+LogicalType(兼容最好、编码效率差、零拷贝极好)、新增 VECTOR Repetition Type(模型最干净、编码全可用、但旧引擎可能直接失败、实施成本极高)、LIST+注解(兼容与效率的折中)。方案未定,取舍经典:最优雅的新模型未必是最负责任的工程方案;
-
Geospatial:原生 GEOMETRY/GEOGRAPHY Logical Type(WKB 物理表示)已进入 Parquet;Iceberg 在表格式层记录 MBR 空间统计实现文件级 Data Skipping;GeoParquet 2.0 将采用 Parquet 原生 Geometry。分层清晰:文件格式管可移植物理表示,表格式与领域规范管查询治理语义;
-
File Type:已获社区接受,三值结构(Inline / Self-reference 指向文件内字节段 / Remote 指向对象存储),与 Iceberg 的 FileRef 提案构成”Parquet 让文件值可移植、Iceberg 让对它的访问可治理”的双层拼图。
与 Iceberg 的协同演进(攻”列级更新”)。AI 特征表”大量列很少变、少数列每天更新”,若每次更新都重写整张宽表,写放大不可接受。Iceberg V4 正在讨论的 Column File 机制:基础数据存不可变 Base Parquet 文件,新特征写较小的 Column Parquet 文件,读取时用隐藏位置列 _pos 在内存中拼接出完整逻辑视图。这与 Lance 的按列独立演进、Nimble 的合并读指向同一结论:列更新是表格式的职责,不应要求文件格式为每次列修改重写整张宽表。
七、对”Parquet 已死?“一文的观点评估
以《Parquet 已死?AI 时代列式巨人的进化与反击》(云器科技吴刚、邹泽桦)为代表的流行论述,其核心判断是”Parquet 没有死,新格式是压力测试,帮 Parquet 看清方向”。基于本文的调研,我的评估如下。
站得住的部分(多数):
其一,“Footer O(C×R) 解析陷阱”完全成立,有 VLDB 2023 实证研究与 Nimble/Vortex 的设计互证;其二,ALP/FSST 作为下一代编码方向的判断准确,与学术第二波完全咬合,且 DuckDB 的采用证明工程成熟度;其三,“GPU 问题本质是布局调参而非格式死刑”的判断站得住,DaMoN 2026 与 FastLanes GPU 版(DaMoN 2024)双重佐证;其四,Variant 收敛到 Parquet 的叙事属实(arrow-rs 的 Variant EPIC 可查证进展);其五,总体判断”Parquet 短期不会死”正确——生态引力、EB 级存量、全引擎支持的护城河真实存在。文中的具体数字(3380ms→367ms、-86%、40×、125GiB/s 等)与公开披露口径一致,无夸大。
需要修正或补充的部分:
其一,对 Vortex 的定性偏差。原文将其与 FastLanes、BtrBlocks 并列为”新格式和研究项目”,这低估了它:Linux 基金会治理 + Microsoft/Snowflake/Palantir/NVIDIA 背书 + DuckDB 内置扩展 + Microsoft 在 Iceberg 中替换 Parquet 跑 TPC-DS 的实测数据(运行时 -30%),意味着 Vortex 是体制内的、可在 Iceberg 体系内无缝替换 Parquet 的挑战者——它不需要用户离开湖仓生态,这使它比 Lance 对 Parquet 的威胁更直接。原文”挑战者未必会成为下一代统一标准”的缓冲表述,对 Vortex 而言偏保守。
其二,对 Lance 的技术描述过简且有偏差。“4KB 至 8KB 的 Miniblock”的说法不完整:Lance 稳定版(V2.0)的实际结构是列解耦的约 8MB 页(页内再按类型切 4–32KB Mini-Block 或用 Full-Zip/Blob 布局),其最深刻的创新是抛弃跨列的行组对齐——这解决的是窄列与宽列(如 embedding)共存的矩形约束问题,比”块更小”重要得多。
其三,完全遗漏了压缩态计算的执行侧革命。Velox/StarRocks/ClickHouse 的实践表明,“编码即物理表示、算子直接吃码字”已是标配。这改变了格式竞争的评价标准:格式的竞争力不再只是压缩率与解码速度,而是”是否把编码语义暴露为引擎可下推的契约”。原文只谈格式层,丢掉了半张地图。
其四,未提及 Vortex 的 Editions 机制。日期戳”被祝福编码集合”与 Parquet 的双轨 UUID、F3 的 WASM 内嵌解码器,是同一个问题(格式如何持续吸收新编码而不破坏兼容)的三种答案。Editions 恰恰说明”可演进性”已被新格式做成了一等设计而非事后补丁——这正是 Parquet 需要对标的地方,仅论述 Parquet 自身的双轨方案是不完整的。
其五,“压力测试”框架低估了市场分化的事实。LanceDB 已在 AI Agent 生态获得真实商业采用(嵌入式向量库是当前增长最快的数据基础设施品类之一);DuckDB+Vortex 组合正在切入单机分析+AI 这个增量市场。挑战者们不是在等 Parquet 吸收思想,而是在各自细分市场里建立根据地。“统一格式吸收一切”与”按负载分化的格式栈”是两种都可能成真的未来,原文只给了前者。
八、演进方向研判:未来五到十年的六个判断
以下是我的前瞻分析,置信度随条目递减。
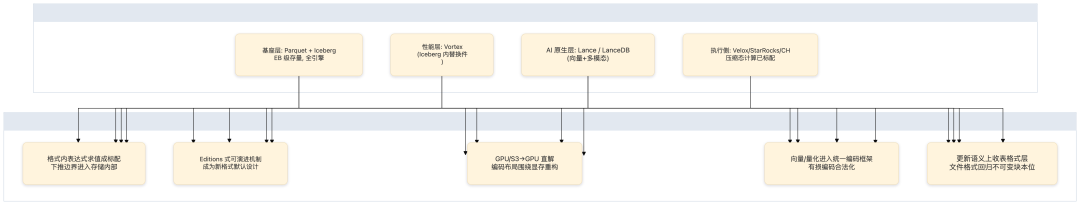
判断一:格式市场从”赢家通吃”走向”按负载分层”,Parquet 仍是基座但不再是前沿。 最可能的格局是三层:可靠性基座层(Parquet+Iceberg,承载存量 EB 级数据与全部传统 BI 负载——这一层的迁移成本在任何 ROI 计算里都不可行);性能层(Vortex 或同类,作为 Iceberg 内的 Parquet 替换件,服务对延迟敏感的分析——Microsoft 的 TPC-DS 试验证明了这条路的技术可行性);AI 原生层(Lance 类,专司向量检索、多模态、训练数据管理)。分层的驱动力正是本文第一节的负载分化。 Parquet 的”开放互操作层”地位让它稳坐基座,但前沿创新的重心已经移出 Parquet 本体——它会赢得很稳,但赢得不再性感。
判断二:计算与存储的边界重画,“格式内求值”成为标配能力。 谓词下推的下界正从”扫描算子”推进到”存储段内部”:Vortex 已支持段内表达式求值,FastLanes FF 提供部分解压 API。当对象存储上的数据可以不解压就完成过滤甚至聚合,引擎与格式的接口将从”给我字节”变成”帮我算这个表达式”。五年内,不支持压缩态计算的开放格式会在性能敏感场景失去竞争力——这是比压缩率更硬的生死线。
判断三:可演进性机制将收敛为行业标配,Editions 式设计胜率最高。 三种方案的比较:Parquet 双轨(保留字段+UUID)最保守,优点是零破坏,缺点是每个新能力都要走一遍双轨、文件膨胀;F3 的 WASM 内嵌解码器最激进,彻底解决兼容但引入任意代码执行的安全审计难题,短期内难被企业接受;Vortex Editions(日期戳被祝福集合+可配置兼容窗口)在中间——它承认”编码 SOTA 演进快于布局”这个现实,把演进做成产品节奏。我预计”blessed set + 兼容窗口”会成为 2027 年后新格式的默认设计模式,而 Parquet 也会逐步引入类似的版本化编码集合概念。
判断四:GPU 与 S3→GPU 直解是下一个性能数量级的来源,编码布局将围绕它重构。 FastLanes 的虚拟 1024-bit ISA 是为”SIMD 还会变宽、ARM/x86/GPU 并存”做的前瞻;Vortex 把 S3 直解到 GPU 列为目标;DaMoN 2026 证明现有 Parquet 调参即可跑满 NVMe。当 GPU 成为数据处理的默认算力(而非加速器),编码的布局设计约束将从 CPU cache line 转向 GPU warp/显存分页模型,这是十年一遇的布局重设计窗口。
判断五:向量与量化进入统一编码框架,“有损可接受”打开新设计空间。 ML 场景对精度的容忍度(int8/int4 量化已是推理标配)意味着编码框架不必死守无损原则。Bullion 已在探索量化作为列存编码;Lance 的 IVF-PQ 本质是”索引即编码”。当 Embedding 成为与 INT64 同等常见的数据类型,向量编码(含量化、稀疏化)会被格式标准化——Parquet 的 Vector 类型讨论只是这一进程的第一步。
判断六:表格式层将持续吸收”更新语义”,文件格式回归”不可变数据块”本位。 Iceberg V4 Column Files、Lance 的 Manifest 版本化、Nimble 的 stream 演进,共同指向一个方向:列级更新、schema 演进、时间旅行都由表格式(或数据集层)负责,文件格式专注做高效的不可变列式块。分层会更清晰而不是更模糊——这对用户是好消息:换文件格式(Parquet→Vortex)可以不动表格式(Iceberg),数据栈的可替换性反而增强了。
九、结语
把这一轮变革放到更长的历史里看,会发现一个规律:列式存储的每一代设计,都是对”当时最贵资源”的精确回应。2006 年的两篇奠基论文回应的是”CPU 与内存带宽的赛跑”;2013 年的 Parquet/ORC 回应的是”机械硬盘与慢网络的延迟”;2020 年之后的第二波编码与新格式,回应的是”NVMe 时代 CPU 解码成了新瓶颈、GPU 成了新算力、AI 成了新负载”。
技术会过时,但这个方法论不会。判断任何一份存储技术路线图的成色,只需要问三个问题:它认为现在最贵的资源是什么?它认为三年后最贵的资源会变成什么?它在两者之间做的权衡是否诚实?
从这个标准看,Parquet 的进化是诚实但迟缓的(受制于标准身份),Vortex 是最完整的一次回答,Lance 是对 AI 负载最彻底的一次重设计,而学术界(CWI/TUM 一系)持续供给的弹药——FSST、ALP、FastLanes、BtrBlocks——则保证了这场竞赛至少在未来五年内不会缺乏变量。
“Parquet 已死”是错的;“Parquet 永生”同样不严谨。更准确的表述或许是:Parquet 正在从”创新的载体”变成”兼容的基座”,而创新的战场已经转移到格式与引擎的边界、编码与计算的融合、以及 AI 原生的数据布局上。 对从业者而言,真正需要跟踪的不是”谁杀了 Parquet”这种戏剧化叙事,而是那条更安静的主线:编码正在成为贯穿存储、传输、计算三态的一等公民——谁先把这件事做完整,谁就定义下一个十年。
附录 A:关键量化数据速查(均注明来源口径)
| 数据点 | 数值 | 来源 |
|---|---|---|
| ALP 压缩率 | 比 Gorilla 高 ~50%、比 Chimp128 高 ~24%、≈ ZSTD-3 | SIGMOD 2024 论文 |
| ALP 解码吞吐 | ~2.6 元组/周期(Patas 0.157 / Gorilla 0.047 / Chimp128 0.040) | SIGMOD 2024 论文 |
| DuckDB 采用 ALP 后 | 解压比 Patas 快 2–4×,压缩率翻倍 | DuckDB 披露 |
| FastLanes 标量解码 | >1000 亿整数/秒 | VLDB 2023 论文 |
| FastLanes 布局收益 | 8-bit 标量解码快 ~8×;SIMD 相对标量 40–70×(8-bit) 到 3–4×(64-bit) | VLDB 2023 论文 |
| Vortex vs Parquet+zstd | 随机访问 ~100–200×、扫描 ~2–10×(官方亦称 10–20×)、写入 ~5×、压缩率相当 | Vortex 官方 |
| Microsoft Iceberg 换 Vortex | TPC-DS SF1000:运行时 -30%、存储 -20% | Microsoft 试验 |
| Lance 随机访问 | 宣称比 Parquet 快 1–2 个数量级 | Lance 论文/官方 |
| ClickHouse LowCardinality | 低基数串列存储降 ~3–10×;DoubleDelta+ZSTD 时序可达 1:800+ | ClickHouse 文档 |
| Parquet Footer 解析(10 万列×20 RG) | 3380ms → 1016ms(arrow-rs 优化) → 367ms(去统计) | Community Over Code 分享 |
| FlatBuffers 元数据(2.9 万列×78 RG) | 367MB → 50.4MB(-86%),解析 ~40× | Databricks 生产案例 |
| GPU 重写 Parquet | ~1GiB/s → 125GiB/s(4×NVMe) | DaMoN 2026 论文 |
| Vector 三层 LIST vs FixedSizeList | 读取性能约 1/3 | 社区测试(提案讨论中) |
附录 B:参考文献精选
奠基论文:Abadi et al., Integrating Compression and Execution in Column-Oriented Database Systems, SIGMOD 2006;Zukowski et al., Super-Scalar RAM-CPU Cache Compression, ICDE 2006;Lang et al., Data Blocks, SIGMOD 2016;Ghita/Tomé/Boncz, White-box Compression, CIDR 2020;Melnik et al., Dremel, VLDB 2010。
第二波编码:Boncz/Neumann/Leis, FSST: Fast Random Access String Compression, VLDB 2020;Afroozeh/Kuffó/Boncz, ALP: Adaptive Lossless Floating-Point Compression, SIGMOD 2024;Afroozeh/Boncz, The FastLanes Compression Layout, VLDB 2023 及 The FastLanes File Format, VLDB 2025;Kuschewski et al., BtrBlocks: Efficient Columnar Compression for Data Lakes, SIGMOD 2023;Gorilla (VLDB 2015)、Chimp/Chimp128 (VLDB 2022)、Patas 等浮点前驱。
格式与系统:Chattopadhyay et al., Shared Foundations: Modernizing Meta’s Data Lakehouse(Alpha/Nimble), CIDR 2023;Lance: Efficient Random Access in Columnar Storage through Adaptive Structural Encodings;Vortex(vortex-data / LFAI&Data, 2025–);Zeng et al., An Empirical Evaluation of Columnar Storage Formats, VLDB 2023;Do GPUs Really Need New Tabular File Formats?, DaMoN 2026;Accelerating GPU Data Processing Using FastLanes Compression, DaMoN 2024;Meta, Composable Data Management at Meta, 2024;DuckDB Vortex 扩展公告(2026-01);Apache Parquet/Iceberg/GeoParquet 规范与社区讨论;相关中文深度解析(知乎”Lance:针对机器学习的新兴文件格式中最具影响力的新贵”、“计算引擎中的列编码深度调研报告”、《Parquet 已死?AI 时代列式巨人的进化与反击》)。
