DeepSeek 被指纹测出是 GPT-6?可信吗?
自我介绍
大家好,我是Aaron。过去一直从事算法领域相关工作,自工作以来,一直持续在关注算法相关技术的发展,当前除了在工作中会进行一些AI的落地实践,工作之余也在通过AI辅助编程做一些有趣的探索。我会持续更新AI实践过程中的心得体会,以及AI知识分享。欢迎大家关注我关注公众号,以便第一时间收到更新推送。
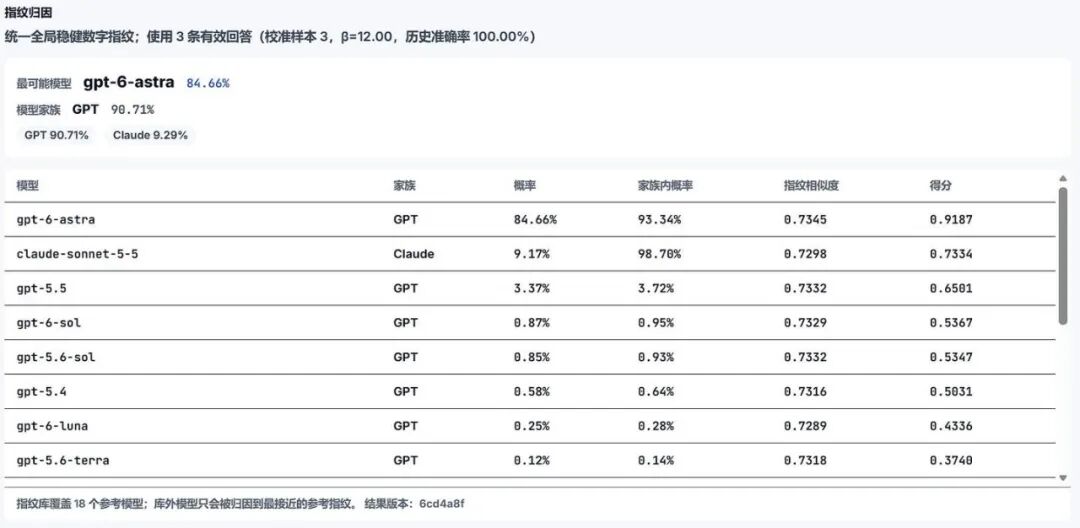
最近一张截图在圈子里流传:有人用开源工具 ModelTrace 测试 DeepSeek V4.1-Flash-1017,工具给出的判定是——gpt-6-astra,置信度 84.66%,模型家族 GPT,概率 90.71%。
评论区立刻炸了。有人说「实锤了,DeepSeek 就是套壳 GPT」,也有人说这工具纯扯淡。
我把 ModelTrace 的源码翻了一遍,又读了它参考的那篇论文(arXiv:2607.10252,One Token Is Enough)。
先说我的结论:这个工具的原理是正经的、有论文背书的;但「测出 GPT-6」这个解读,大概率是错的。
一、让 AI「随便说个数」,它就露馅了
先做个思想实验。我说「随便想一个 1 到 10 的数」,你会想几?
心理学早就做过这类实验:人类嘴上说随机,其实一点也不随机。选 7 的人异常地多,选 1 和 10 的人异常地少,因为大家潜意识里觉得「个位数太刻意,7 显得随机」。大模型更严重。
模型的每个字都是从概率分布里抽出来的。让它报一个随机数,它不是在掷骰子,是在自己训练时见过的数字偏好上采样。人类语料里的数字偏见,加上训练流程的种种细节,会在它身上留下稳定的痕迹。
这篇论文给了一个特别直观的数字:让模型在 1 到 100 里随机报数,如果真随机,答案分布的「熵」应该约为 6.6 比特。实测多少?中位数只有 1 比特。
换成人话:模型翻来覆去就爱报那几个数。你以为它在一百个数里随便挑,它其实在心里的小本本上有个固定偏爱名单。
更要紧的是,每个模型的偏爱名单都不一样,而且稳定。这就像每个人的笔迹——字都认识,落笔的轻重习惯骗不了人。
二、ModelTrace 怎么测:三百个数字里的「笔迹」
ModelTrace 的做法很朴素,我看完源码后总结成三步。
第一步,出题。 它生成三条挑战,每条都让模型「凭第一反应直接写出约 300 个 1 到 355 的整数」,并且反复强调:不许用代码、不许找规律、不许排序去重、允许重复。这一步的目的是逼模型交出它最原始的数字偏好。
第二步,提取特征。 源码里主要算两样东西:
一是频率指纹。统计 355 个数字各出现了几次,形成一个分布。哪个模型爱报 47、哪个爱报 289,各有各的口味。
二是位置指纹,这是它比较聪明的地方。源码把整串数字按位置切成四段,分别统计每段的分布,还加了末位数字的分布。因为有的模型开头爱报大数、写到后面越来越保守——这种「前后不一致的偷懒」也是身份特征。
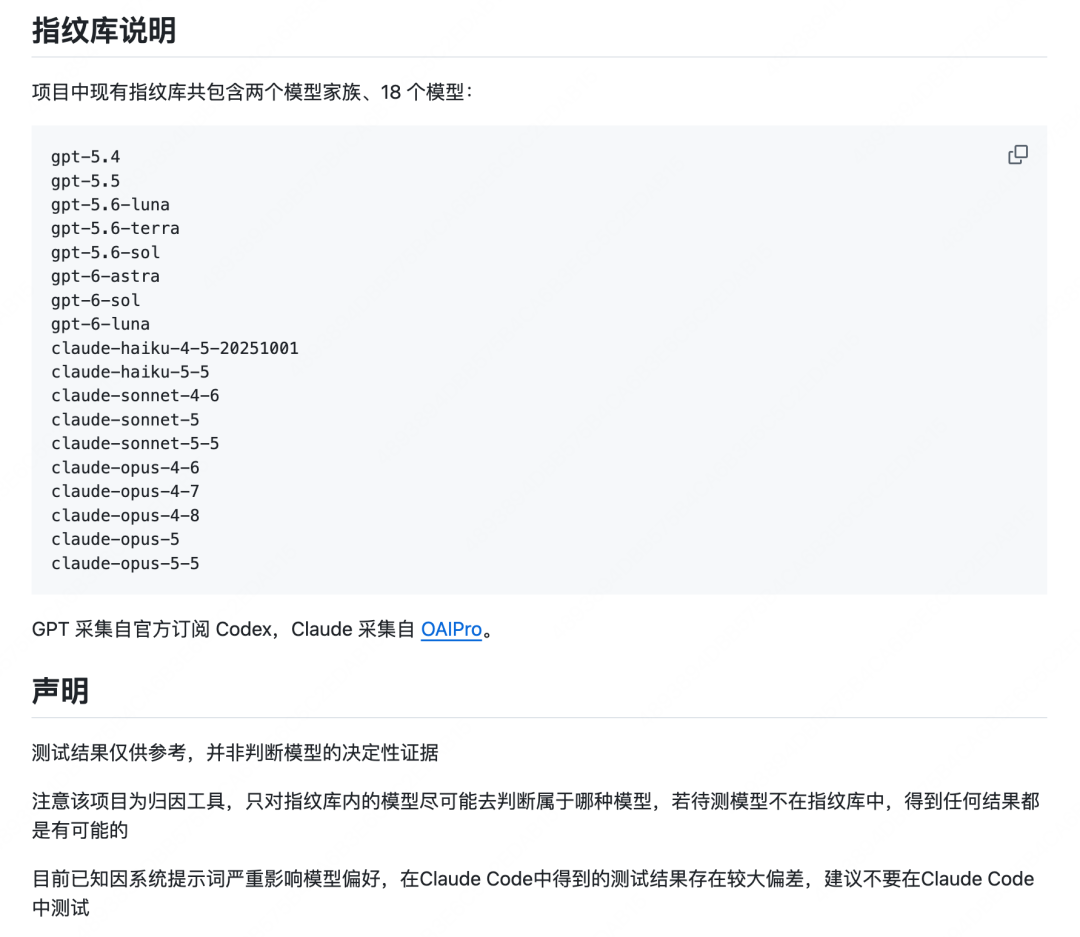
第三步,比对。 项目维护者预先采集了 18 个模型的参考指纹(9 个 GPT 系、9 个 Claude 系),把你的测试结果和这 18 个「标准笔迹」一一比对,算出一个 softmax 概率:你最像谁。
测试者拿 DeepSeek 去测,工具的回答是:在 18 个候选里,最近的笔迹属于 gpt-6-astra。
三、论文做了什么:一个 token 就够了
ModelTrace 的 README 致谢了一个数字检测项目,而它的核心思想,和这篇 2026 年 7 月的论文高度同源。论文的标题就够狂的:《一个 token 就够了》。
作者 Tomáš Bruckner 的思路比 ModelTrace 更极简:连 300 个数都不要,就问一句「1 到 100 之间随机说一个数」,模型一个 token 就答完了。同一个问题反复问、换四种语言问,答案的分布就是指纹。
他的实验规模不小:通过 OpenRouter 测了 165 个模型,发出约 32.6 万次请求,总成本不到 35 美元。
其中三条,跟今天这件事直接相关:
指纹真实存在。 同一个模型的数据对半劈开,两半的距离比「不同模型之间」近一个数量级。也就是说,指纹的稳定性经得起检验。
家族可以辨认。 用指纹之间的距离做家族分类,准确率 59.5%——听起来不高,但随机瞎猜只有 18.4%,信号是显著存在的。
可以做「1 比 1 验身」。 类似手机指纹解锁的思路:先声明「这个接口应该是模型 X」,再用探测数据验证。这套协议的等错误率能压到 7.3%。
最有戏剧性的是生态审计的发现:某个挂着专有品牌旗舰名号的商用端点,其行为分布与一个开源 Qwen 模型完全无法区分。翻译一下:有商家疑似拿开源模型冒充自家旗舰卖钱,被「数字笔迹」当场抓了个正着。
这类技术值钱的地方就在这儿:你付钱买的是 A 模型,接口背后跑的可能还是 B。以前没人验得了,现在花几十美元就能把整个市场扫一遍。
四、那 DeepSeek 真是 GPT 吗:三个疑点
回到开头那张截图。如果原理这么靠谱,「DeepSeek 测出 GPT-6」是不是就实锤了?
我的判断是:恰恰相反,这张截图几乎说明不了任何问题。三个疑点。
疑点一:这是一场「18 选 1」的强制选择题。
ModelTrace 的库里只有 GPT 和 Claude 两个家族、18 个模型,没有 DeepSeek、Gemini、Qwen,什么都没有。算法是闭集归因——不管你测的是谁,它都得在 18 个候选里挑出一个「最像的」。
项目作者其实在 README 里写得很明白:「若待测模型不在指纹库中,得到任何结果都是有可能的」「测试结果仅供参考,并非判断模型的决定性证据」。
所以那张截图的正确读法是:在只有 GPT 和 Claude 的候选池里,DeepSeek 的数字笔迹离 GPT 系更近。 这顶多算「排除了 Claude」,离「认定是 GPT」差着十万八千里。
疑点二:概率的「自信」是放大器制造出来的。
看截图里的细节:第一名相似度 0.7345,第二名 0.7298,最后一名也有 0.7289——所有候选挤在一条极窄的缝里,谁跟谁都没拉开差距。
但工具敢报 84.66% 对 9.17%,看着很笃定。为什么?因为背后有个校准参数 β=12,它会把本来微小的得分差距指数级放大。这个 β 是在「库内模型互相区分」的测试上调出来的——截图里那句「历史准确率 100.00%」,指的是库里 18 个模型互相测试全对,不是对陌生模型的判断准确率。
拿图书馆里 100% 的考试成绩,去证明它能鉴定一个从没见过的陌生人,这是两码事。
疑点三:连「像 GPT」这个信号本身也不太干净。
项目 README 承认,系统提示词会严重影响模型的数字偏好。测试环境的差异、参考数据采集渠道的不同(GPT 采自官方订阅,Claude 采自第三方转发商),都可能让家族对比带上系统性偏差。
五、更可能的真相:数字偏好会「传染」
「套壳实锤」排除掉了,还剩一个真问题:为什么 DeepSeek 的随机数行为,在统计上真的更接近 GPT 系(家族概率 90.71% 比 9.29%)?
我认为最有意思的解释是:训练数据的传染。
业界用强模型生成合成数据来训练新模型,是公开的秘密。如果 DeepSeek 的训练语料里含有大量 GPT 系模型生成的文本,那么 GPT 的数字偏好就会像口音一样「传染」给学生模型。
注意,随机报数是个没有语义的任务,没有任何对齐训练会去纠正它「你报 7 的频率不对」。所以教师模型留下的这种痕迹,反而最完整地保存了下来。
但这里必须踩一脚刹车:「指纹像」推不出「蒸馏了」。
能让两家模型指纹相近的解释,至少有五种:直接用 GPT 的输出做蒸馏训练;用 GPT 生成合成语料;两家都继承了人类偏爱 7、37、42 的共同先验;爬过同一批网页、语料生态重叠;又或者,干脆就是附图那种「18 选 1」闭集归因制造出来的最近邻假象。
这五种解释都会让指纹变像。手头的证据,分不出是哪一种。
甚至可以更损一点:附图那个 84.66% 本身就是闭集最近邻的产物(第一名和最后一名相似度只差 0.006),连「指纹真的像」都得先打个问号,才轮得到讨论为什么像。
六、什么证据才算数:给「蒸馏判定」分三级
你可能在别处看到更耸动的说法。下次再有人声称「DeepSeek 蒸馏了 GPT」,先看他拿的是什么级别的证据。
及格线:从官方渠道采集 DeepSeek 自身指纹入库,重新归因,做 1 比 1 验证。先确认它和 GPT 的「像」不是工具制造的假象。
合格证据:不止随机数。在文风、代码风格、错误模式等多个行为维度上做分布检验,全都指向同一个方向。
实锤证据:训练语料审计、数据清单这类内部证据。模型谱系的实锤,历来都出自这一级,而它只有厂商自己拿得出来。
行为指纹测的是表层习惯,天然是这三级里最弱的一层。数字笔迹像,最多说明沾过同一个老师的墨水;至于是谁、怎么沾的、沾了多少,这个工具回答不了。
参照系是论文里那个「疑似 Qwen 冒充旗舰」的案子:它成立,靠的是分布等价性检验,两个分布真的到了「无法区分」的程度。而截图里 0.73 左右的相似度,离「无法区分」还远得很。
七、这个工具到底能信到什么程度
把话说全,免得你用错地方。
它能干的: 怀疑某个 API 转发商偷偷换了模型?把可疑模型的真实指纹采进库,再测,非常有用。论文已经证明这条路线能抓到真·李鬼。对普通用户,它也是一个便宜的「渠道验真」工具。
它不能干的: 拿一个库外模型去测,然后宣布「某某是某某套壳」。库外的一切都会被强行贴上库内标签,概率再高,也只是「最不像错误答案的那个答案」。
这也是我写这篇文章最想传达的一件事:工具输出的数字形态越精致(84.66%、90.71%、100% 准确率),越要追问这些数字是在什么范围内算出来的。 闭集归因的开箱即用,和开集验证的严谨结论,中间隔着一整个论文的工作量。
数字不随机这件事是真的,AI 有「笔迹」也是真的。但认笔迹之前,先得把嫌疑人的笔迹样本收齐了。
你觉得 DeepSeek 像 GPT 的原因是什么? 是数据传染、英雄所见略同,还是别的什么?评论区聊聊——下一篇我打算讲讲论文里那桩「Qwen 冒充旗舰案」的完整审计过程。
附:信息来源
-
ModelTrace 项目:github.com/xqy2006/ModelTrace(README 免责声明、指纹库构成、核心算法均来自其源码 fingerprint.py / bank_builder.py)
-
论文:Bruckner, One Token Is Enough: Fingerprinting and Verifying Large Language Models from Single-Token Output Distributions, arXiv:2607.10252
