一、DSpark 的出场背景
2026 年 7 月,DeepSeek 团队发布了 DSpark(Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation,arXiv:2607.05147)。这不是一篇只讲方法的论文——它附带了一个关键信息:DSpark 已经部署在 DeepSeek-V4 的真实线上流量中(Flash 和 Pro 两个版本)。
在推理加速这个领域,“发论文”和”上生产”之间的距离往往很远。很多方法在实验室基准上很漂亮,一到真实的高并发服务环境就出问题:batch capacity 被浪费、延迟抖动、吞吐量悬崖式下跌。DSpark 的特殊之处在于,它是第一个在生产级线上服务中大规模验证推理加速效果的工作——DeepSeek-V4 的数亿级用户流量数据,比任何实验室 benchmark 都更有说服力。
但 DSpark 的技术价值不止于”能上线”。它提出了两个紧密耦合的创新:半自回归草稿生成和置信度调度验证,分别解决推理加速的”草稿端”和”验证端”两大瓶颈。这一篇我们就深入拆解这两个机制的设计动机、数学形式和工程细节。
二、DSpark 要解决的两个瓶颈
在理解 DSpark 的方案之前,必须先理解它瞄准的问题——这两个问题不是”准确率不够高”这种笼统描述,而是有精确的数学和系统层面的定义。
2.1 瓶颈一:并行草稿的”结构性不连贯”
DFlash(包括 DFlash 2)用并行扩散模型做草稿,所有位置同时去噪。这种并行性的代价是:块内 token 之间没有条件依赖。
具体来说,对于块内第 i 个位置,它的输入包括:
-
已验证上下文(通过目标模型 KV 注入)
-
位置 i 自身的噪声/掩码输入
-
(如果是双向 attention)块内其他位置的噪声/掩码输入
注意最后一点:第 i 个位置能看到其他位置的噪声输入,但看不到它们的最终输出。它不知道位置 1 最终选了”Paris”还是”London”,它只看到位置 1 是一个被掩码的 token。
这导致了一个微妙的后果:即使 DFlash 2 的路径选择器从 top-k 里挑出了连贯的组合,这个”连贯性”也是基于独立产出的候选做的后验选择。选择器本身没有看到”如果位置 1 选了 Paris,位置 2 的条件分布会如何变化”——它只是在已有的独立候选里挑搭配。
从概率图模型的角度看,DFlash 系列建模的是边缘分布的乘积 ∏ P(x_i | context),而不是链式条件分布 P(x_1 | context) × P(x_2 | context, x_1) × P(x_3 | context, x_1, x_2) × ...。前者快但弱,后者慢但强。
DSpark 的洞察是:如果我们能以一种极轻量的方式引入链式条件依赖,也许可以在”足够快”和”足够准”之间找到新的平衡点。
2.2 瓶颈二:验证端的”盲目验证”
传统推理加速方法有一个隐含假设:草稿生成多少个 token,验证就过多少个。比如草稿模型生成了 16 个 token,目标模型就把这 16 个全部验证一遍。
这个假设在高并发服务中代价很大,原因在于推理加速的截断规则:
从第一个被拒绝的 token 开始,后面所有 token 都不需要再看——它们被”连带作废”。
假设目标模型验证 16 个 token,发现第 5 个 token 被拒绝。那么第 6–16 个 token 的验证计算完全是白算的。更严重的是,在高并发场景下,这些”白算”占用了宝贵的 batch slot,导致其他请求无法被及时处理,整体吞吐量暴跌。
理想情况下,系统应该根据每个 token 的存活概率(即”该位置及之前所有位置都被接受的概率”)来决定验证多长。如果存活概率曲线在第 7 个位置就跌到 20%,那验证到第 6 个位置就截断,后面的不验证——这样既省了算力,又不影响正确性(因为本来也通不过)。
DSpark 的置信度调度就是做这个决策的。
三、核心创新一:半自回归架构
DSpark 的草稿模型不走纯并行也不走纯串行,而是两者结合。论文把这种架构称为 Semi-Autoregressive Generation(半自回归生成)。
3.1 架构设计:并行骨架 + 轻量顺序头
下面这张图来自 DSpark 论文,清晰展示了整个推理流程:
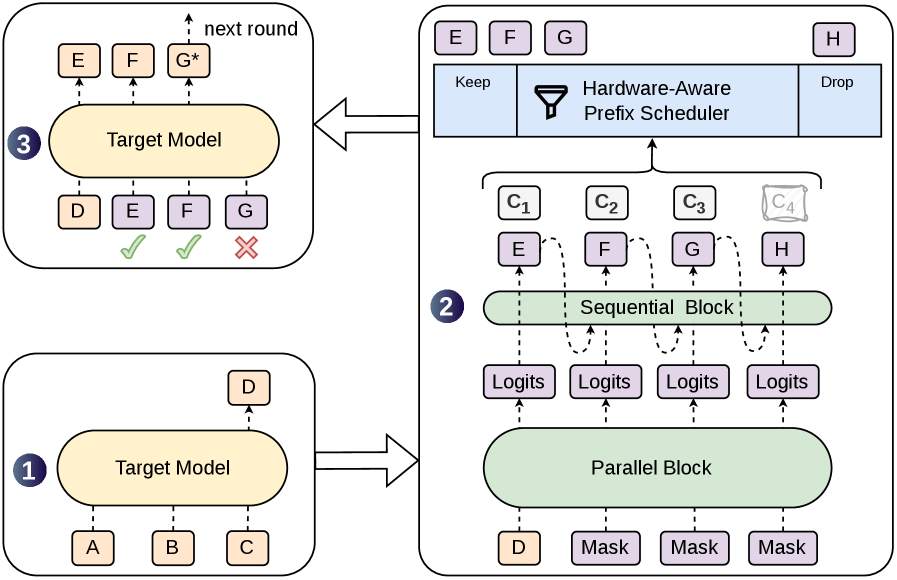
DSpark 方法总览:从目标模型特征提取到半自回归草稿生成,再到硬件感知调度验证
流程分为三步(对应图中编号):
-
Step 1 — 目标模型提取上下文特征:Target Model 对已验证的 token(A, B, C)做前向传播,提取深层特征 D 作为草稿的条件输入。
-
Step 2 — 半自回归草稿生成:
-
Parallel Block(并行块):以 D 为条件,一次性并行生成所有 mask 位置的基础 logits。
-
Sequential Block(顺序块):用 Markov Head 或 RNN Head 逐位置精修,把前一个位置的输出作为当前位置的额外输入(图中的虚线箭头),注入 token-to-token 依赖。
-
Confidence Head:输出每个位置的存活概率 C₁, C₂, C₃, C₄。
-
Hardware-Aware Prefix Scheduler:根据置信度和系统负载决定验证多长——Keep(E, F, G)、Drop(H)。
- Step 3 — 目标模型验证:Target Model 并行验证 D, E, F, G,E 和 F 通过(✓),G 被拒绝(✗),下一轮从 G* 开始。
DSpark 的草稿模型核心在于两层:
第一层:Parallel Backbone(并行骨架)
这是一个标准的 Transformer 网络,接收目标模型的多层特征作为条件输入,一次性并行生成块内所有位置的基础 logits。这一步和 DFlash 的并行 Backbone 类似,速度极快。
第二层:Sequential Refinement Head(顺序精修头)
在并行骨架的输出上,接一个轻量的顺序输出头。论文提到了两种实现:
-
Markov Head:基于马尔可夫假设,只考虑前一个位置的输出对当前位置的影响
-
RNN Head:用一个轻量 RNN 顺序处理并行骨架的输出,捕获更长的依赖
顺序头做的事情很简单:对于位置 i,它接收并行骨架输出的 logits_i 和前一个位置的最终输出 token,然后输出一个修正后的分布。
用公式表示:
// Parallel Backbone(一次前向,并行产出)
base_logits[1:N] = ParallelBackbone(target_features, masked_tokens)

// Sequential Head(逐位置串行修正)
for i = 1 to N:
    refined_logits[i] = SequentialHead(base_logits[i], token[i-1])
    token[i] = argmax(refined_logits[i])  // 或采样
3.2 为什么是”半”自回归
注意这里的关键:并行骨架只做一次前向传播,顺序头只是在一个极小的输出空间(每个位置的 logits)上做轻量修正。这和 EAGLE-3 那种”每个位置都要过一次完整 Transformer”的纯自回归完全不同。
从计算量的角度:
-
EAGLE-3:生成 N 个 token 需要 N 次完整的 Transformer 前向传播(虽然模型只有 1 层,但每次都要算 attention + MLP)
-
DFlash:生成 N 个 token 需要 1 次前向传播(并行)
-
DSpark:生成 N 个 token 需要 1 次完整前向传播 + N 次顺序头的轻量计算
顺序头的计算量远小于完整 Transformer 层——论文说它只增加”轻微的串行延迟”,整体延迟仍在可接受范围内。
3.3 接受率曲线的”缝合”效果
论文用一张非常直观的图展示了三种方法的逐位置接受率对比:
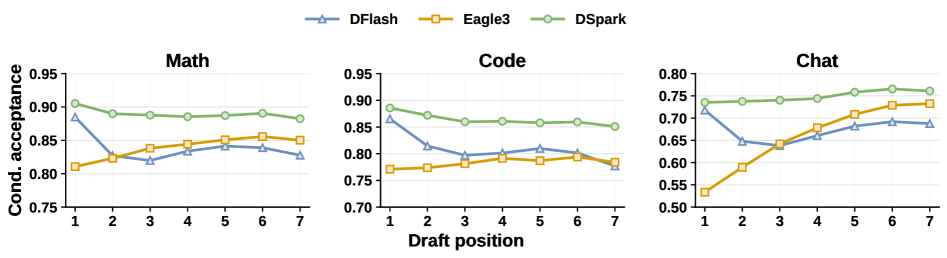
逐位置条件接受率:DFlash vs EAGLE-3 vs DSpark
这张图告诉我们三个故事:
Math 任务(左图):
-
DFlash(蓝三角):第 1 位置约 0.89,快速衰减到第 7 位置的约 0.82。“块尾衰减”清晰可见。
-
EAGLE-3(黄方块):第 1 位置约 0.81(低于 DFlash),但尾部稳定在约 0.84。自回归的”起步慢但后劲足”。
-
DSpark(绿圆圈):在每个位置都最高——第 1 位置约 0.91,第 7 位置约 0.88。成功”缝合”了两者的优点。
Code 任务(中图):类似的 pattern,DSpark 全程领先。
Chat 任务(右图):这里最有意思。DFlash 和 EAGLE-3 在前期交叉——DFlash 起步高但掉得快,EAGLE-3 起步低但追上来。DSpark 在后期(位置 5-7)超越两者,说明在闲聊这种”上下文依赖强、重复 token 多”的场景,顺序头的价值最大。
3.4 不同 Draft Length 的扩展性
论文还测试了不同 draft length(4/8/12/16)下的表现:
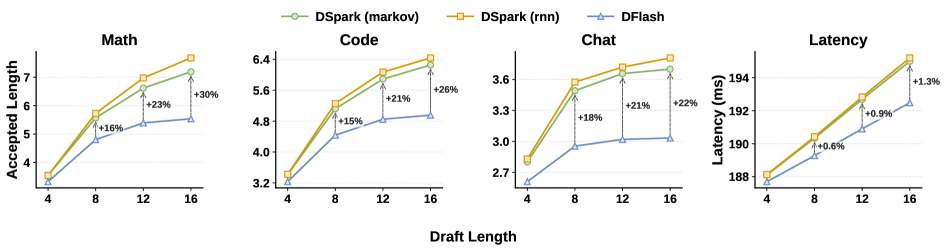
不同 Draft Length 下的接受长度与延迟
关键发现:
-
DSpark 的接受长度随 draft length 持续增长:在 Math 上从 draft length 4 的约 3.5 增长到 16 的约 7.5。而 DFlash 在 12 之后就平台化了(约 5.5)。这说明半自回归架构没有遇到并行模型的块大小天花板——因为顺序头给每个位置补上了依赖信息,块可以做得更长而不衰减。
-
延迟增加极小:draft length 从 4 增加到 16,DFlash 延迟仅增 0.9%,DSpark(rnn) 仅增 1.3%。顺序头的开销确实非常轻量。
-
DSpark 在三种任务上都领先 DFlash 15–30%。
四、核心创新二:置信度调度验证
如果说半自回归解决的是”草稿生成端”的问题,那置信度调度解决的就是”验证端”的问题。
4.1 问题建模:验证的边际收益
传统推理加速方法中,验证长度 N 是固定的。但最优的 N 应该取决于两个因素:
-
草稿质量:如果草稿质量高(接受率高),验证长一点划算;如果质量低,验证长了白算
-
系统负载:如果系统高并发(batch 满了),每个请求应该少验证几个 token,把 capacity 释放出来给其他请求;如果系统空闲,可以多验证几个
DSpark 把这个问题建模为一个优化问题:给定草稿的存活概率曲线和当前系统状态,选择验证长度 N 使得”单位验证成本的预期收益”最大化。
4.2 Confidence Head:预测存活概率
DSpark 在草稿模型上接了一个轻量的 Confidence Head,它的输出不是 token 分布,而是每个位置的存活概率——即”该位置及之前所有位置都被目标模型接受的概率”。
用数学语言:对于草稿位置 i,Confidence Head 输出 p_i = P(accept_1 ∧ accept_2 ∧ ... ∧ accept_i)。
注意这里预测的是前缀联合概率,不是单个位置的条件概率。这是因为推理加速的截断规则:如果位置 i 被拒绝了,位置 i+1 根本不需要验证。所以”位置 i 的验证是否值得”取决于”位置 1 到 i 都被接受的概率”。
4.3 校准:让预测可信
Confidence Head 的输出必须经过校准(calibration),确保预测的存活概率和实际观察到的接受率一致。论文用可靠性图(reliability diagram)展示了校准效果:
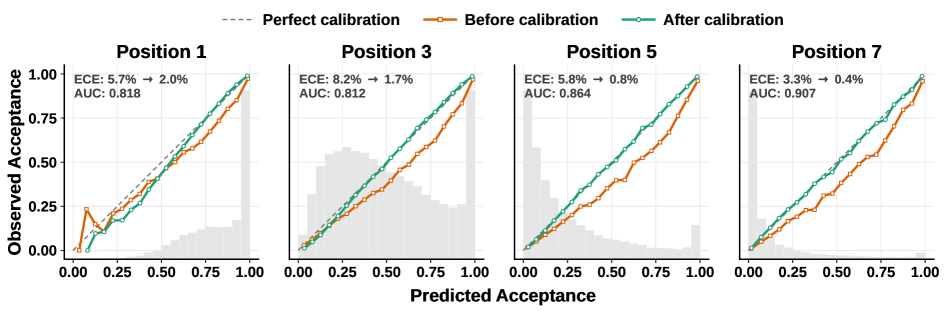
Confidence Head 校准效果
-
橙色(校准前):预测的存活概率系统性偏高。比如预测 0.5 的存活概率,实际只有约 0.35 被接受。ECE(Expected Calibration Error)在 Position 3 高达 8.2%。
-
绿色(校准后):预测曲线紧贴完美校准线(虚线)。ECE 降到 0.4–2.0%。
-
AUC 也随位置增加而提升(0.818 → 0.907),说明 Confidence Head 对靠前位置的区分能力较弱(因为前面几个 token 的存活概率都很高,难分高下),但对靠后位置的区分能力越来越强——而这正是调度器最需要的(决定是否截断的关键位置)。
4.4 Hardware-Aware Scheduler:动态截断
Scheduler 的核心逻辑是:
给定:
  - 存活概率曲线 [p_1, p_2, ..., p_N]
  - 当前系统负载(batch utilization)
  - 目标模型验证一个 token 的成本 c_verify
  - 草稿模型生成一个 token 的成本 c_draft

目标:选择截断点 k,使得
  E[加速比 | k] = (accepted_tokens) / (draft_cost + verify_cost)
最大化
Scheduler 的关键设计是异步执行:它不阻塞 GPU 流水线来做调度决策,而是利用前两步的历史预测和系统统计信息来快速估算当前的最优截断点。这兼容 DeepSeek 的零开销调度(ZOS)和连续 CUDA 图回放。
4.5 置信度调度的实际效果
论文用一张图展示了不同置信度阈值下的效果:
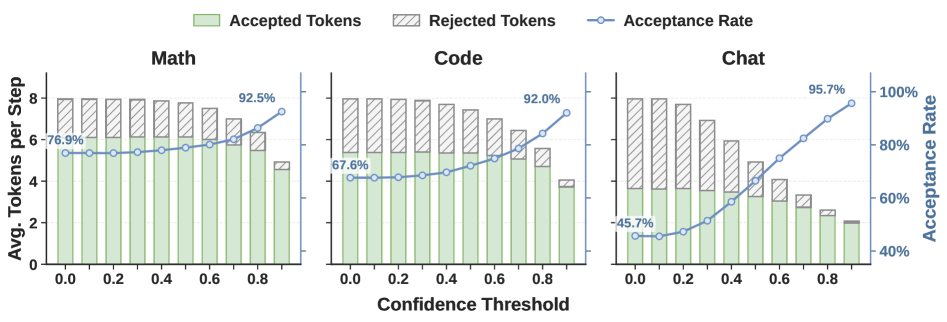
置信度阈值调度效果
横轴是 Confidence Threshold(阈值),从左到右越来越严格。纵轴左是每步平均 token 数(绿色=被接受的,灰色=被拒绝的),纵轴右是接受率(蓝线)。
三个任务呈现不同的 pattern:
-
Math(左图):阈值 0 时平均接受 5.2 个 token,接受率 76.9%。阈值提到 0.9 时只接受约 4.5 个 token,但接受率飙升到 92.5%。这意味着丢弃高风险尾部 token,换来了更高的”命中率”。
-
Code(中图):类似,最终接受率 92.0%。
-
Chat(右图):效果最显著。阈值 0 时接受率仅 45.7%(接近抛硬币),阈值提到 0.9 时接受率达到 95.7%。这说明闲聊场景的草稿尾部质量极不稳定——聊天中话题跳转、语气变化大,靠后的草稿 token 很容易偏离目标模型的分布。置信度调度在这里的价值最大。
核心洞察:不同任务类型的”最优验证策略”差异巨大。固定验证长度的方法(如传统推理加速方法、DFlash)对所有任务一视同仁,而 DSpark 的调度器能根据任务类型和实时负载动态调整——这是它能在生产环境中表现出色的关键原因。
五、线上部署效果
DSpark 已部署在 DeepSeek-V4 的服务系统中。论文提供了线上真实流量的 Pareto 前沿图:
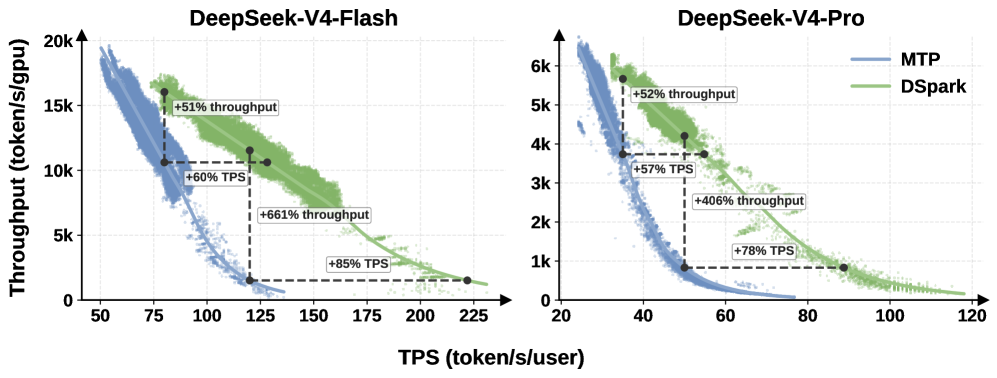
DeepSeek-V4 线上 Pareto 前沿
横轴是单用户 TPS(token/s/user),纵轴是总吞吐(tokens/s/gpu)。越靠近右上角越好(高单用户速度 + 高总吞吐)。
-
DeepSeek-V4-Flash(左图):在匹配 TPS 的条件下,DSpark 的吞吐比 MTP 基线提升 51% 到 661%;在匹配吞吐的条件下,单用户速度提升 60% 到 85%。
-
DeepSeek-V4-Pro(右图):吞吐提升 52% 到 406%,单用户速度提升 57% 到 78%。
更关键的是”性能悬崖”的突破。在 MTP 基线中,当单用户 TPS 达到某个阈值后,总吞吐会急剧恶化(曲线急剧下降)。而 DSpark 的曲线更平缓,在严格 SLA 区域(Flash 约 120 TPS,Pro 约 50 TPS)仍能保持稳健表现。
论文还展示了 Verification Budget 随并发请求数的变化:
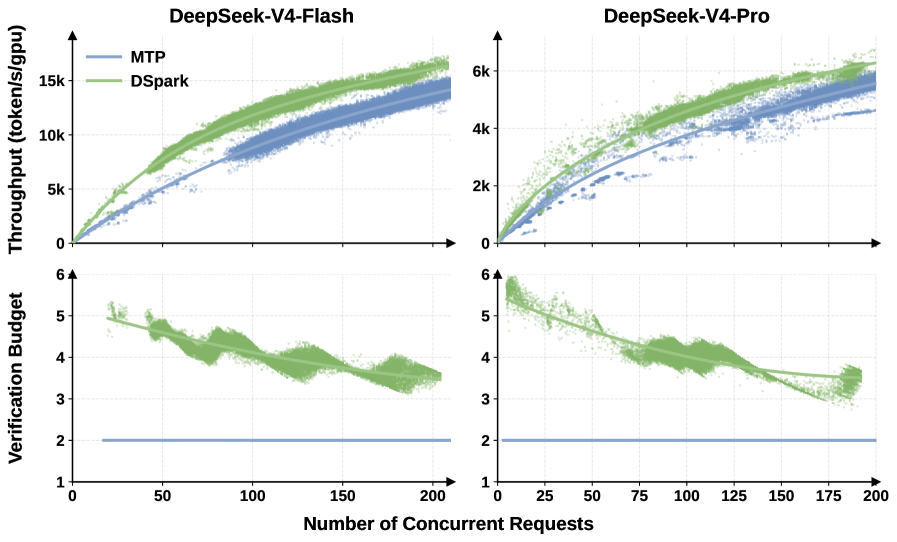
吞吐量与验证预算随并发变化
上图:吞吐量随并发增加。DSpark(绿)始终高于 MTP(蓝),高并发下差距更大。 下图:Verification Budget(每个请求验证多少个 token)。MTP 是固定的水平线(约 2 个),而 DSpark 随负载动态调整——低负载时预算约 5,高负载时降到约 3.5。
这就是”好钢用在刀刃上”的工程体现:负载轻时多验证几个 token(batch capacity 充足),负载重时减少验证(把 capacity 留给更多请求)。
六、方法论层面的反思
DSpark 和 DFlash 2 代表了推理加速的两条不同路线。理解它们的分野,对工程决策很有价值。
| 维度 | DFlash 2 | DSpark |
|---|---|---|
| 核心哲学 | 并行是优势,不要动它,做轻量后处理 | 并行的结构性缺陷光靠后处理不够,必须引入顺序性 |
| 草稿生成 | 纯并行(块扩散) | 半自回归(并行骨架 + 顺序头) |
| 依赖建模 | 路径选择器(宏观候选选择)+ 动态卷积(微观局部平滑) | 顺序头(链式条件依赖) |
| 验证端 | 固定长度验证 | 置信度调度动态截断 |
| 系统级优化 | 较少涉及 | Confidence Head + Hardware-Aware Scheduler |
| 延迟开销 | 约 +1% | 轻微串行开销 + 调度器开销 |
| 生产部署 | 快速扩展中(SGLang/vLLM/llama.cpp/Ollama/oMLX) | DeepSeek-V4 线上已验证 |
两种路线没有谁好谁坏,而是面向不同场景的最优解:
-
DFlash 2 更适合”延迟敏感、单次请求”的场景(如本地 Mac 开发、边缘推理),因为它的并行框架延迟极低,且没有串行模块带来的额外开销。
-
DSpark 更适合”高并发、吞吐优先”的服务场景(如 DeepSeek-V4 的线上 API),因为它的置信度调度能在系统层面做全局优化,把有限的 batch capacity 用在刀刃上。
有趣的是,mlx-dspark(社区项目)在 Apple Silicon 上的实测显示,对于 Qwen3.8-27B 这个具体模型,DFlash 2 的加速比(4.06×)高于社区 DSpark drafter(2.92×)。但这个对比需要谨慎解读:mlx-dspark 用的是社区发布的 DSpark drafter,不是 DeepSeek 官方 V4 的 drafter,且目标模型不同(消费级 Qwen vs 大规模 MoE V4)。所以这并不是一个公平的 head-to-head,但它提示了一个重要信息:drafter 的质量和目标模型的匹配度,可能比方法本身的优劣更能决定实际效果。
七、系列导读
DSpark 用半自回归 + 置信度调度,在草稿端和验证端同时做了创新,并成功部署在生产环境中。但它不是凭空出现的——它的”并行骨架”思路直接继承自 DFlash,而”顺序头”则是对 EAGLE-3 自回归路线的借鉴。
下一篇:DFlash:用扩散模型给大模型推理”开涡轮增压”
DFlash 是 DFlash 2 和 DSpark 的共同前身。它第一次证明了:用块扩散模型替代自回归草稿,可以让草稿模型做深(5+ 层)而不过度增加延迟。它的核心创新是”KV 注入”——不是把目标模型特征作为输入 embedding,而是作为 KV cache 的前缀直接注入每一层。这一设计使得 DFlash 可以安全地做深,而 EAGLE-3 只能做 1 层。
再往后:EAGLE-3:从特征预测到 Token 预测,解锁 Scaling Law
