一、DFlash 的历史定位
2026 年初,Z Lab(UC San Diego / 北京大学团队)发布了 DFlash,论文标题很直接:DFlash: Block Diffusion for Flash Speculative Decoding(arXiv:2602.06036,ICML 2026)。
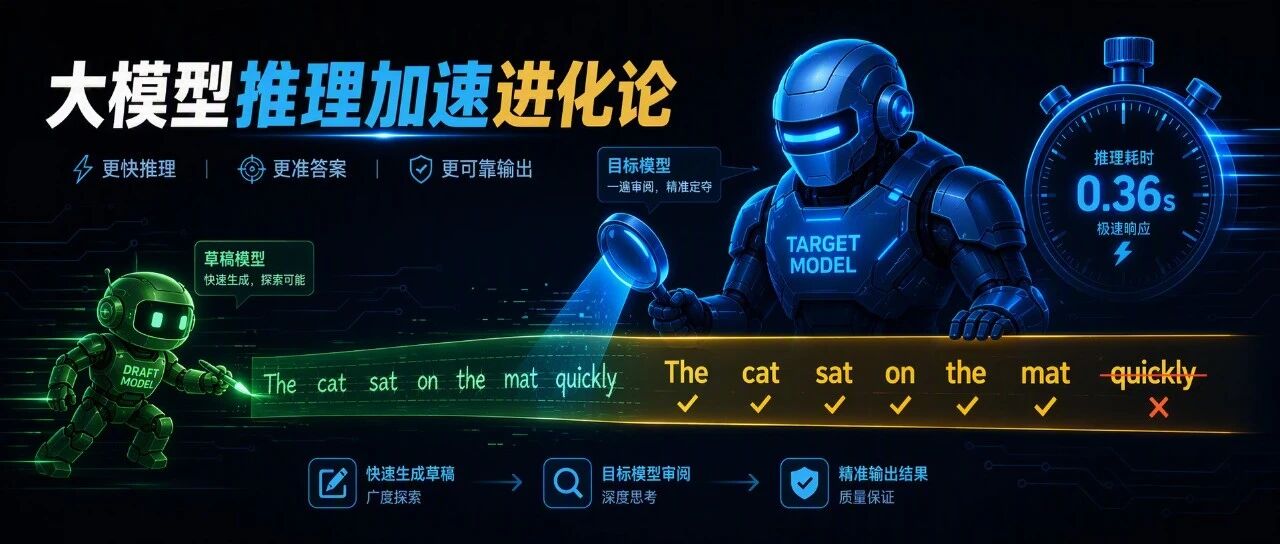
在这篇论文之前,推理加速领域的主流是 EAGLE-3 路线——用目标模型的特征训练一个极浅(通常 1 层)的自回归草稿模型。EAGLE-3 已经很成功了,但它有一个结构性天花板:自回归草稿生成 k 个 token 要算 k 次,所以草稿模型不能做深,否则草稿生成本身就变成瓶颈了。
DFlash 的核心问题是:能不能打破这个”逐词串行”的瓶颈,让草稿模型一次并行生成整块 token? 如果可以,草稿模型就可以做深、做快、生成更多 token——整个推理加速的上限就被推高了。
答案是:可以,用 块扩散模型(Block Diffusion Model) 做草稿。
二、推理加速中的带宽瓶颈:为什么逐词生成这么慢
在谈 DFlash 的解法之前,先深入理解问题的根因。
2.1 自回归解码的带宽瓶颈
大语言模型生成文本时,每生成一个 token 都要执行一次完整的前向传播:
输入 token → Embedding → N 层 Transformer → LM Head → 输出 logits → 采样下一个 token这个过程中,计算量其实不大——Transformer 的核心操作是矩阵乘法,现代 GPU 做矩阵乘法的速度极快。真正拖慢速度的是显存带宽:
-
模型有几百亿参数,存放在 GPU 显存中
-
每生成一个 token,都要把所有参数从显存搬到计算核心
-
显存带宽(通常是 1–2 TB/s)远远跟不上计算核心的速度(通常是 100+ TFLOPS)
结果是:GPU 大部分时间不是在”算”,而是在”等数据”——计算核心利用率通常不足 30%。这就是所谓memory-bound(带宽瓶颈)。
2.2 推理加速为什么有效
推理加速的底层原理很巧妙:把 memory-bound 的问题转化为 compute-bound 的问题。
-
草稿模型很小(通常是目标模型的 1/20 到 1/50),搬运它的参数很快
-
目标模型验证时,一次前向传播可以并行检查多个 token(因为 GPU 擅长并行计算)
-
如果草稿猜得准,一次验证就能产出多个 token,相当于把”搬运大模型参数”的成本”均摊”到了多个 token 上
但这里有一个前提:草稿生成不能成为新的瓶颈。如果草稿生成 k 个 token 也要算 k 次(自回归),那草稿模型就必须极浅——否则草稿生成的时间就会吃掉验证节省的时间。
EAGLE-3 的解决方案是”压层数”:只用 1 层 Transformer。代价是草稿模型的表达能力受限——1 层 Transformer 能学到的模式很有限。
DFlash 的问题因此转化为:有没有一种方式,让草稿生成 k 个 token 的成本不随 k 增长?
三、块扩散:让 k 个 token 一次出
3.1 扩散模型在图像上的直觉
扩散模型(Diffusion Model)在图像生成领域已经非常成熟。它的核心思想是:
-
从纯噪声开始
-
一步一步”去噪”,每次迭代让图像更清晰
-
最终从噪声中”恢复”出一张完整的图像
扩散模型的关键特性是并行性:图像上的所有像素在去噪过程中是同时被处理的。你用 100 步去噪一张 1024×1024 的图像,每一步都是对整个图像的并行操作。
把这个思路搬到文本上,就是块扩散(Block Diffusion):
-
把一整块 token(比如 16 个位置)看作”有噪声的图像”
-
每个位置初始是一个特殊的
<mask>token(相当于噪声) -
扩散模型一次性对所有 16 个位置同时”去噪”,输出每个位置的 token 分布
3.2 为什么块扩散的成本与块大小无关
这是块扩散最核心的数学特性。
在自回归模型中,生成 k 个 token 需要 k 次前向传播:
Cost_auto(k) = k × Cost_forward在块扩散模型中,生成 k 个 token 只需要 1 次前向传播:
Cost_diffusion(k) ≈ Cost_forward (与 k 基本无关)为什么?因为扩散模型对块内所有位置做相同的操作——它们共享同一组 attention 计算、同一组 MLP 计算。块内增加更多位置,只是增加了序列长度,而 Transformer 的计算复杂度是 O(L²) 的(L 是序列长度)。对于小 block(如 16),这个增加几乎可以忽略。
论文中的一个关键对比:一个多层 DFlash 生成 16 个 token 的延迟,比一个 1 层 EAGLE-3 生成 8 个 token 还低。这意味着 DFlash 不仅生成的 token 更多,模型更深,速度还更快——这就是并行性的威力。
3.3 文本扩散 vs 图像扩散的关键区别
但直接把图像扩散搬到文本上并不简单,因为文本和图像有本质区别:
| 维度 | 图像 | 文本 |
|---|---|---|
| 表示 | 连续像素值 | 离散 token ID |
| 去噪目标 | 恢复像素值 | 预测 token 分布 |
| 条件信息 | 文本 prompt | 已验证的上下文 token |
| 输出 | 一张图 | 一块 token |
DFlash 的处理方式是:
-
用
<mask>token 作为”噪声”的文本等价物 -
扩散模型的输出不是直接输出 token,而是输出 logits(通过复用目标模型的 LM Head)
-
条件信息通过目标模型的 KV 注入提供(见下一节)
-
单步去噪(single denoising step)——不是像图像扩散那样迭代 50 步,而是只做 1 步
单步去噪是工程上的关键取舍:多步去噪质量更好,但延迟太高。DFlash 选择 1 步去噪 + 通过目标模型 KV 注入提供强条件信息,在质量和速度之间找到了平衡点。
四、KV 注入:让小草稿”站在大模型肩膀上”
DFlash 最具区分度的设计不是块扩散本身,而是如何让小草稿模型获得足够的信息来做出准确的预测。这个设计的核心是一个洞察:目标模型其实早就”知道”接下来该说啥,只是没有明说出来。
4.1 “The Target Knows Best”
研究发现,大模型隐藏层里的特征(hidden features)已经隐含了未来多个 token 的信息。也就是说,师傅在脑子里其实已经有答案的雏形了。
DFlash 的做法是:从目标模型抽特征,喂给小草稿模型当”小抄”。这和 EAGLE-3 的做法类似,但有一个关键区别——怎么喂。
4.2 EAGLE-3 的喂法 vs DFlash 的喂法
EAGLE-3 的做法:
把目标模型的隐藏特征作为输入 embedding 的一部分,加到草稿模型的第一层输入上。然后让信息通过正常的 Transformer 层传播到后面。
问题:信号在传播过程中会衰减。第 1 层能看到完整的 target 特征,第 5 层只能看到被前面层”过滤”后的信号。这正是 EAGLE-3 不敢做深的原因——层数一多,底层的信号就散了。
DFlash 的做法:
把目标模型的隐藏特征直接注入每一层的 KV cache,作为 KV cache 的”前缀”。
代码层面(model.py:369):
k_ctx = self.k_proj(target_hidden)   # 目标特征投影成 Key
v_ctx = self.v_proj(target_hidden)   # 目标特征投影成 Value
k_noise = self.k_proj(hidden_states) # 当前 token 投影成 Key
v_noise = self.v_proj(hidden_states) # 当前 token 投影成 Value

k = torch.cat([k_ctx, k_noise], dim=1)  # 拼接:target KV + noise KV
v = torch.cat([v_ctx, v_noise], dim=1)
4.3 为什么全层注入优于单层输入
EAGLE-3 的”把 target hidden 作为第一层输入”和 DFlash 的”把 target hidden 作为每层 KV 前缀”,看起来只是实现细节的不同,但实际上是架构层面的本质差异。
在 EAGLE-3 中,target hidden 是一个输入信号,它要经过每层的 attention + MLP 才能影响后面的层。这个过程中:
-
信息被 attention 的 softmax 归一化稀释
-
被 MLP 的非线性变换改变
-
被残差连接混合
结果就是:越深的层,target hidden 的原始信号越弱。
在 DFlash 中,target hidden 被投影成 Key 和 Value 后直接拼接到 KV cache 的前缀位置。每一层的 attention 计算时,Query(来自当前 token)都会直接 attend 到这些 target KV 上。这意味着:
-
每一层都直接看到完整的 target 特征
-
信号不随深度衰减
-
草稿模型可以放心地做深(5+ 层),而且接受长度能随层数增长而增长
这就是为什么 DFlash 可以用 5 层 Transformer 做草稿,而 EAGLE-3 只能用 1 层——DFlash 的”全层持久化注入”避免了深层稀释问题。
4.4 从哪层抽特征?
DFlash 不是只抽目标模型的某一层,而是均匀采样多个层,然后把它们的特征拼接后降维。
代码中(build_target_layer_ids,model.py:25):
def build_target_layer_ids(num_target_layers, num_draft_layers):
    if num_draft_layers == 1:
        return [num_target_layers // 2]  # 单层草稿:只抽中间层
    else:
        return list(range(1, num_target_layers - 2,
                          (num_target_layers - 3) // num_draft_layers))
# 多层草稿:从第1层到倒数第3层均匀采样这个设计确保草稿模型能获得目标模型的浅层到深层的全谱信息:
-
低层特征:句法、词法信息
-
中层特征:语义、局部上下文
-
高层特征:全局语义、推理信息
五、DFlash 的训练流程
DFlash 的草稿模型不是从零训练的。它复用目标模型的 embedding 和 LM head,只训练中间的几层 Transformer。
5.1 模型结构
输入:target_hidden(从目标模型抽的多层特征)+ noise_embedding(mask token 的 embedding)

        ↓
   [FC 投影层]  ← 把 target_hidden 融合并投影到草稿维度
        ↓
   [DFlash Draft Model]
   - 5 层 Qwen3DFlashDecoderLayer
   - 每层:DFlash Attention(双向 attention + KV 注入)→ MLP
   - 复用目标模型的 RMSNorm、RoPE
        ↓
   [Target LM Head]  ← 复用目标模型的输出头
        ↓
   输出:每个 mask 位置的 logits
5.2 训练目标
训练时,DFlash 的草稿模型学习的是:给定目标模型的特征和带噪声的上下文,预测被掩码位置的 token。
具体来说:
-
从训练数据中随机选择一段 token 序列
-
把其中连续的若干位置(block)替换为
<mask> -
用目标模型对完整序列做前向传播,提取多层隐藏特征
-
把特征和 mask 序列输入草稿模型
-
计算草稿模型对被 mask 位置的预测和真实 token 的交叉熵损失
这个训练过程和 BERT 的 masked language modeling 很相似,但关键区别是:
-
BERT 的 mask 是随机的、稀疏的
-
DFlash 的 mask 是连续的、成块的(block-wise),模拟推理时”预测未来一整段”的场景
5.3 Anchor Sampling Mask 的妙处
DFlash 的训练还引入了一个技巧:锚点采样掩码(Anchor Sampling Mask)。在训练时,mask block 中会保留一些”锚点”位置不被 mask——这些锚点给扩散模型提供了额外的局部上下文信息,帮助它更准确地预测周围的位置。
这类似于图像修复中的”部分可见像素”:如果你要修复图像中间的一块区域,知道边界上几个像素的真实值会大大提高修复质量。
六、DFlash 的效果
6.1 离线基准
在 Qwen3-8B 上(贪心解码、temp=0):
| 任务 | EAGLE-3 加速 | DFlash 加速 |
|---|---|---|
| GSM8K(数学) | 2.13× | 5.20× |
| MATH-500 | 2.18× | 6.17× |
| AIME24 | 2.25× | 5.91× |
| HumanEval(代码) | 2.27× | 4.75× |
| MT-Bench(对话) | 1.90× | 2.92× |
在数学和代码这类”长思维链”任务上加速尤其夸张。采样(temp=1)和推理模式下也保持约 4.5× 的加速。
6.2 为什么数学/代码任务加速更高
一个值得深入分析的现象:DFlash 在 Math 和 Code 上的加速比(5–6×)远高于 Chat(2.9×)。
原因在于输出结构的可预测性:
-
数学推理:输出通常是高度结构化的——公式、步骤、数字。这些模式有很强的局部规律性,扩散模型很容易学到。
-
代码生成:输出有严格的语法结构——缩进、括号、关键字。这些结构性模式也非常适合并行预测。
-
日常对话:输出更自由、更开放,上下文依赖更复杂,局部规律性更弱。
这说明扩散草稿在结构化输出上特别有优势——而这恰恰是 Agent 和编程助手最需要的场景。
七、DFlash 的方法论意义
DFlash 的发布对推理加速领域有两层深远影响。
7.1 第一层:重新定义了”扩散语言模型”的角色
在 DFlash 之前,扩散语言模型(dLLM)社区的主流方向是:训练一个大型扩散模型,让它直接生成高质量文本,追平甚至超越自回归模型。
DFlash 说:不必这样做。把扩散模型限定在”草稿”这一步,专门优化它做快速、准确的块预测,质量由后面的投机验证来兜底。扩散模型不需要和自回归模型比最终输出质量——它只需要做最会猜的”学徒”。
这个思路打开了一个新方向:也许未来会有越来越多的”专用扩散模型”——它们不是通用生成器,而是特定任务的快速预测器。
7.2 第二层:证明了”并行可以赢过串行”
在 DFlash 之前,推理加速领域的主流共识是:自回归草稿虽然慢,但准确;并行草稿虽然快,但不准。速度和准确率之间有一个不可调和的权衡。
DFlash 打破了这个共识:通过 KV 注入 + 块扩散,它证明了并行草稿可以在保持极快速度的同时,达到甚至超过自回归草稿的准确率(在 Qwen3-8B 上是 EAGLE-3 的 2.4 倍)。
这为后续的 DFlash 2(路径选择器 + 动态卷积)和 DSpark(半自回归)都奠定了基础——如果没有 DFlash 先证明”并行走得通”,后续工作就不会在这个方向上做优化。
八、系列导读
DFlash 用块扩散 + KV 注入,第一次证明了并行草稿不仅可以走得通,还可以走得比自 regression 更快。它是后续所有并行/半并行推理加速方法的”基石”。
上一篇:DSpark:半自回归 + 置信度调度,把推理加速推上生产线
下一篇:EAGLE-3:从特征预测到 Token 预测,解锁 Scaling Law
EAGLE-3 是 DFlash 出现之前推理加速领域的 SOTA。它的核心创新是 Training-time test——在训练时就模拟测试时的链式自举过程,解决了自回归草稿的链式误差问题。但它也揭示了一个深刻的教训:“特征预测”这个看似巧妙的设计,实际上是阻碍 scaling 的紧箍咒。
参考资料
-
DFlash 论文:DFlash: Block Diffusion for Flash Speculative Decoding(arXiv:2602.06036,ICML 2026)
-
DFlash 项目主页:https://z-lab.ai/projects/dflash/
-
DFlash 代码仓库:https://github.com/z-lab/dflash
-
DFlash 2 博客:https://inco.ai/blog/dflash2/
-
DSpark 论文:arXiv:2607.05147
-
EAGLE-3 论文:arXiv:2503.01840
