一、为什么把 EAGLE-3 放在系列最后
EAGLE-3(arXiv:2503.01840)发表于 2025 年 3 月,是本系列时间线上最老的一篇。但把它放在最后,不是因为它的技术最简单,而是因为它揭示了一个深刻的结构性问题——这个问题不仅影响了 EAGLE 自身的发展,也间接推动了 DFlash 和 DSpark 的诞生。
这个问题是:推理加速的草稿模型,能不能像大语言模型那样,从更多的训练数据中持续获益?
大模型社区有一个牢不可破的共识:增加训练数据可以提升模型能力,而不增加推理成本。LLaMA 系列从 1T(LLaMA 1)→ 2T(LLaMA 2)→ 15T(LLaMA 3)token 的训练数据,模型架构不变,但效果持续提升——这就是著名的 Scaling Law。
EAGLE 团队的实验却显示:增加草稿模型的训练数据,加速比的提升非常有限。EAGLE-1/2 的 scaling law “失灵”了。
EAGLE-3 的整篇论文,就是围绕解开这个谜团展开的。
二、EAGLE 系列的三代演进
为了理解 EAGLE-3 的突破性,先快速回顾三代的演进。
2.1 EAGLE-1:特征级自回归
EAGLE-1 的核心洞察:大语言模型倒数第二层的隐藏特征比离散 token 更有规律、更容易预测。
传统推理加速方法(如 Medusa、Lookahead)让小模型在 token 层面做预测——猜”下一个词是什么”。EAGLE-1 说:不如让小模型在特征层面做预测——猜”下一个特征是什么”。
具体做法:
-
用目标模型对输入做前向传播,提取倒数第二层的隐藏特征序列
-
草稿模型自回归地预测下一个特征
-
把预测的特征喂进目标模型的 LM Head,得到 token 分布
这样做的好处:
-
特征空间是连续的、高维的,比离散的 token 空间更”光滑”
-
同时把”超前一步的采样 token”也作为输入,消除了采样随机性带来的不确定性
EAGLE-1 在 Vicuna 33B 和 LLaMA2-Chat 70B 上分别达到了 2.7×–3.5× 的加速,优于 Medusa(1.64×)和 Lookahead(1.94×)。
2.2 EAGLE-2:草稿树 + 动态扩展
EAGLE-2 的改进在验证端:
-
置信度近似:草稿模型的输出概率可以近似代表接受率
-
动态草稿树:根据置信度动态扩展/剪枝草稿树,让高置信度路径分叉更多,低置信度路径早点剪掉
EAGLE-2 把加速比推到了约 3–4×,但没有解决 EAGLE-1 的根本问题。
2.3 EAGLE-3:Scaling Law 的解锁
EAGLE-3 的核心问题是:为什么 EAGLE-1/2 无法从更多训练数据中获益?
答案出人意料:“特征预测”这个设计虽然巧妙,但恰恰是阻碍 scaling 的紧箍咒。
三、特征预测为什么是紧箍咒
3.1 EAGLE-1/2 的训练目标
EAGLE-1/2 的草稿模型同时优化两个损失:
L_total = L_feature + L_token-
L_feature:预测下一个特征(feature-level prediction) -
L_token:预测下一个 token(token-level prediction,通过 LM Head)
特征预测的作用是帮助草稿模型获得多步预测能力——因为特征空间是连续的,即使预测有偏差,接回输入链后偏差不会太大,模型可以继续工作。
3.2 为什么特征预测锁住了 Scaling
问题出在 L_feature 上。特征预测是一个额外的约束:它要求草稿模型不仅要学会预测 token,还要学会预测特征。这个约束限制了草稿模型的表达能力。
具体来说:
-
特征空间是目标模型定义的:草稿模型学习的是”目标模型第 N 层的特征”,而不是”对下一个 token 有用的表示”。这意味着草稿模型的内部表示被”对齐”到了目标模型的某一层,而不是自由地去发现对预测最有用的表示。
-
梯度冲突:
L_feature和L_token可能要求草稿模型学到不同的内部表示。当数据量增加时,模型本可以学到更丰富的模式,但两个损失的冲突限制了它能探索的空间。 -
特征不确定性:训练时草稿模型看到的是”真实特征”,但推理时它看到的是”自己预测的特征”。这个分布偏移导致链式误差累积。
论文用实验验证了这一点:当训练数据从 1× 增加到 8×(相对 ShareGPT),EAGLE-2 的加速比几乎不动(3.15× → 3.28×)。Scaling Law 失灵了。
3.3 证据:Scaling Law 对比图
论文中的这张图(来自 EAGLE-3 论文原文)非常直观地展示了问题:
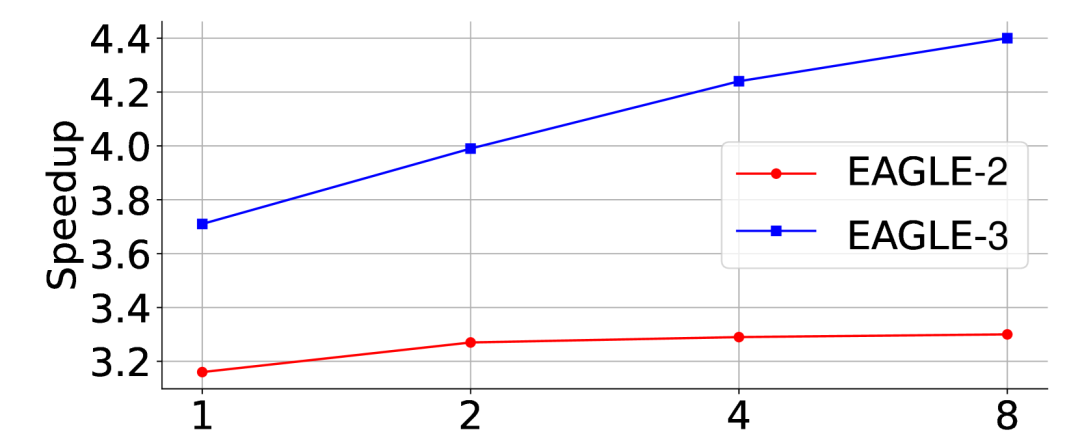
EAGLE-2 vs EAGLE-3 的 Scaling Law(加速比)
-
红线(EAGLE-2):数据翻倍,加速比几乎不变。从 1× 数据的约 3.15× 微涨到 8× 数据的约 3.28×。
-
蓝线(EAGLE-3):从 1× 的约 3.72× 稳步上升到 8× 的约 4.42×,展现出清晰的 scaling 趋势。
再看接受长度的 scaling:
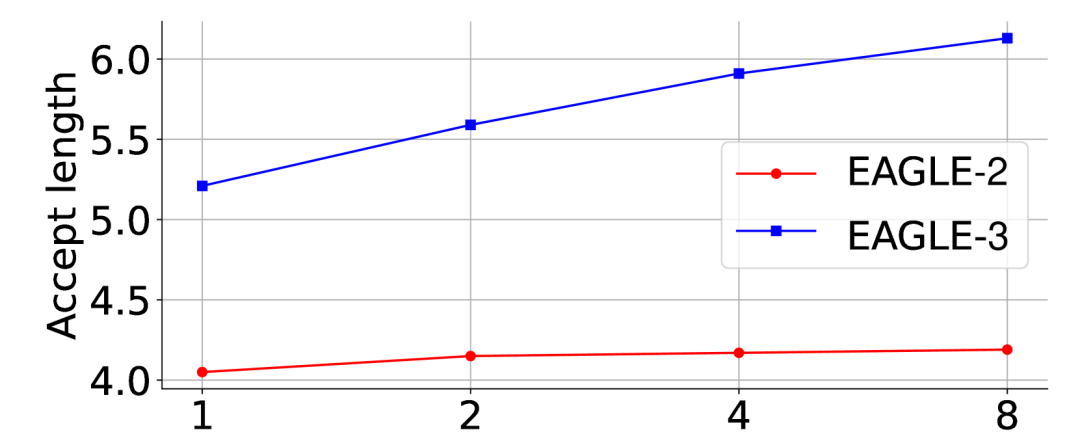
EAGLE-2 vs EAGLE-3 的 Scaling Law(接受长度)
EAGLE-2 的接受长度几乎不随数据增长(4.0 → 4.17),而 EAGLE-3 从 5.22 持续上升到 6.12。
四、EAGLE-3 的三项改进
EAGLE-3 的解法非常干净:去掉特征预测的约束,同时用新的训练策略补上多步预测的能力。
4.1 改进一:放弃特征预测,直接预测 Token
EAGLE-3 不再让草稿模型预测”下一个特征是什么”,而是直接预测”下一个 token 是什么”。
EAGLE-1/2:  L = L_feature + L_token
EAGLE-3:    L = L_token
这样做的好处:
-
损失函数不再受特征预测约束,草稿模型的表达空间更大
-
训练目标与推理目标完全一致——都是 token 预测
-
草稿模型可以自由地发现对 token 预测最有用的内部表示
但这引出一个新问题:没有了特征预测,草稿模型如何获得多步预测能力?
EAGLE-1 中特征预测有一个巧妙的副产品:因为草稿模型在训练时学会了”预测特征”,推理时即使把自己的预测结果接回输入链,它也能继续工作(因为特征空间是连续的,偏差不会太大)。现在直接预测 token,如果训练时只给真实 token 做输入,推理时草稿模型面对自己的预测 token(可能有偏差),分布偏移会很严重。
EAGLE-3 的答案是下一项改进。
4.2 改进二:Training-Time Test(训练时模拟测试时的链式过程)
这是 EAGLE-3 最精妙的设计。论文用一张图清楚展示了三代方法的差异:
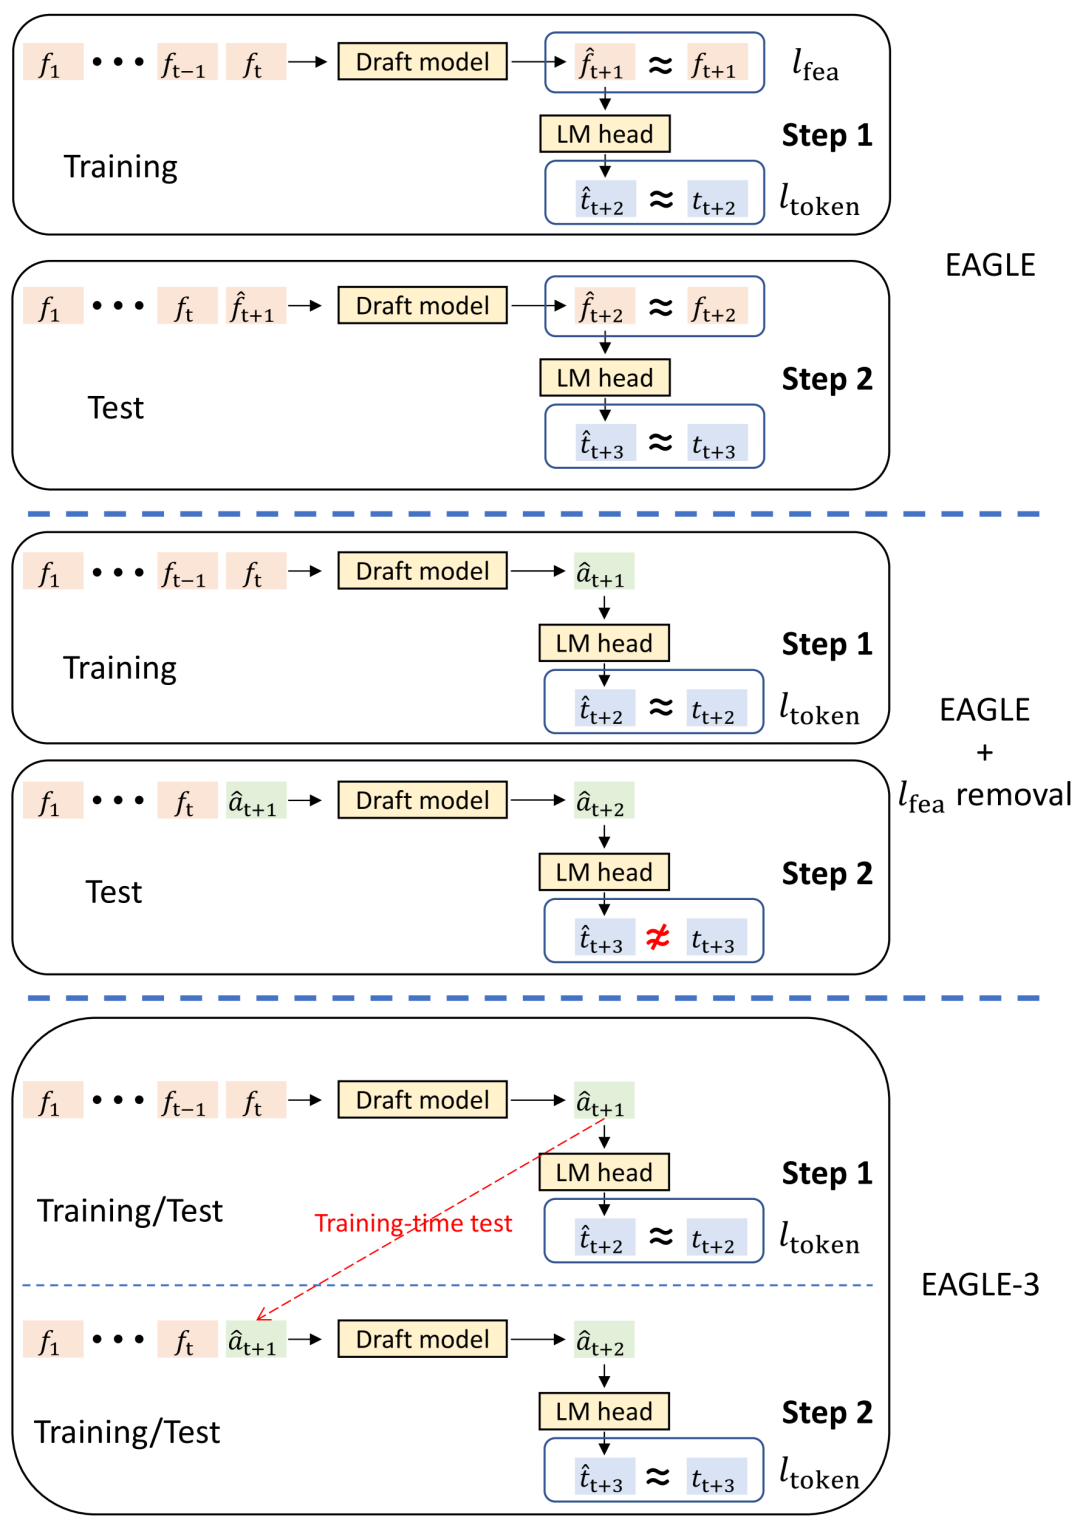
EAGLE 三代架构对比
这张图分为三部分,从上到下分别展示了三种方案在训练和测试时的行为。
上半部分:EAGLE(特征预测)
训练:草稿模型接收真实特征序列,预测下一个特征(l_fea),然后过 LM Head 得到 token(l_token)。
测试:把预测的特征接回输入链,继续预测。
中间部分:EAGLE + l_fea removal(直接去掉特征预测)
训练:草稿模型直接预测 token。输入只有真实特征。
测试:问题来了——训练时输入永远是”真实特征”,但测试时第 2 步的输入是自己预测的特征。分布偏移导致后续预测越来越差(红色叉号表示不匹配)。
下半部分:EAGLE-3(Training-time test)
训练时就在模拟测试时的链式过程:
# 伪代码示意
for step in range(max_draft_length):
    # 第 1 步:用真实上下文预测
    if step == 0:
        input = target_features
    else:
        # 第 2 步及以后:用自己上一步的预测作为输入
        input = draft_model_output_from_prev_step

    logits = draft_model(input)
    predicted_token = sample(logits)
    loss += cross_entropy(logits, true_token)
红色虚线标注了”Training-time test”——训练时主动引入自己的预测作为下一步输入,让草稿模型在训练阶段就学会处理”有偏差的输入”。
这个设计的直觉是:与其让草稿模型在”干净的真实数据”上学习,不如让它在”和自己预测打交道”的环境中学习。 就像学开车不应该只在空旷的驾校练,而要在真实路况中练——EAGLE-3 的训练过程就是”真实路况模拟器”。
4.3 改进三:多层特征融合
EAGLE-1/2 只使用目标模型的顶层特征(倒数第二层)。EAGLE-3 发现这太浪费了——不同层蕴含的信息互补:
-
低层特征:句法、词法信息
-
中层特征:语义、局部上下文
-
高层特征:全局语义、推理信息
EAGLE-3 将低、中、高多层特征拼接后降维,作为草稿模型的输入。这样草稿模型能获取更丰富的上下文信息。
五、实验效果:Scaling Law 被解锁了
5.1 数据 Scaling 效果
下面这张图展示了三种方案随数据增长的接受率:
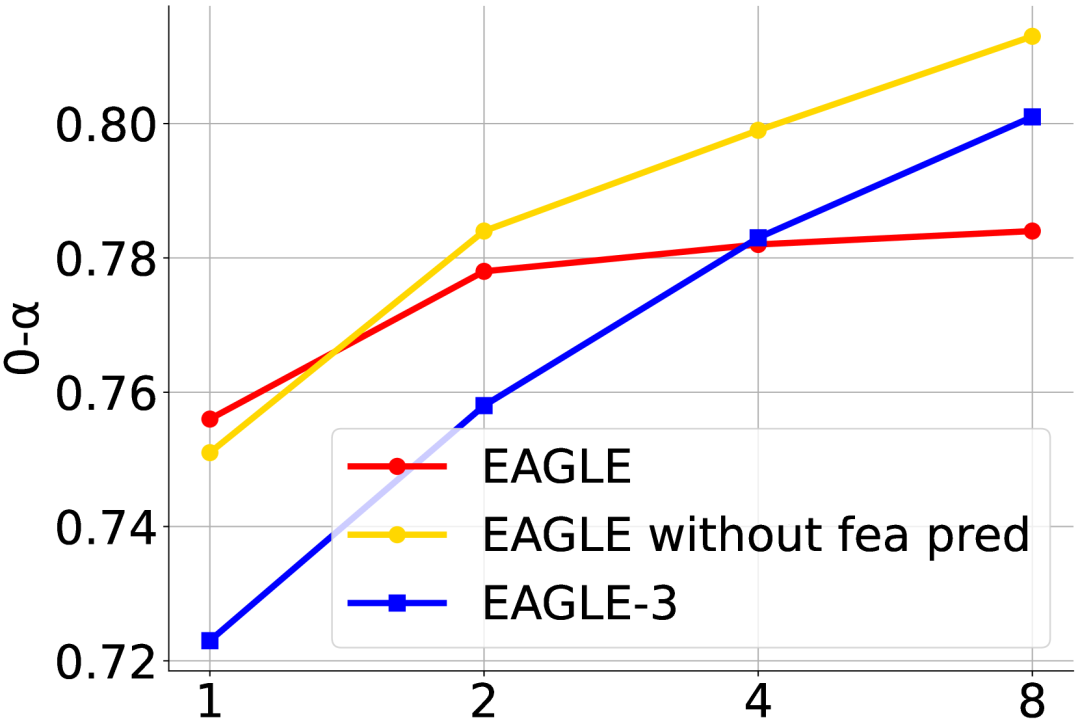
数据 Scaling 对接受率的影响
-
红色(EAGLE):始终使用特征预测,数据增加几乎没收益(0.755 → 0.785,然后平台化)。
-
黄色(EAGLE without fea pred):直接去掉特征预测,初始接受率很低(0.75),但随数据增加上升很快(0.75 → 0.81)。说明直接 token 预测的上限更高,只是需要更多数据。
-
蓝色(EAGLE-3):加上 Training-time test 后,初始接受率更低(0.723)——因为训练时模拟了更难的场景——但数据增加后持续上升(0.723 → 0.758 → 0.783 → 0.801),最终追平甚至超越其他方案。
这个图的含义非常深刻:EAGLE-3 的训练策略虽然让初始学习更难,但解放了模型的表达能力上限,让它能从数据中持续获益。 就像一个学生,虽然入门课程更难,但一旦过了门槛,进步空间反而更大。
5.2 各模型上的加速比
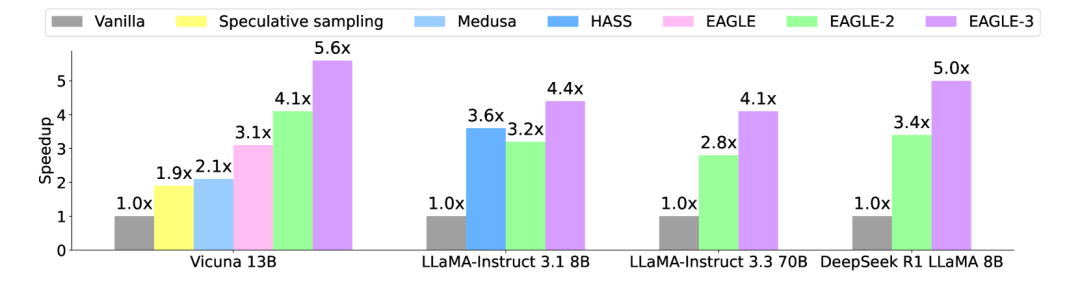
不同方法在各模型上的加速比对比
EAGLE-3(紫色柱)在多个模型上 consistently 领先:
| 模型 | EAGLE-3 加速比 | 对比 EAGLE-2 |
|---|---|---|
| Vicuna 13B | 5.6× | vs 4.1× |
| LLaMA-Instruct 3.1 8B | 4.4× | vs 3.2× |
| LLaMA-Instruct 3.3 70B | 4.1× | vs 2.8× |
| DeepSeek-R1-Distill-LLaMA 8B | 5.0× | vs 3.4× |
最高加速比达到 6.5×。
5.3 为什么是推理模型?
值得注意的是 DeepSeek-R1-Distill-LLaMA 8B 上的 5.0×——这是推理模型(reasoning model),生成的是长思维链。EAGLE-3 在推理模型上的强势表现说明:
-
推理模型的输出是高度结构化的(步骤、推理链、结论)
-
这种结构化输出非常适合自回归草稿预测——因为每一步都有很强的局部规律性
-
Training-time test 在”长链式预测”场景下价值更大,因为链式误差累积在长序列中更严重
六、EAGLE 3.1:修复 Attention Drift
EAGLE-3 虽然 benchmark 成绩亮眼,但在真实生产部署中暴露了一个问题:不同部署条件下的表现差距很大。换一个 chat template、上下文变长、或者 system prompt 和训练数据差异较大时,平均接受长度会显著下降。
2026 年 5 月,EAGLE 团队联合 vLLM 团队、TorchSpec 团队推出了 EAGLE 3.1,核心目的是解决 Attention Drift(注意力漂移) 现象。
6.1 Attention Drift 现象
核心发现:在推理加速过程中,草稿模型的注意力权重会随着投机步数的增加发生系统性偏移。
-
第 1 步生成时,注意力分布正常,关注输入序列中的关键信息(sink token)
-
随着投机步数增加,注意力逐渐从 sink token 转移到刚生成的 token 上
-
经过数个投机步骤后,注意力几乎完全锁死在最近几个 token,对全局上下文关注度衰减
这就像写文章时,写着写着就只盯着刚写的那句话,完全忘了文章开头要表达的核心论点。
6.2 根因分析
EAGLE 3.1 发现两个结构性根因:
-
输入特征失衡:融合的输入表示中,高层隐藏状态逐渐主导了草稿模型的输入
-
数值残差爆炸:残差路径未进行归一化,隐藏状态的模长随投机步数累积增长
公式化表达:在旧版本中,随着投机步数 t 的增加,输入到草稿模型的特征 H_t 满足:
H_t = H_{t-1} + ΔH_t由于缺乏均值和方差约束,‖H_t‖ 的模长在深层投机时发生漂移,导致草稿模型的预测分布与目标大模型严重失配。
6.3 EAGLE 3.1 的修复
引入了两项架构改进:
-
特征归一化:在残差路径中加入 RMSNorm,阻断模长爆炸
-
注意力重平衡:调整 attention 的初始化或缩放,防止注意力过度集中在最近生成的 token 上
EAGLE 3.1 已集成进 vLLM 和 TorchSpec,是 EAGLE 系列向生产环境成熟迈出的重要一步。
七、EAGLE-3 的方法论启示
回顾 EAGLE-3 的三项改进,可以看到一条清晰的设计主线:
-
发现问题:EAGLE-1/2 的特征预测限制了表达能力,导致数据 scaling 失效
-
大胆减法:直接去掉特征预测,让草稿模型回归最直接的目标——token 预测
-
聪明补偿:用 Training-time test 补上多步预测能力,用多层特征融合补全信息来源
-
验证效果:Scaling Law 被解锁,数据越多效果越好
这个思路对工程很有启发:有时候约束本身就是瓶颈。 EAGLE-1 的特征预测看起来是个巧妙的设计(特征比 token 更有规律),但它恰恰是阻碍 scaling 的紧箍咒。EAGLE-3 敢于”做减法”,反而打开了新的上限。
另一个启发是 Training-time test 这个技巧的本质——让训练分布与测试分布对齐。这在很多序列生成任务中都有借鉴价值:如果模型在推理时要面对自己生成的输出,那训练时就该让它习惯这种”自我对话”的场景。
八、全系列回顾
到此为止,五篇系列文章(含导论)全部完成。先看一张总图,理清四条路线的关系:
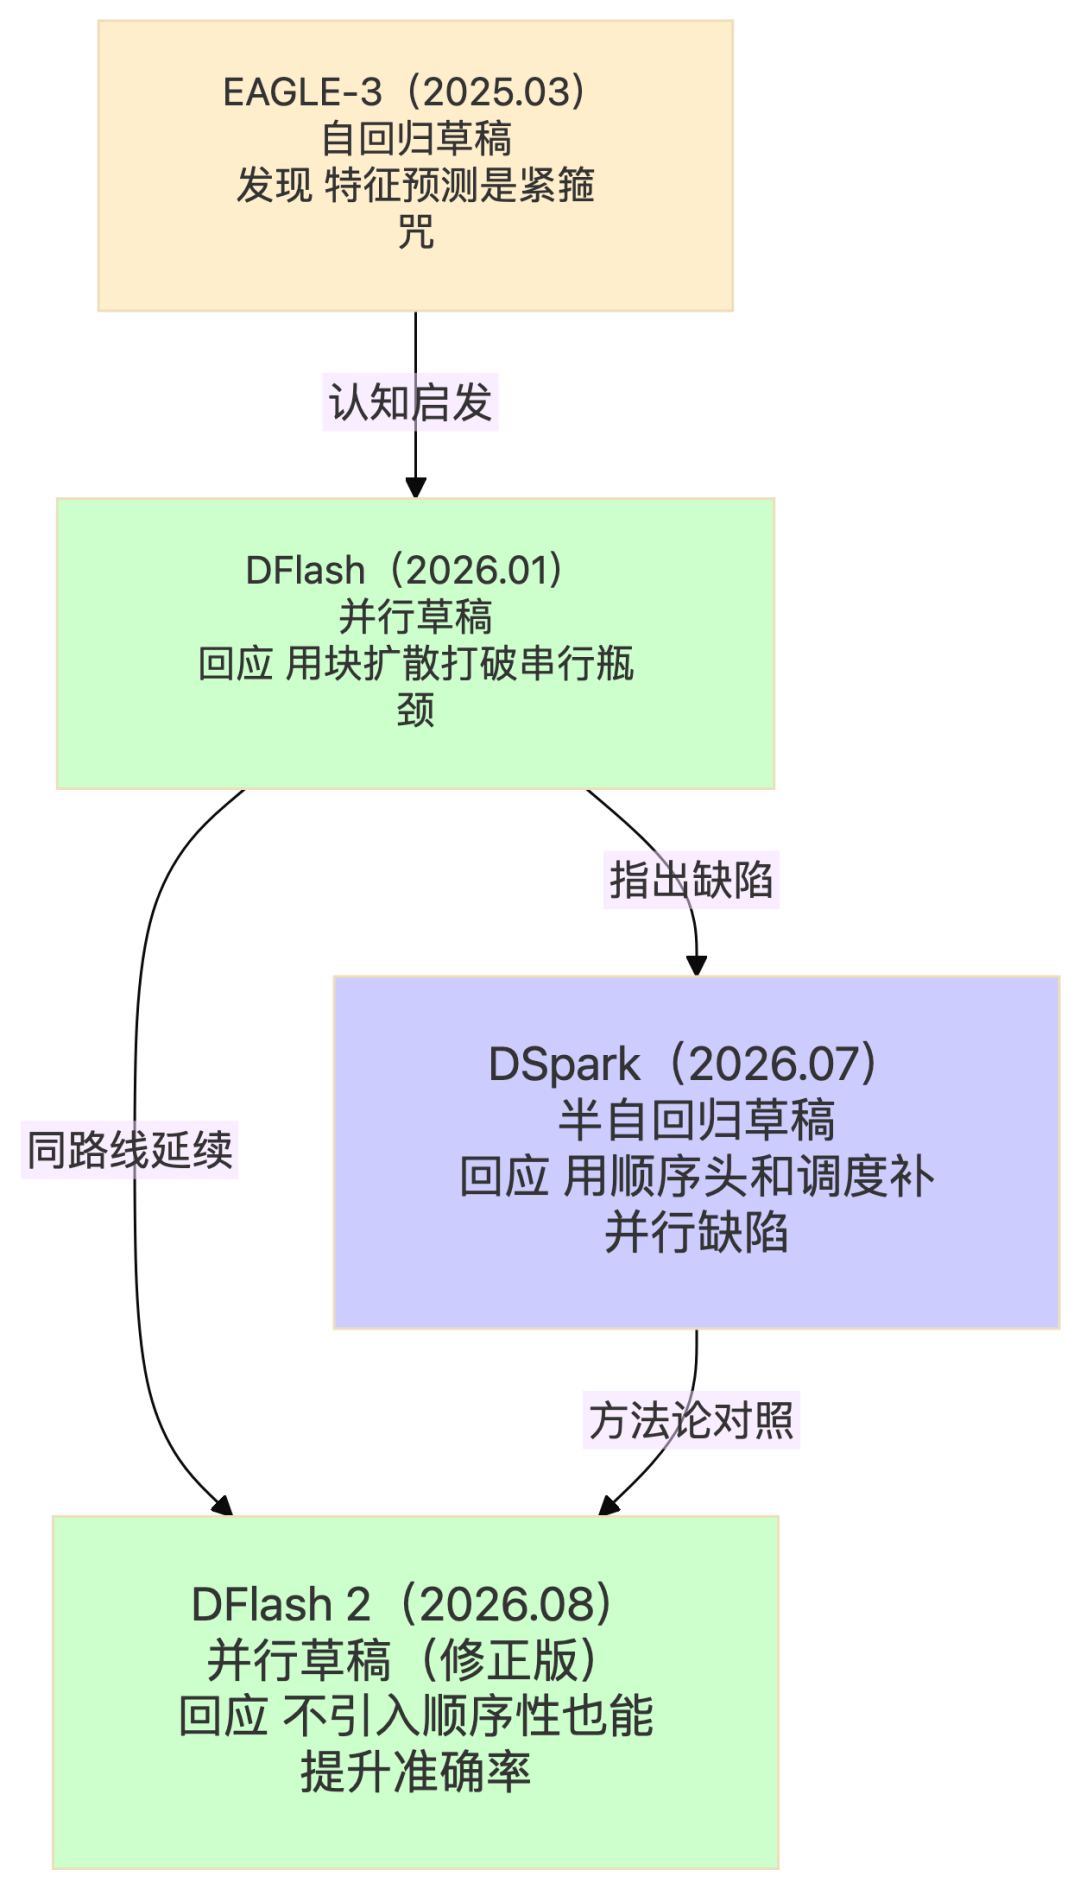
需要注意的是:虚线表示的是”认知上的启发与回应”,不是”版本升级”。 四条路线今天是并列存在的——EAGLE-3 仍是 vLLM/SGLang 的标配,DFlash 系列和 DSpark 都在快速扩展,没有谁取代谁。它们分别从不同角度回答了”草稿怎么生成更快更准”这个问题。
每一代都在回答前一代留下的问题:
-
EAGLE-3 问:自回归草稿的 scaling 瓶颈在哪里? 答:特征预测是紧箍咒。
-
DFlash 问:能不能不用自回归? 答:可以,用块扩散 + KV 注入。
-
DSpark 问:并行草稿的结构性缺陷怎么补? 答:引入顺序性 + 验证端动态调度。
-
DFlash 2 问:能不能不引入顺序性也能提升准确率? 答:可以,选对路 + 补后劲。
四条路线今天仍在并行发展,尚未分出胜负。对于开发者来说,关键是理解每条路线的设计哲学和适用场景:
-
EAGLE-3/3.1:生态最成熟(vLLM/SGLang 原生支持),适合需要稳定生产部署的场景
-
DFlash/DFlash 2:并行效率天花板更高,适合延迟敏感、结构化输出的场景
-
DSpark:系统级优化能力最强,适合高并发、吞吐优先的服务场景
系列完整索引
-
EAGLE-3:从特征预测到 Token 预测,解锁 Scaling Law(本文) ← 当前
参考资料
-
EAGLE-3 论文:EAGLE-3: Scaling up Inference Acceleration of Large Language Models via Training-Time Test(arXiv:2503.01840)
-
EAGLE-3.1 论文:Attention Drift: What Autoregressive Speculative Decoding Models Learn
-
EAGLE 代码仓库:https://github.com/SafeAILab/EAGLE
-
SGLang EAGLE-3 PR:https://github.com/sgl-project/sglang/pull/4247
-
vLLM EAGLE-3.1 集成博客:https://vllm.ai/blog/2026-05-26-eagle-3-1
-
DFlash 论文:arXiv:2602.06036
-
DSpark 论文:arXiv:2607.05147
-
NVIDIA EAGLE-3 部署指南:https://developer.nvidia.com/blog/an-introduction-to-speculative-decoding-for-reducing-latency-in-ai-inference/
