大模型推理加速进化论(一):DFlash 2——当选择器遇上动态卷积,并行草稿的精准进化
自我介绍
大家好,我是Aaron。过去一直从事算法领域相关工作,自工作以来,一直持续在关注算法相关技术的发展,当前除了在工作中会进行一些AI的落地实践,工作之余也在通过AI辅助编程做一些有趣的探索。我会持续更新AI实践过程中的心得体会,以及AI知识分享。欢迎大家关注我关注公众号,以便第一时间收到更新推送。
「大模型推理加速进化论」系列 是一套面向有编程经验开发者的大模型推理加速技术解读。我们从最新的 DFlash 2 出发,按时间倒序回溯推理加速这条技术线的关键节点,试图回答一个问题:为了让大模型”说得快还不说错”,过去一年半里,研究者们做了哪些极致的优化?
本系列共五篇(含一篇导论):DFlash 2 → DSpark → DFlash → EAGLE-3。 不了解推理加速基础概念的读者建议先读[第零篇导论]。
一、为什么从 DFlash 2 开始
2026 年 8 月,Inco AI 发布了 DFlash 2,博客标题叫 Keep Drafting Parallel。
这句话背后是一个重要的技术立场:上一代的 DFlash(2026 年 1 月)已经证明了”并行草稿”这条路走得通——用一个块扩散模型一次性并行生成整块 token,在 Qwen3-8B 上做到了最高 6× 无损加速,比当时的 EAGLE-3 快约 2.5 倍。但走得通不等于走得稳。并行生成有个根本性的张力:速度快了,但块内 token 之间的依赖建模变弱了,导致选不对和块尾衰减两个问题。
DFlash 2 不打算放弃并行路线——它要证明的是:并行草稿的准确率天花板还没摸到,通过更聪明的候选选择和局部依赖建模,可以在不引入串行成本的前提下,把接受长度再推高 16–25%。
这一篇我们先深入理解这两个”招式”的设计动机、实现细节和工程权衡,然后把它放到整个推理加速的技术地图中,看看它与前一代 DFlash 和后辈 DSpark 的关系。
二、DFlash 1 留下的两个”结构性缺陷”
在谈 DFlash 2 之前,必须先理解 DFlash 1 的”天花板”在哪里。这不是简单的”准确率不够高”,而是并行框架先天带有的两个问题。
2.1 缺陷一:独立采样导致的多模态碰撞
DFlash 1 的草稿模型对块内每个位置独立地输出 logits,然后取每个位置的 top-1。问题是:这些位置之间没有任何交互。位置 A 选了”非常”,位置 B 也完全可能选”非常”,因为 B 不知道 A 选了什么。
从信息论的角度看,这相当于每个位置做了一个边缘分布的决策,而不是联合分布的决策。联合分布考虑的是”给定前面选了 X,后面选 Y 的概率”,而边缘分布只考虑”这个位置选 Y 的概率”,忽略了条件依赖。
论文给了一个关键数据:第一个位置的 top-1 命中率是 85.4%,但正确 token 落在 top-16 候选里的概率高达 99.5%。这意味着:
-
正确答案几乎总是在候选池里
-
问题在于我们没有利用”位置之间的条件依赖”来从候选池里挑出最连贯的组合
-
如果能有一个”先知”从 top-16 里挑出正确组合,接受长度能从 4.27 涨到 6.79——提升空间高达 59%
这个 59% 就是 DFlash 2 路径选择器瞄准的上限。
2.2 缺陷二:块内位置越远越不准
块扩散是并行的,块内所有位置同时去噪。对于第 i 个位置(i > 1),它能看到的信息只有:
-
已验证的上下文(通过目标模型的 KV 注入)
-
它自己在并行去噪时看到的块内其他位置的噪声输入(不是最终输出)
也就是说,第 5 个位置无法看到第 1–4 个位置最终选了什么词。它只能看到那些位置的噪声/掩码状态。这和自回归草稿(如 EAGLE-3)形成鲜明对比——在自回归中,第 5 个位置明确知道前 4 个位置选的是”The capital of France is Paris”,因此能基于这个精确的前缀做预测。
结果是:越往块后面,预测准确率掉得越厉害。论文的逐位置分析显示,DFlash 在位置 1 的接受率约 89%,到位置 7 已经跌到约 82%。
这个衰减不是训练不足造成的——它是并行框架的结构性限制。要缓解它,必须在不引入串行 attention 的前提下,给靠后的位置补充”局部上下文”信息。
先看 DFlash 2 的整体架构,再分别拆解两个招式:
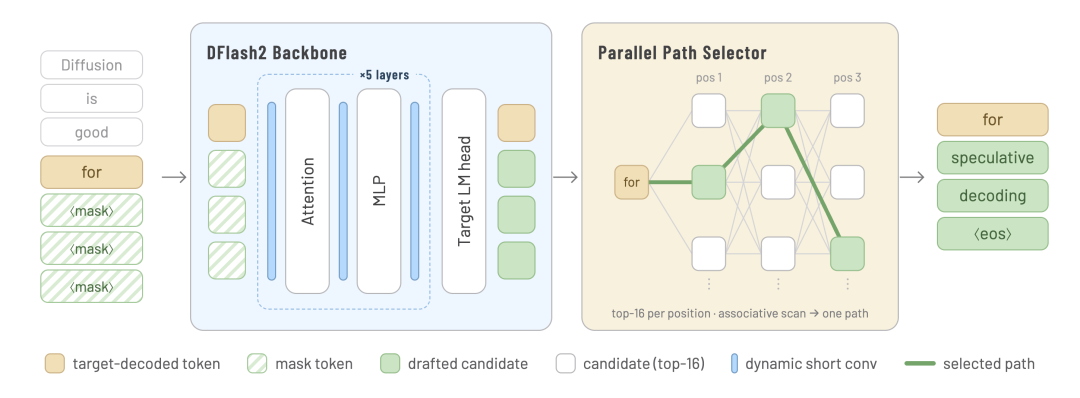
DFlash 2 架构图:左侧为 Backbone(5 层 Transformer + 动态短卷积),右侧为 Parallel Path Selector(每位置 top-16 候选 + associative scan 选连贯路径)
图的左侧是 DFlash2 Backbone——5 层 Transformer,每层 Attention 和 MLP 之间插入轻量动态短卷积(蓝色竖条),即”双抽头动态卷积”。图的右侧是 Parallel Path Selector——每个位置保留 top-16 候选(白色方框),通过 associative scan 从所有候选组合中找出最连贯的一条路径(绿色粗线)。这两部分分别对应下文要讲的两个招式。
三、招式一:路径选择器(Path Selector)
路径选择器解决的是”选不对”的问题。它的核心洞察可以一句话概括:正确答案就在候选池里,问题是怎么挑。
3.1 为什么不重写分布?
在谈路径选择器之前,先看看别的方案是怎么做的。
Domino 和 DSpark 的做法是引入一个串行输出头(autoregressive head),基于前面位置的最终输出,逐个重写每个位置的全词表分布。这样做确实能建模依赖关系,但代价是:
-
每个位置都要做一次前向传播(串行)
-
引入了额外的延迟,可能抵消并行带来的速度优势
-
草稿模型从”并行”退回到了”半自回归”
DFlash 2 的思路不同:不修改底层分布,只在已有的 top-k 候选中做选择。这样做有几个好处:
-
不改变并行框架:草稿 Backbone 仍然是一次前向传播并行产出所有候选
-
计算量极小:只在 top-k 候选上操作(k=16),而不是在全词表上操作(词表大小通常是 50k–150k)
-
输出可证不变:因为选择器只是从候选中挑一个,不改变每个候选的概率值,所以最终输出分布和原始 DFlash 完全一致——论文称之为”provably unchanged”
3.2 选择器的具体机制
路径选择器维护两组 embedding codebook:
-
Predecessor Codebook:
P ∈ R^(V × r),其中 V 是词表大小,r 是低维秩(rank) -
Successor Codebook:
S ∈ R^(V × r)
对于每个位置 j 的 top-k 候选 {c_j1, c_j2, ..., c_jk},选择器计算一个连贯性得分:
score(c_ji) = logit(c_ji) + (P[prev_token] ⊙ h_j) · S[c_ji]其中:
-
logit(c_ji)是草稿模型输出的原始 logits(unary score,衡量候选本身的质量) -
P[prev_token]是前一个已选词的 predecessor 向量 -
h_j是当前位置的 hidden state 投影到低维空间 -
S[c_ji]是当前候选词的 successor 向量 -
⊙表示逐元素乘法,·表示点积
这个公式的直觉是:一个候选词的总得分 = 它自己有多好 + 它和前一个词的连贯性有多好。
3.3 为什么是贪心路径而非全局最优?
选择器用的是贪心路径选择:从锚点 token 开始,每步选得分最高的候选,然后把选中的词作为下一位置的 predecessor。这不是全局最优(全局最优需要枚举所有 k^N 条路径),但:
-
计算复杂度是 O(N × k),完全可以忽略
-
实验表明贪心路径已经能捕捉到绝大部分的连贯性收益
-
更重要的是,贪心路径和后面的拒绝采样天然兼容——推理加速本身就是贪心的(从第一个拒绝处截断),所以路径选择器的贪心策略不会引入额外的分布偏差
3.4 一个代码层面的细节
在 DFlash 的代码仓库(z-lab/dflash)中,CandidateSelector.select 的实现(model.py:524)用 torch.einsum("br,bkr->bk", ...) 高效地计算 batch × rank 和 batch × k × rank 的相似度。这个实现技巧值得注意:
scores = unary[:, position] + torch.einsum(
    "br,bkr->bk",
    self.predecessor_codebook(predecessor) * hidden[:, position],
    self.successor_codebook(candidates[:, position]),
)
这里 hidden[:, position] 经过 self.hidden_projection 投影到低维空间,和 predecessor 向量做逐元素乘法后再和 successor 向量做 batch 矩阵乘法。整个操作在 GPU 上是非常高效的。
四、招式二:双抽头动态卷积(Dual-tap Dynamic Convolution)
双抽头动态卷积解决的是”块尾衰减”的问题。它的设计哲学是:在不引入串行 attention 的前提下,通过局部卷积补充位置间的依赖关系。
4.1 为什么用卷积而不是 attention?
有人可能会问:既然问题是”位置之间看不见彼此”,那直接让块内位置做 causal attention 不就行了?
问题在于:causal attention 在块内仍然是串行的——第 5 个位置要看到第 4 个位置的最终输出,必须等第 4 个位置算完。这就破坏了并行性。
卷积的优势在于:所有位置可以同时对局部邻域做操作,不引入跨位置的依赖链。具体来说,一个位置 i 的卷积结果只依赖于位置 i, i-1, i-2, …(局部窗口),而这些输入值在并行骨架的前向传播中已经同时算出来了。
4.2 “双抽头”的设计细节
DFlash 2 的卷积不是普通的 1D 卷积,而是分两个阶段作用于每层的 hidden states:
第一阶段(prepare tap):在 attention 计算之前
# model.py 中的 prepare() 方法
def prepare(self, hidden):
    dynamic = self.kernel_projection(hidden)  # 从 hidden 生成动态卷积核
    # 用 base_kernel[0] + dynamic 做第一次卷积
    return convolved_hidden, dynamic_for_finish
第二阶段(finish tap):在 attention 计算之后
# model.py 中的 finish() 方法
def finish(self, hidden, dynamic):
    # 用 base_kernel[1] + dynamic 做第二次卷积
    return convolved_hidden
两个阶段的 base kernel 不同(base_kernel[0] 和 base_kernel[1]),但共享同一个动态调制分量。动态调制分量是通过一个轻量的线性投影 self.kernel_projection(hidden) 从当前 hidden states 生成的,这意味着每个 token 位置有自己定制的卷积核。
4.3 分组(Grouped)和因果(Causal)
卷积是分组的(grouped convolution):把 hidden_size 拆成若干 group,每组独立做卷积。这减少了参数量,也让计算更稀疏。
卷积是因果的(causal):每个位置只能看到前面的位置,看不到后面的位置。这保证了解码时不会泄露未来信息。
代码实现中(model.py:478 的 _grouped_dynamic_convolve),因果性通过 F.pad(blocks[:, :-offset], ...) 实现:对于偏移量 offset,取前面 length - offset 个位置,后面 pad offset 个零。这样位置 i 只能看到 i-offset 及之前的位置。
4.4 工程权衡分析
双抽头动态卷积的工程设计体现了几个精妙的权衡:
-
轻量 vs 有效:参数量极小(一个 hidden_size → 2×kernel_size×groups 的线性投影 + 两个 base kernel),但实验表明它能有效缓解块尾衰减。
-
局部 vs 全局:卷积只关注局部邻域(kernel_size 通常是 3 或 5),不试图建模长程依赖——长程依赖由 attention 和目标模型 KV 注入负责,卷积只补”前后看一眼”的短板。
-
动态 vs 静态:动态调制让卷积能适应不同输入的局部模式,但又不是完全动态(保留了静态的 base kernel),这在表达能力和计算效率之间找到了平衡。
论文说整个双抽头卷积只增加约 1% 的周期延迟——对于 16–25% 的额外产出来说,这个投资回报率极高。
五、两代对比:DFlash 1 vs DFlash 2
| 维度 | DFlash 1 | DFlash 2 |
|---|---|---|
| 核心问题 | 并行草稿快但不够准 | 在并行框架内提升准确率 |
| 草稿生成 | 块扩散,独立 top-1 采样 | 块扩散 + 路径选择器(top-k 中选连贯路径) |
| 依赖建模 | 仅通过目标模型 KV 注入 | KV 注入 + 双抽头动态卷积(局部依赖) |
| 输出分布 | 和 DFlash 一致 | 可证不变(provably unchanged) |
| 额外延迟 | 几乎为零 | 约 +1% 周期延迟 |
| 典型接受长度 | 4.27 | 4.80(+12%) |
| 草稿深度 | 5 层 Transformer | 同,每层加两个卷积模块 |
一个值得深入思考的观察:DFlash 2 的两项改进本质上是正交的——路径选择器解决的是”候选之间的联合选择”问题(宏观层面),动态卷积解决的是”位置之间的局部依赖”问题(微观层面)。两者分别针对两个不同的”漏”,互不干扰,可以叠加使用。这种”分而治之”的设计思路体现了很好的工程品味。
六、DFlash 2 在推理加速技术版图中的位置
四条技术路线是并列关系,而非线性演进。它们围绕”草稿怎么生成”给出了不同答案:
自回归草稿 ─────→ EAGLE-3(1层,逐词猜,准但深度受限)

并行草稿 ────────→ DFlash(5层,整块出,快但块内无依赖)
                       │
                       └─→ DFlash 2(并行 + 路径选择器 + 动态卷积,在并行框架内修正)

半自回归草稿 ────→ DSpark(并行骨架 + 顺序头 + 置信度调度,融合两者 + 系统级优化)
DFlash 2 的独特定位是:它坚定地走在并行路线上,用”并行框架内的轻量修正”来提升准确率,而不是引入顺序性。
这和 DSpark 形成了方法论上的分野:
-
DFlash 2 的哲学:并行是核心优势,不要动它。在并行产出的基础上做后处理(选择、卷积),代价极小。
-
DSpark 的哲学:并行框架的结构性缺陷(位置之间无依赖)光靠后处理补不够,必须引入顺序模块来从根本上建模依赖。
哪个更好?取决于场景:
-
在 Apple Silicon(MLX)上,mlx-dspark 的实测显示 DFlash 2 在 Qwen3.8-27B 上的加速比(4.06×)高于 DSpark 社区 drafter(2.92×)。这暗示在量化场景和消费级硬件上,DFlash 2 的”纯并行+轻量修正”可能更有优势。
-
在 DeepSeek-V4 的大规模 MoE 线上服务中,DSpark 的半自回归+置信度调度展示了更强的系统级优化能力(吞吐提升 51–661%)。
两种路线各有胜负,但 DFlash 2 的价值在于:它证明了并行路线的天花板还没有摸到——在引入顺序性之前,还有很多”轻量修正”的空间可以利用。
七、系列导读
DFlash 2 用”选对路 + 补后劲”两招,在保持并行框架的前提下把接受长度推高了 16–25%。但它不是这条技术线的终点——在它之前,DSpark 走了另一条路,直接给草稿模型引入了顺序性。
下一篇:DSpark:半自回归 + 置信度调度,把推理加速推上生产线
DSpark 不满足于”在并行框架内做修正”,它用并行骨架 + 轻量顺序头(Markov/RNN)让草稿从”纯并行”变成”半自回归”;同时在验证端引入 Confidence Head 和硬件感知调度器,根据存活概率动态决定验证多长。它是 DeepSeek 团队的官方工作,已部署在 DeepSeek-V4 的真实线上流量中——也是第一个在生产级服务中大规模验证推理加速效果的工作。
再往后:
-
DFlash:用扩散模型给大模型推理”开涡轮增压” —— 理解 DFlash 2 的前身,块扩散 + KV 注入如何让并行草稿第一次成为可能
-
EAGLE-3:从特征预测到 Token 预测,解锁 Scaling Law —— 自回归草稿的极致形态,以及它如何被”特征预测”这个紧箍咒锁住了 scaling 能力
参考资料
-
DFlash 2 博客:https://inco.ai/blog/dflash2/
-
DFlash 项目主页:https://z-lab.ai/projects/dflash/
-
DFlash 论文:DFlash: Block Diffusion for Flash Speculative Decoding(arXiv:2602.06036,ICML 2026)
-
DFlash 代码仓库:https://github.com/z-lab/dflash
-
DSpark 论文:arXiv:2607.05147
-
EAGLE-3 论文:arXiv:2503.01840
