一、ChatGPT 为什么”一个字一个字”地往外蹦
用过 ChatGPT 或 Claude 的人都知道,模型的回复是逐字出现的——不是网速慢,而是模型内部就得这么算。
大语言模型(LLM)的生成方式叫自回归解码(Autoregressive Decoding)。它的逻辑很简单:每生成一个词(token),都要把这个词接回输入,然后重新算一遍整个模型,才能确定下一个词。
第1步:输入 "今天天气" → 模型算一遍 → 输出 "很"
第2步:输入 "今天天气很" → 模型算一遍 → 输出 "好"
第3步:输入 "今天天气很好" → 模型算一遍 → 输出 "。"
这就好比你在写文章,每写一个字都要把整本词典从头翻一遍才能确定下一个字。哪怕你已经写了几千字,下一个字还是要重新翻一遍词典。
用流程图来理解自回归解码:

红色框表示”搬完整个 70B 模型”——每生成一个 token 都要搬一次。
1.1 慢的根源不是算力不够,而是”等数据”
这里有一个反直觉的事实:GPU 算矩阵乘法的速度极快,现代 GPU 的算力通常是 100+ TFLOPS(每秒做 100 万亿次浮点运算)。但 LLM 推理时,GPU 的利用率通常 不足 30% 。
为什么?因为瓶颈在显存带宽。
-
模型有几百亿个参数,存放在 GPU 显存中
-
每生成一个 token,都要把所有参数从显存搬到计算核心
-
显存带宽通常是 1–2 TB/s,远远跟不上计算核心的速度
结果是:GPU 大部分时间不是在”算”,而是在”等数据从显存搬过来”。这种场景叫做 memory-bound(内存带宽受限)。
1.2 能不能一次多算几个
一个自然的想法:既然 GPU 算矩阵乘法那么快,能不能让它一次算多个 token?
答案是:不能,因为每个 token 的输入依赖于前一个 token 的输出。 “好”字的输入必须包含”很”字,所以必须等”很”算完才能开始算”好”。这是自回归的串行本质,无法打破。
除非——我们换种方式。
二、草稿生成+并行验证:一个巧妙的”作弊”方法
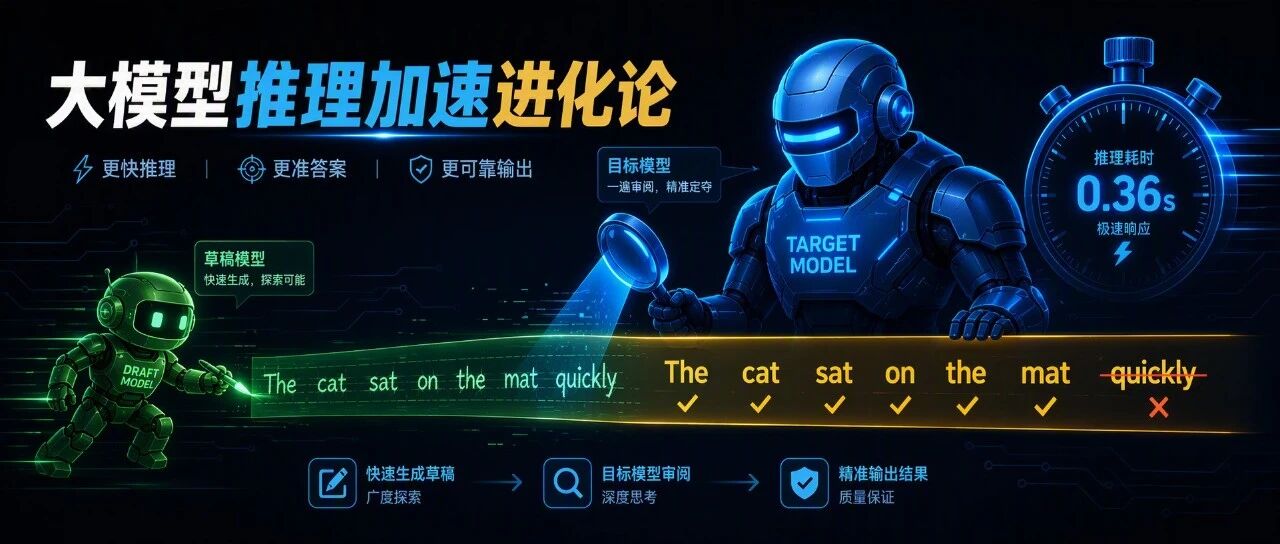
草稿生成+并行验证(Speculative Decoding,也叫投机解码或推测解码)是目前最有效的”无损”推理加速技术。它的核心思想可以用一个比喻来理解:
你写论文时,先让一个”实习生”快速写出一版草稿,然后导师一次性批改整段草稿。如果实习生写得准,导师一次批改就能确认好几个段落;如果写得不准,从第一个错误处开始重写。
对应到 LLM 推理中:
-
导师 = 目标大模型(Target Model),比如 70B 参数的 LLaMA
-
实习生 = 草稿模型(Draft Model),一个又小又快的模型
-
草稿 = 实习生猜测的接下来一串 token(比如 8 个)
-
批改 = 目标模型一次性并行验证这 8 个 token
2.1 为什么这样能加速
很多人会疑惑:实习生和导师都要跑,相当于跑了两个模型,怎么会更快?关键在于两点:导师只跑一次,以及带宽瓶颈下小模型的代价远低于大模型。
先说”导师只跑一次”。目标模型验证 k 个 token 和验证 1 个 token,带宽成本几乎一样——因为瓶颈是把几百亿参数从显存搬到计算核心,这个搬运只发生一次;而 Transformer 的 attention 天然支持并行,验证 k 个 token 只是序列变长一点,计算量大致按平方增长,对 k=8–16 这种小序列来说增加微乎其微。
再说带宽成本不对等。大模型慢,是因为参数多、搬运贵;实习生小(通常是大模型的 1/20),搬运便宜得多。于是总成本变成:
“小模型跑 k 次 + 大模型跑 1 次” vs 原本”大模型跑 k 次”
用具体数字感受一下(假设大模型搬一次参数=100 单位、小模型=5 单位、草稿长 k=8、接受 τ=4 个):
-
不用加速(产 4 个 token):大模型跑 4 次 = 400 单位
-
用加速(产 4 个 token):小模型跑 8 次(40)+ 大模型跑 1 次(100)= 140 单位
140 vs 400,快约 2.85 倍。省下的本质是:大模型从”跑 4 次”变成”跑 1 次”,节省的 3 次大模型带宽成本,远超小模型多跑 8 次的开销。下面这张图把两种成本结构放在一起对比:
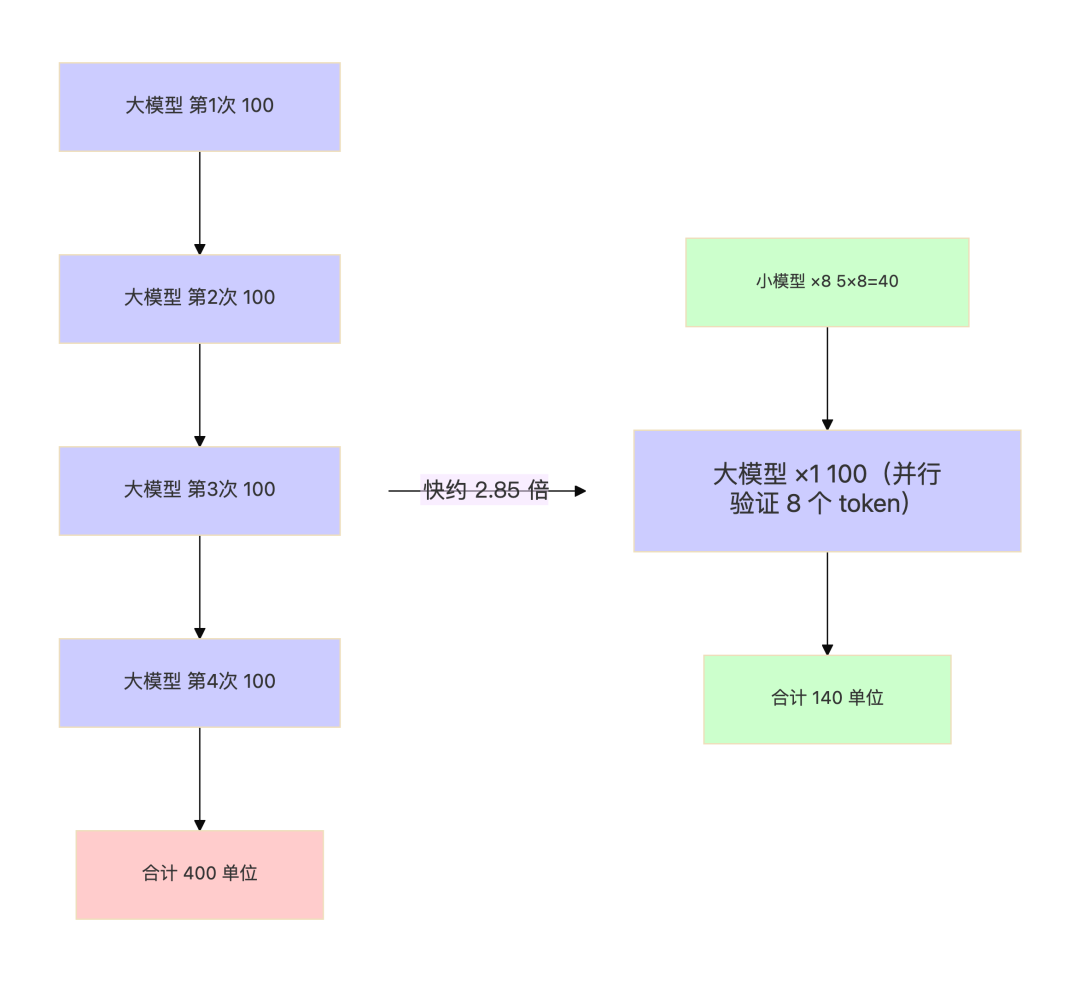
左图:不用加速,每生成一个 token 都要搬一次大模型(蓝色),4 个 token = 4 次大模型搬运 = 400 单位。
右图:用加速,小模型(绿色,便宜)连跑 8 次生成草稿共花 40 单位,大模型(蓝色,贵)只跑 1 次并行验证 8 个 token 花 100 单位,合计 140 单位。
关键差别一目了然:蓝色大块从 4 个减到 1 个——这才是加速的真正来源。小模型多跑的次数看起来多(8 次),但因为每次只花 5 单位,总额远小于省下的大模型搬运成本。
这也说明了一个关键:加速效果取决于接受长度 τ。 τ 太小(比如基本没接受),“小模型 8 次 + 大模型 1 次”反而比”大模型 4 次”贵,会变慢。所以本系列所有方法(EAGLE-3、DFlash、DSpark)的核心目标都是同一个:把 τ 推高——让实习生猜得更准,让导师一次确认更多 token。

绿色 = 小模型(快,多跑几次也便宜),蓝色 = 大模型(慢,但每轮只跑 1 次——这就是加速的来源)。
2.2 为什么不会说错:拒绝采样
先明确一点:拒绝采样是推理时验证草稿用的,和训练草稿模型无关。 草稿模型是用普通的监督学习(交叉熵)训练出来的;拒绝采样只发生在上线后”导师批改实习生草稿”这一步。
关键问题:如果实习生猜错了怎么办?会不会导致输出质量下降?
答案是:不会。 验证阶段采用了一种叫拒绝采样(Rejection Sampling)的机制,它有一个数学保证:
最终输出的 token 分布,和目标模型自己逐字生成的分布完全一致。
具体流程是:
-
目标模型并行计算 8 个 token 的 logits,得到每个位置的概率分布 p
-
对于每个位置,把草稿采的 token x 和两个分布(草稿分布 q、目标分布 p)一起看
-
按
min(1, p(x)/q(x))的概率接受 x——草稿和目标越接近越容易被接受 -
如果某个位置被拒绝了,就从修正分布
norm(max(0, p − q))重新采样一个 token,并停止验证后续位置 -
下一轮从被重新采样的位置开始继续
这意味着:被接受的 token 都经过了目标模型的确认,被重新采样的 token 也是为了严格对齐目标分布而采的。 这两步合起来保证了最终输出和目标模型自己写逐字一致——这就是”无损”的含义。
2.3 拒绝采样的极简代码
核心逻辑就是”接受-拒绝”两步。假设目标模型输出了 target_probs(每个位置的概率分布 p),草稿模型输出了 draft_probs(每个位置的概率分布 q)和 draft_tokens(草稿猜的 token):
def verify_draft(target_probs, draft_probs, draft_tokens, temperature=0):
    """
    target_probs: [seq_len, vocab_size]  目标模型分布 p
    draft_probs:  [seq_len, vocab_size]  草稿模型分布 q
    draft_tokens: [seq_len]              草稿采样的 token
    """
    accepted = []
    for i in range(len(draft_tokens)):
        x = draft_tokens[i]
        p, q = target_probs[i], draft_probs[i]

        if temperature == 0:  # 贪心解码
            # 贪心只有一个候选:目标分布的 argmax
            best = p.argmax()
            if x == best:
                accepted.append(x)          # 草稿命中,接受
            else:
                accepted.append(int(best))  # 未命中:用目标的最优替代,并截断
                break
        else:  # 随机采样(温度 > 0)
            # 接受概率 = min(1, p(x)/q(x)),即草稿越接近目标越可能被接受
            if random.random() < min(1.0, p[x] / q[x]):
                accepted.append(x)
            else:
                # 拒绝:从修正分布 norm(max(0, p - q)) 重采一个 token
                adjusted = (p - q).clip(min=0)
                adjusted = adjusted / adjusted.sum()
                accepted.append(int(sample(adjusted)))
                break# 截断:后续草稿全部作废
    return accepted
关键点就两个:
-
贪心模式:每个位置只比较草稿 token 是否等于目标的 argmax。相等就接受;一旦不等,用目标的 argmax 替代并停止——这保证了输出和目标模型贪心解码逐字一致。
-
采样模式:用接受概率
min(1, p(x)/q(x))决定是否接受草稿 token。这里的直觉是——如果草稿猜的 token 在目标分布中概率更高,一定接受;如果更低,按比率概率性接受。拒绝时不是直接丢掉,而是从修正分布norm(max(0, p − q))重新采样一个 token,这一步是”无损”的数学保证:最终每个 token 的输出概率严格等于目标分布p。被拒后立即停止验证后续位置(从截断处开始下一轮)。
三、核心概念速查
在深入各个方法之前,先建立几个核心概念的直觉。
3.1 接受长度(Acceptance Length,τ)
导师一次批改平均能接受多少个实习生的 token。τ = 4 意味着平均每次验证产出 4 个 token。
τ 越大,加速越明显。理想情况下 τ = k(草稿长度),意味着每次都全中。
3.2 加速比(Speedup)
开启推理加速后,生成速度是不开启时的多少倍。比如 4× 意味着原来 10 秒生成的文本现在 2.5 秒完成。
加速比和接受长度相关,但不是线性关系——还要考虑草稿模型的生成成本。
3.3 无损(Lossless)
输出分布和目标模型完全一致。不是”差不多”,是数学上的完全一致。这意味着:
-
不会因为用了加速而降低输出质量
-
可以安全地用于生产环境
-
和量化、蒸馏等有损压缩方法有本质区别
3.4 草稿模型 vs 目标模型
| 目标模型 | 草稿模型 | |
|---|---|---|
| 参数量 | 大(7B–70B+) | 小(通常目标模型的 1/20–1/50) |
| 速度 | 慢 | 快 |
| 质量 | 高 | 较低 |
| 作用 | 验证草稿,保证无损 | 快速猜测,提供候选 |
四、草稿模型的设计:一场”速度与准确率”的权衡
草稿生成+并行验证的加速效果,很大程度上取决于草稿模型的设计。这里有一个根本性的张力:
-
草稿越准(接受长度 τ 越大),验证的收益越高
-
草稿越快(生成延迟越低),整体加速比越高
但”准”和”快”往往冲突。过去一年半的技术演进,本质上就是不同团队在这个张力中寻找不同最优解的过程。
4.1 路线一:自回归草稿(EAGLE-3)
让草稿模型和目标模型一样,逐词生成 token。这样每个 token 都能看到前面已经生成的 token,依赖建模很强,准确率有保障。
但问题是:生成 k 个 token 要算 k 次。所以草稿模型必须极浅(通常 1 层 Transformer),否则草稿生成本身就变成瓶颈了。层数一浅,表达能力受限,准确率有天花板。
4.2 路线二:并行草稿(DFlash / DFlash 2)
让草稿模型一次性并行生成整块 token(比如 16 个),所有位置同时去噪。这样生成 k 个 token 只要算 1 次,草稿模型可以做深(5+ 层)。
但代价是:块内位置之间没有依赖交互,导致”选不对”和”块尾衰减”两个结构性问题。DFlash 2 就是在这个路线上做”精准化修正”。
4.3 路线三:半自回归草稿(DSpark)
折中方案:先用并行骨架一次性生成所有位置的基础特征,再用一个轻量顺序头逐位置精修。既保留了并行的速度,又补充了依赖建模。
同时 DSpark 还在验证端做了创新:不再固定验证长度,而是根据”存活概率”动态决定验证多长。
4.4 四条路线的关系
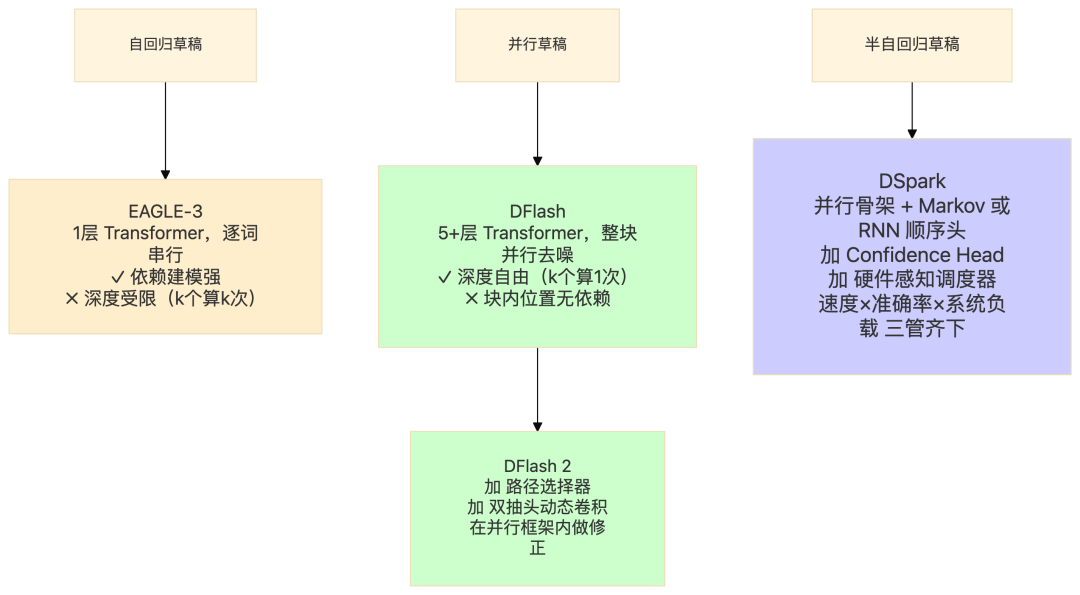
本系列文章就是沿着这条时间线从最新到最老逐一解读。
五、草稿验证 vs 其他推理加速方法
草稿验证不是唯一的推理加速方法,了解它和其他方法的区别有助于判断适用场景。
| 方法 | 原理 | 是否无损 | 额外内存 | 典型加速比 |
|---|---|---|---|---|
| 草稿验证 | 草稿猜测 + 目标验证 | ✅ 无损 | 需加载草稿模型 | 2–6× |
| 量化 (INT8/INT4) | 降低参数精度 | ❌ 有损 | 减少 | 1.5–3× |
| 知识蒸馏 | 训练小模型模仿大模型 | ❌ 有损 | 替换模型 | 2–5× |
| 结构化稀疏 | 跳过部分 attention 头 | ❌ 有损 | 不变 | 1.2–2× |
| 连续批处理 | 多个请求共享 GPU 计算 | ✅ 无损 | 不变 | 吞吐提升 2–4× |
草稿验证的独特价值在于:它是为数不多的”无损”加速方法之一,而且可以和量化、连续批处理等其他方法叠加使用——比如你先量化模型到 INT8,再开启草稿验证,两者互不干扰。
