你一定遇到过这种时刻:手上有一本三百页的扫描版 PDF——招股书、设备说明书、九几年的老教材——想把它变成 Markdown,好丢进知识库或者喂给 AI。
现在的通行做法是:拆成三百张图,一页一页喂给模型,再把结果拼起来。跑是能跑,麻烦都在接缝处:跨页的表格被切成两半,第 137 页末尾的半句话和第 138 页开头的半句话接不上,页码、页眉、页脚到处乱飞。更要命的是,模型每翻一页就把上一页忘得干干净净。
2026 年 10 月 27 日,百度开源了 Unlimited-OCR 2,想干的事情很直接:别一页一页读了,整本一次读完。
先看三个数字,感受一下它和现有方案的距离:
| 指标 | Unlimited-OCR 2 | 对照 |
|---|---|---|
| MPDocBench(几十页) | 84.59 | Qwen3.8-Max 78.30 |
| MarathonDocBench(100–300 页) | 77.06 | Kimi-K3 33.74 |
| 300 页峰值显存 | 1.77 GB | 47.00 GB(整本预填充) |
| 300 页每步解码 | 几乎不随页数增长 | 全注意力随页数线性变慢 |
同一张卡上,三百页文档的峰值 KV Cache 从 47.00 GB 压到 1.77 GB,吞吐从 360 TPS 提到 1,315 TPS。
这不是把上下文窗口简单堆大。它换了一套注意力机制。
一、先搞清楚:OCR 走到第几代了
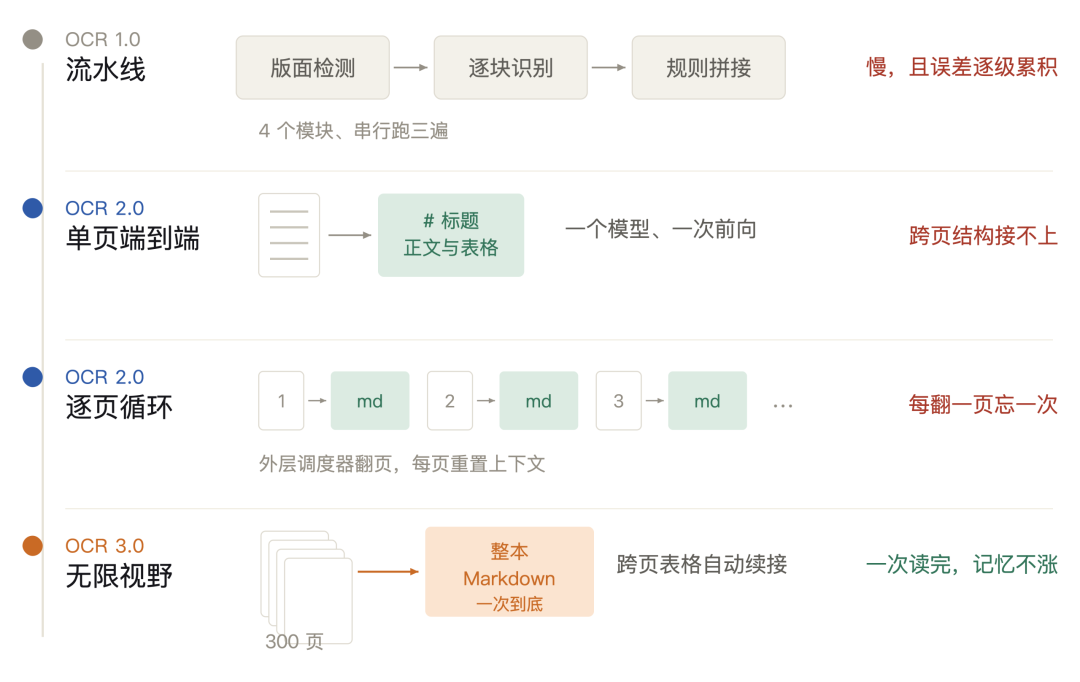
OCR 1.0 是流水线。 先用版面检测模型把一页切成块,再派文字识别、表格识别、公式识别几个模型分别处理,最后用一套规则拼成 Markdown。模块多、串行长,前一步错了后面全错。
OCR 2.0 是端到端。 一个视觉语言模型(VLM)把整页图吃进去,直接吐出 Markdown。中间模块没了,误差不再累积,单页精度大幅提升。
但 2.0 有个天花板:它的记忆只有一页。 想处理多页文档,只能在外面套一个 for 循环,翻一页、清空、重来。于是第 1 页和第 300 页互不相识,跨页结构必然断裂。
Unlimited-OCR 1.0(今年 6 月)往前迈了一步。 它改了解码器的注意力,让模型能一口气读完几十页——代价是上限卡在 40 页左右。
Unlimited-OCR 2 想迈的是第二步。 不设页数上限,三百页也是一次前向。
那为什么”读长”这件事这么难?
二、长文档的三笔账
把一本三百页的书喂给模型,有三笔账同时往上涨。
第一笔:KV Cache 越存越多。 大模型生成每个字时,都要回头看前面所有 token 的 key 和 value。这些 key/value 必须缓存着,不能重算。写第 10 万个字时,缓存里躺着 10 万份 key/value。
第二笔:注意力越算越慢。 每生成一个 token,都要拿它和前面所有 token 做一次相似度计算。序列翻倍,计算量翻四倍。这是 Transformer 的老毛病。
第三笔:视觉冗余越来越严重。 这一笔最容易被忽略。当模型正在抄第 250 页时,第 3 页的那些像素对它毫无用处——但标准的全注意力仍然要求它把第 3 页的每个视觉 token 都算一遍。
按官方配置,一页 1024 见方的扫描件会被压成 273 个视觉 token。三百页就是 81,900 个。模型每写一个字,都要和这八万多个 token 逐一打交道。
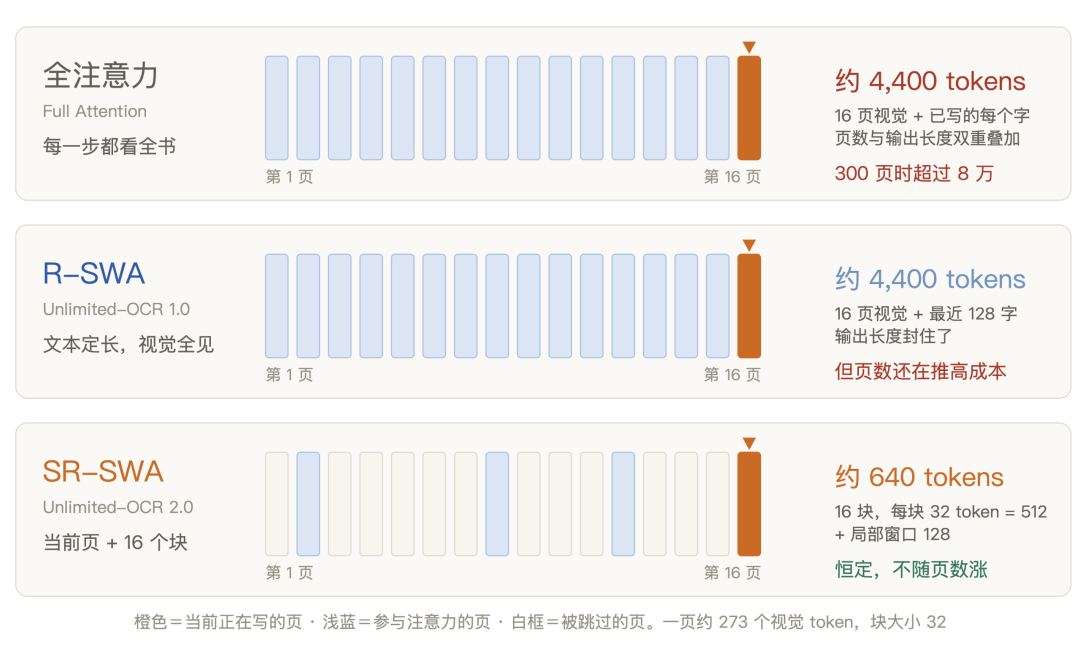
上一代的 R-SWA(参考滑动窗口注意力)解决了第一笔账的一半:它把文字记忆压缩成固定 128 个 token 的滑动窗口,写第 10 万字时也只往回看最近 128 个字。但视觉记忆它没动——仍要把全书所有页的视觉 token 全部看一遍。
所以 R-SWA 的 KV Cache 不随”写了多少字”增长,却仍然随”读了多少页”增长。几十页没问题,三百页就撑不住了。
Unlimited-OCR 2 的想法来自一个特别日常的动作。
三、人抄书的时候,眼睛在看哪儿
想象你手工抄一本厚书。你不会一边抄一边把前面抄过的每一页都在脑子里过一遍,也不会每抄完一页就把整本书忘掉。你的视线基本上只落在三个地方:
-
正在抄的那一页;
-
刚刚写下的几个字(保证句子连得上);
-
偶尔抬头翻一下前面某一页(因为这句话在引用它)。
论文把这种现象概括成一句话:多页文档的视觉依赖,本质上是”跨页稀疏、页内集中”的。
机器要模仿的,就是这个”看几眼”的动作。这就是 SR-SWA(Sparse Reference Sliding Window Attention,稀疏参考滑动窗口注意力)。
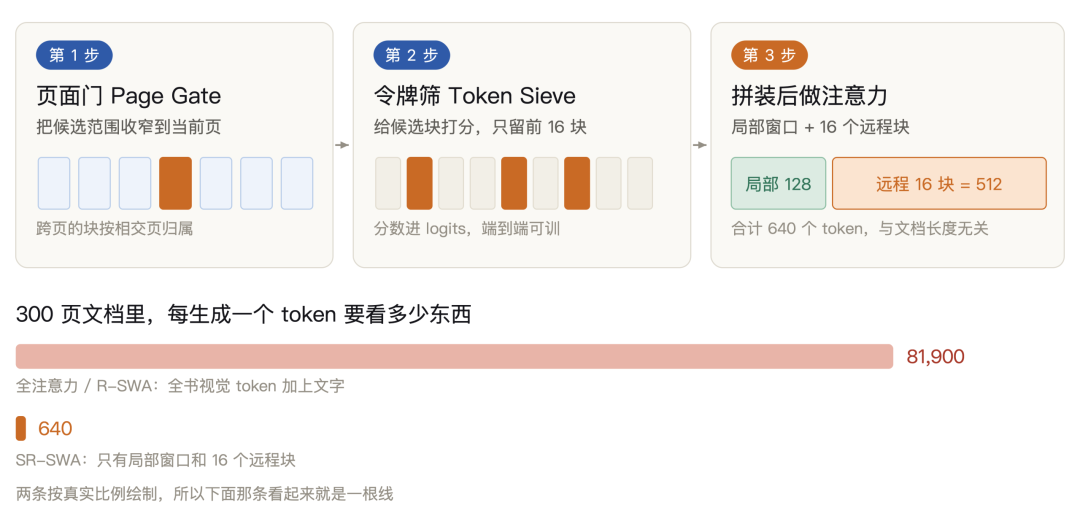
它分两步走。
第 1 步:页面门(Page Gate)——先把范围缩小到”几页”
模型把整本书的视觉 token 切成固定大小的块,每块 32 个 token。当一个 query 准备生成文字时,页面门先判断:这个 query 属于第几页?只保留和这一页(及其相邻页)相交的那些块,其余的直接不看。
块边界和页边界不一定对齐,所以一个块可能同时压在两页上。规则很简单:只要它和当前页有交集,就算候选。
这里还藏着一个很工程化的细节——位置编码怎么办?
模型本来用二维坐标(行、列)描述每个 token 在页面上的位置。可一旦页数涨到三百,如果还按”整本书第 82,000 个 token”来编号,位置数值会一路涨到训练时没见过的量级,模型直接懵。
页面门的做法是把位置拆成两层:一个是页号,用 0、1 交替的有限编码;另一个是页内坐标,照旧用二维行列。这样一来,无论第 1 页还是第 300 页,位置编码的取值空间都是同一套,长度外推自然就稳了。
第 2 步:令牌筛(Token Sieve)——从候选里挑 16 块
候选范围缩小后,还要再挑。每个候选块会被压成一个 128 维的”摘要 key”,然后和当前 query 算一个相关度分数。
接着用 α-entmax 把这个分数变成稀疏分布——entmax 的特点是能输出精确的 0,不像 softmax 那样每个位置都给一点概率。再取分数最高的 16 个块。
被选中的块数量是固定的:16 块 × 32 token = 512 个远程 token。加上永远保留的局部窗口 128 个 token,每个 query 实际要看的东西固定在 640 个——不管文档是 10 页还是 300 页。
一个容易被忽略的设计
传统的稀疏注意力(比如 DeepSeek-V3.2 那类做法)通常要用一个”稠密注意力教师”去蒸馏路由网络:先让全注意力算出正确答案,再教稀疏版本模仿它该看哪几块。这种做法绕了一道,路由器和语言模型的目标并不直接对齐。
SR-SWA 把路由分数直接当成注意力分数的一部分:被选中的块,除了正常的 q·k 点积,还会额外加上一个由路由概率换算来的偏置项。这个偏置会参与 softmax,也就意味着——语言模型的梯度可以直接传回路由器。
结果就是:路由器不需要额外的蒸馏损失,跟着主任务一起训就行。
还有个小细节值得一提:路由分数在加进 logits 之前,会先减去被选中块的均值,做一次中心化。这样做是为了保住块与块之间的相对偏好——本来排第 3 的块,不会因为整体加了个偏置就掉到第 15。
四、整个模型长什么样
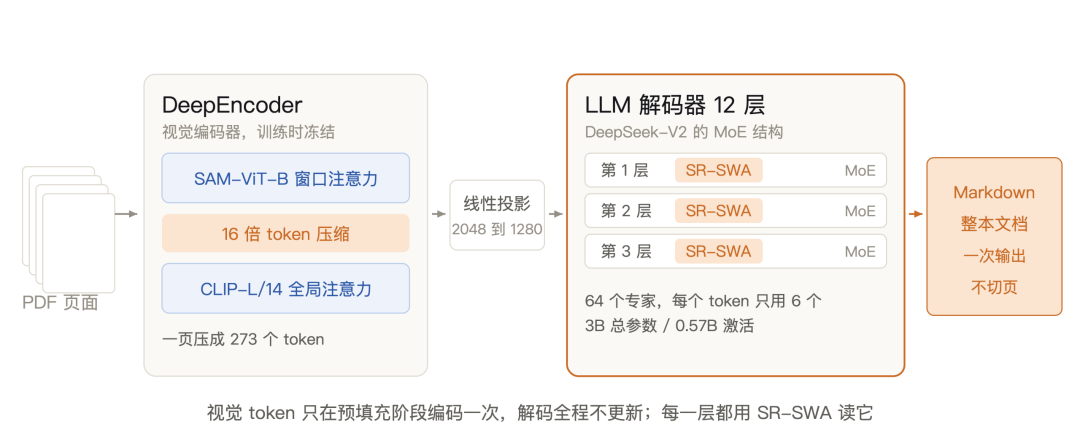
骨架沿用 DeepSeek-OCR 那一套,两段式:
前半段是视觉编码器 DeepEncoder,由百度自研。它把两种视觉模型串起来用:
-
先是 SAM-ViT-B,12 层,用窗口注意力。窗口注意力的好处是开销跟分辨率线性相关,处理 1024×1024 的原始像素不心疼;
-
中间做一次 16 倍 token 压缩;
-
然后是 CLIP-L/14,24 层,用全局注意力。此时 token 数已经很少了,全局注意力才付得起这个代价。
这个”先便宜地看细节,压缩后再全局地看结构”的组合,是 DeepEncoder 能在低显存下处理高分辨率页面的关键。一页 1024 见方的扫描件,出来只有 273 个 token。
后半段是解码器:12 层 MoE,64 个路由专家 + 2 个共享专家,每个 token 只激活 6 个专家。总参数 3B,实际激活约 0.57B。每一层的注意力都换成了 SR-SWA。
视觉 token 有个特殊待遇:它们只在预填充阶段编码一次,整个解码过程不再更新。 这一条很重要——正因为视觉部分是静态的,才有可能对它做”跳页”和”分块驻留”。
训练方面,数据是 2M 多页文档 + 10M 单页文档,伪标签来自 MinerU2.5-Pro 和 PaddleOCR-VL-v1.6,再用合成数据补充版式多样性,最后用 MinerU-Popo 做跨页结构的一致性校正。
训练规模:25 台 8 卡 H800,全局 batch 1,600,最大序列长度 64K,只训 1 个 epoch。视觉编码器和投影层全部冻结,只优化 LLM 部分,学习率 2.5e-4,AdamW + 余弦衰减,用 MS-Swift 框架。
只训 1 个 epoch、还冻结编码器,说明这套架构的改造是”轻量后训练”,不是从头重训。这对想复现的团队是个好消息。
五、注意力省了,显存还在涨,怎么办
注意力预算固定到 640 之后,新问题冒出来:三百页的视觉 KV 还是得存着。
哪怕每次只用 640 个,你也得先把三百页全部预填充(prefill)一遍——三百页 × 273 token 的 KV 摆在显存里,这就是那 47 GB 的来源。
论文给的解法叫 Unlimited-Horizon Decoding(无限视野解码),说白了就是把书拆成几段读,但在边界页上留个书签。
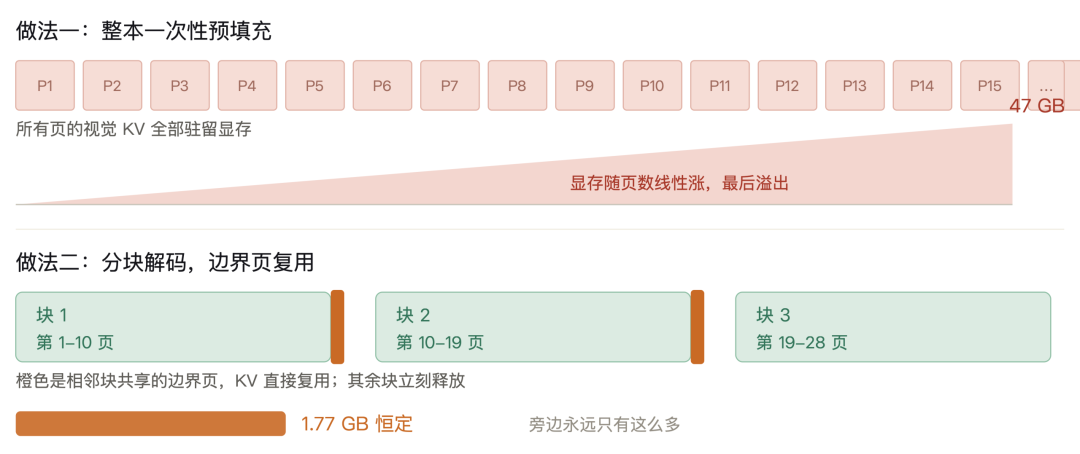
具体做法:把文档按 10 页一段切块,相邻两块共享一个边界页。
-
读第一段(第 1–10 页),生成这十页的内容;
-
读完第一段,除了第 10 页的 KV,其余全部释放;
-
读第二段(第 10–19 页),第 10 页的 KV 直接复用,不用重算——这就是”跨段连续性”的保证;
-
再往下,重复。
于是 GPU 里永远只驻留一个块,显存占用和文档总长度解耦。
效果:单序列推理峰值 KV Cache 从 47.00 GB 降到 1.77 GB,降了 26.6 倍;B=16 并发下吞吐从 360 TPS 涨到 1,315 TPS,涨了 3.6 倍。
代码层面上,这套逻辑被集成进了 SGLang,通过几个环境变量控制:SGLANG_UOCR_DOC_GUNDAM_PAGE_WINDOW 控制每段多少页,SGLANG_UOCR_EANABLE_DOC_LIMIT=0 则退回”整本一个窗口”的模式。
论文自己点出了一个权衡:段切得越小,显存越省,但跨页合并的质量越差——因为跨段边界的表格块会失去上下文。这个参数不是越小越好。
六、成绩单
先交代这两份考卷。它们本身不是指标,是指标算出来的地方。
MPDocBench 是外部团队建的公开基准,几十页量级——中位只有 6 页,跨页结构也不算多,含跨页表格的文档只占 11%。MarathonDocBench 是这次新建的,100 篇文档、103–300 页、20.5 万个标注版式元素。真正拉开难度的是跨页结构的密度:每篇文档平均有 36.3 处文字被翻页切断(老基准 3.2 处,11 倍),平均 13.2 张表格横跨两页(老基准 0.23 张,57 倍),含跨页表格的文档占到 82%。
分数怎么算:文字内容和阅读顺序,跟人工标注比编辑距离相似度;表格结构用 TEDS;公式用 CDM;图区用 F1;再单独加两项跨页指标 T-TextEdit 和 T-TEDS,专门看被翻页切断的内容有没有接上;最后加权汇总成一个 Overall 总分。下面说的 84.59、77.06 都是 Overall,越高越好。
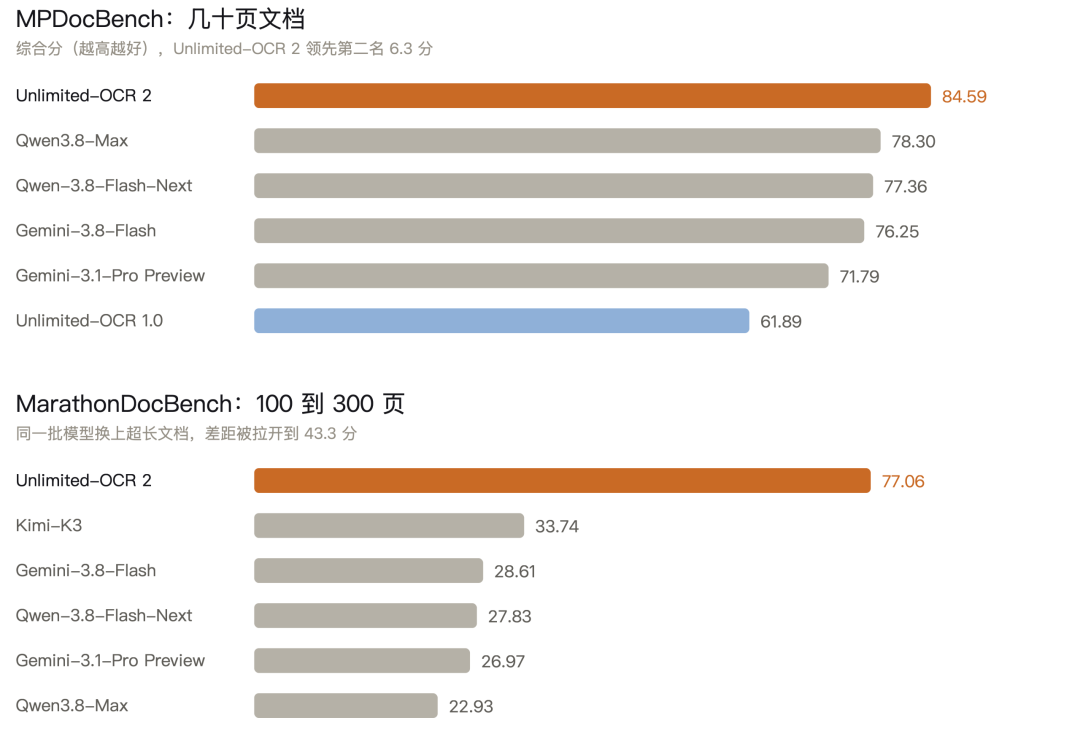
几十页这一档,MPDocBench 综合分 84.59,比 1.0 的 61.89 高了 22.7 分,比 Qwen3.8-Max 高 6.3 分。细分指标里最亮的是标题层级(Heading TEDS 60.10 vs 48.80)和跨页表格(T-Table TEDS 89.54 vs 88.36)。
上百页这一档,MarathonDocBench 上它拿到 77.06 分,第二名 Kimi-K3 只有 33.74。这个差距说明一件事:现有模型不是”稍微差一点”,而是根本没建立上百页文档的解析能力。顺带一提,Unlimited-OCR 1.0 因为 40 页的输入上限,在这个榜单上直接没法参评。
单页能力没有退化。 OmniDocBench v1.6 上 94.02 分,和 1.0 的 93.92 基本持平。也就是说稀疏注意力没有牺牲细粒度识别——这一点比分数本身更重要,很多稀疏化方案就是死在这一步。
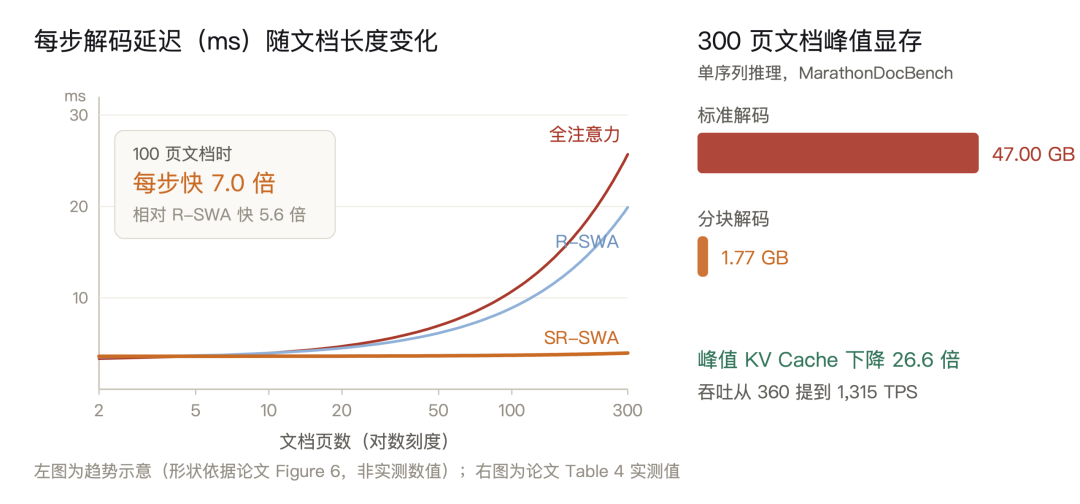
效率曲线才是这个工作的核心卖点。 三百页时,每步解码延迟比全注意力快 7.0 倍,比上一代 R-SWA 快 5.6 倍;更要紧的是这条曲线是平的——页数从 2 涨到 300,每步延迟基本不动。
对比之下,主流 VLM 在长文档上的精度会一路下滑,论文 Figure 6a 里有一条基线在 223 页处直接跑挂。Unlimited-OCR 2 的精度曲线,从 30 页到 300 页几乎是一条直线。
七、它还不擅长什么
论文的 Limitation 部分写得很坦白,值得原样转述:
第一,它不保留全局文档信息。 稀疏注意力每次只看当前页和几个远程块,“整本书的标题层级是什么样”这类全局结构,它其实是推不出来的。所以 Heading TEDS 虽然比对手高,但绝对值只有 60 分左右。论文提出的后续方向是引入线性注意力来保留全局信息——用恒定的每 token 成本记住”整本书的骨架”。
第二,训练数据的多样性还不够,泛化性有提升空间。
第三,部署有门槛。 想跑出论文里的效率,需要用他们提供的定制 SGLang wheel(wheel/sglang-0.5.20.dev10+g8d62f5fb9c),而且要调一堆显存参数:mem-fraction-static 建议 0.7 而不是 0.75,max-prefill-tokens 从 4096 降到 2048 能砍掉一半峰值,SAM 注意力偏置的分块上限要从 512 调到 64 才能避免一次 462 MiB 的大分配。
这些都是实操坑,README 里写得很细,照抄基本能跑通。
八、怎么上手
模型权重(MIT 许可,可商用):
1.0 在 Hugging Face 上已经有 300 多万次下载、4,900 多个赞,还上过 Trendshift 日榜。2.0 是今天刚发的。
方式一:Transformers,适合快速验证
import torch
from transformers import AutoModel, AutoTokenizer

model_name = "baidu/Unlimited-OCR-2"
tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)
model = AutoModel.from_pretrained(
    model_name, trust_remote_code=True,
    use_safetensors=True, torch_dtype=torch.bfloat16
).eval().cuda()

# 多页:按页码顺序传图,一次请求解析整份文档
pages = [f"your_doc/page_{i}.jpg" for i in range(1, 8)]
text, num_tokens = model.infer_multi(
    tokenizer, image_files=pages,
    output_path="output/multi", save_results=True
)

# 单页:默认开启动态切片(gundam 模式),细节更足
text = model.infer(tokenizer, image_file="your_doc/page_1.jpg",
                   output_path="output/single", save_results=True)
多页推理时,模型会自动拼出 "<PAGE><image>" * 页数 + "Multi page parsing." 这样的 prompt,输出里每页对应一个 <PAGE> 标记,顺序和输入一致。
方式二:SGLang,官方推荐的生产路径
需要 Python 3.10 环境,装定制 wheel 和 PyMuPDF:
uv venv --python 3.10
source .venv/bin/activate
uv pip install wheel/sglang-0.5.20.dev10+g8d62f5fb9c-py3-none-any.whl
uv pip install pymupdf==1.27.2.2 fastokens==0.3.2
启动服务(关键参数,其余见 README):
注意这个变量名:官方 README 里就拼成了 EANABLE(不是 ENABLE),照抄才能生效。
export SGLANG_UOCR_EANABLE_DOC_LIMIT=1        # 1=分块,0=整本一个窗口
export SGLANG_UOCR_DOC_GUNDAM_PAGE_WINDOW=10  # 每段页数,越小越省显存
export SGLANG_UOCR_MAX_PAGE_TOKENS=20000      # 单页输出上限
export PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True

python -m sglang.launch_server \
    --model-path baidu/Unlimited-OCR-2 \
    --served-model-name Unlimited-OCR-2 \
    --chat-template unlimited-ocr \
    --mem-fraction-static 0.7 \
    --max-prefill-tokens 2048 \
    --enable-custom-logit-processor \
    --enable-streaming-session \
    --host 0.0.0.0 --port 10000
然后按 OpenAI 兼容格式发请求即可。请求体里有三个参数要注意:
-
images_config.crop_mode:true是 gundam 模式(动态切片,适合单页高精度),false是 base 模式(整页一个视图,适合多页); -
max_tokens:整份文档的总输出预算,必须为正; -
custom_logit_processor和custom_params:这里塞的是那个 n-gram 去重复处理器(ngram_size=35),别漏掉,否则长文档容易出现重复循环。
九、这件事的意义
如果只看分数,这是一次很扎实的 SOTA 刷新。
但更值得记下来的是它的方法论:别急着把上下文窗口从 32K 堆到 1M,先想清楚”读长文档时,模型到底需要看什么”。
人类的答案很朴素:只看正在读的那一页,偶尔回头翻一两页。SR-SWA 就是把这个动作翻译成了注意力掩码——页面门决定”哪几页”,令牌筛决定”哪几块”,加起来 640 个 token,跟文档多长无关。
整篇论文里我最喜欢的一句话,是它引用网友的那句改编(原文仿《Fate》的咏唱):
像素是我的躯体,token 是我的血液。(以下为意译) 我已解析过一千页,不知 KV Cache 为何物,亦不知上下文上限为何物。 故我祈愿——Unlimited OCR Works。
玩笑归玩笑,技术上这件事是可推广的。论文明确说,R-SWA / SR-SWA 不只适用于 OCR:语音识别、机器翻译这类”输入是长参考、输出是长转录”的任务,本质结构完全一样——参考部分是静态的,输出部分是流式的。把参考部分做成可稀疏检索的固定预算,把输出部分做成滑动窗口,就能绕开二次方复杂度。
三百页一次读完,只是一个开始。
参考链接
-
技术报告(Unlimited OCR Works 2,PDF 在仓库根目录)
本文数据均来自官方模型卡、技术报告与 GitHub 仓库;图 1–图 7 为作者依据论文内容绘制。
