概要
LLAMA4在4.5号匆匆发布之后,虽然榜单数据表现不错,但是网友实测显示效果差强人意。当前关注度远低于竞争对手,即使从性价比的角度来看,应用价值也比较有限。本文总结整理了LLAMA4发布后各方的反馈,以下是一些相关信息。
发布时间更改
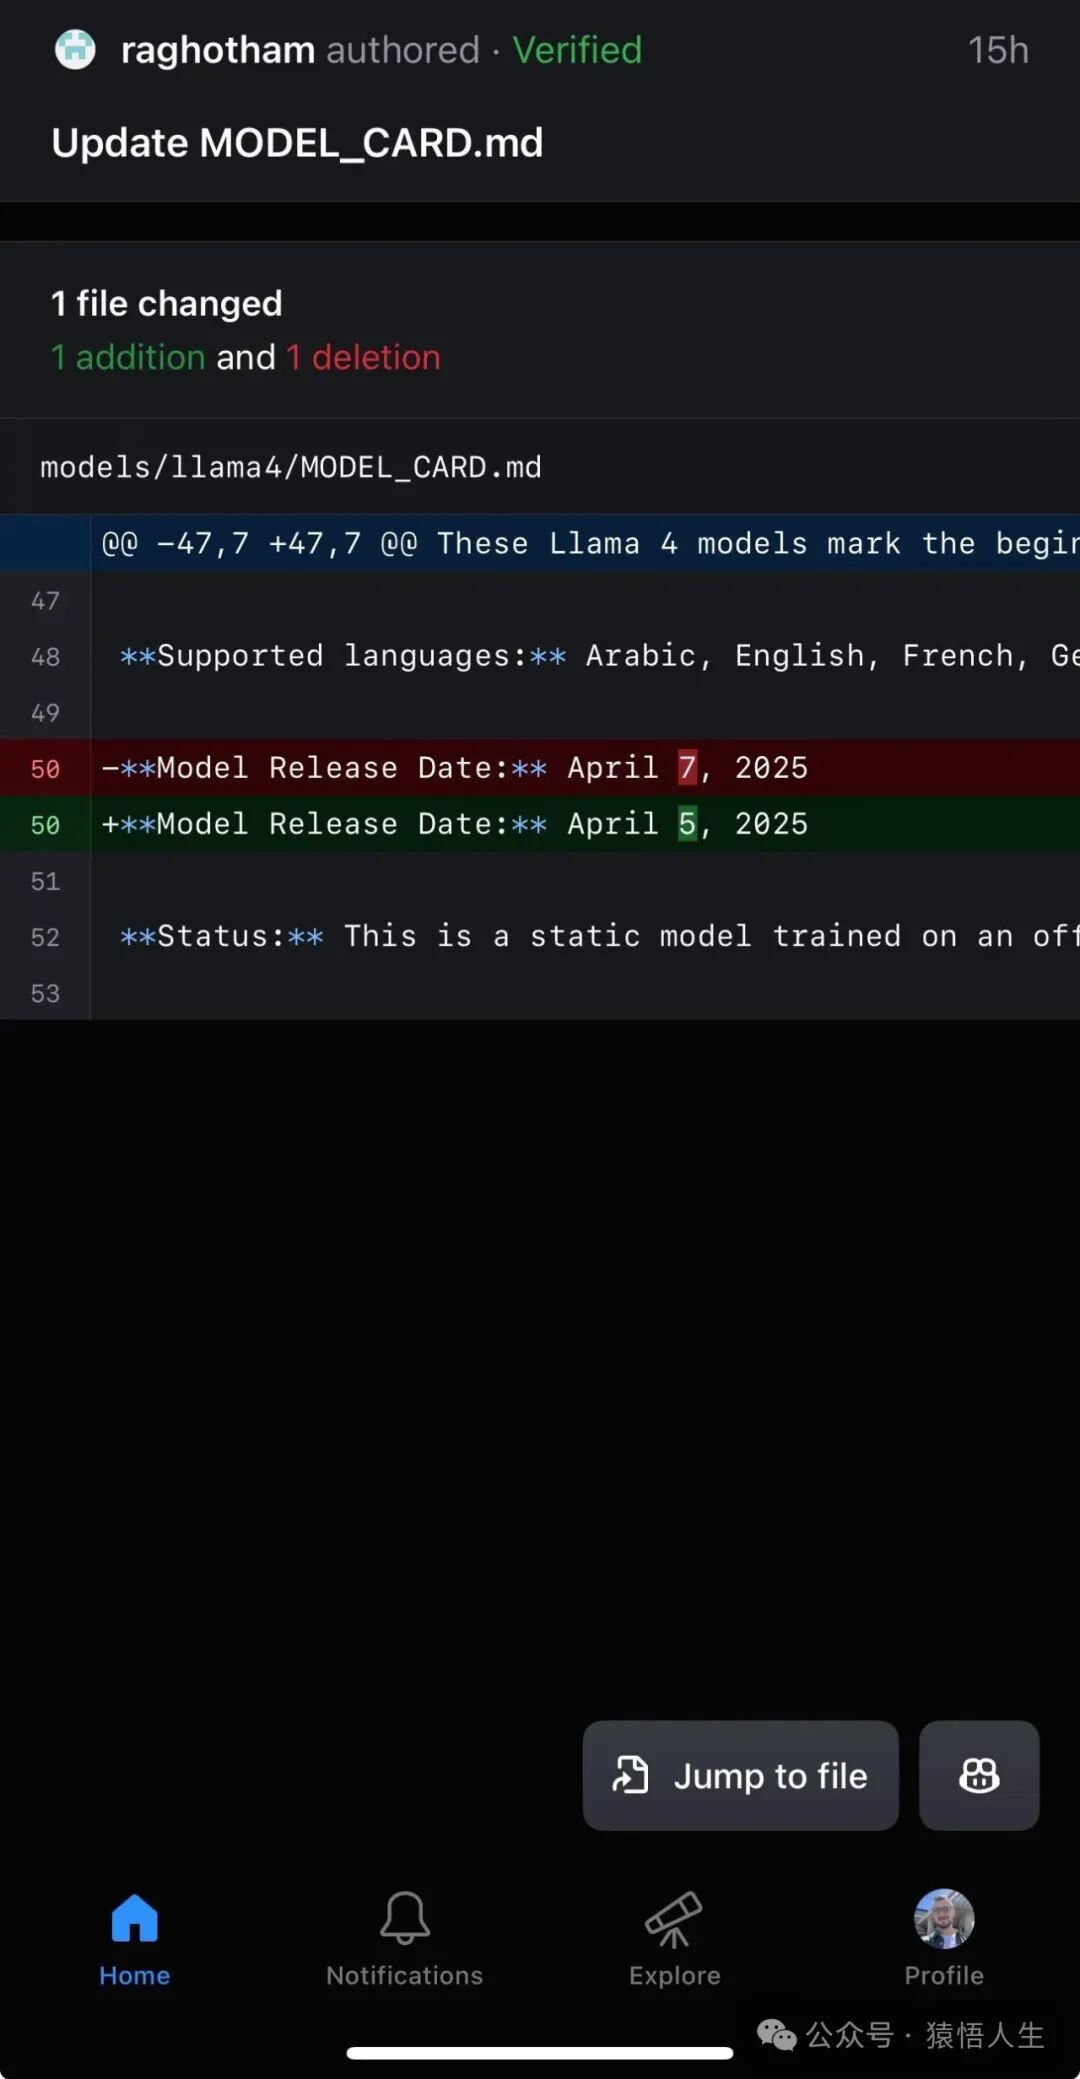
细心的网友发现,LLAMA4原定于4.7号发布,但后来不知何故改为了4.5号发布。猜测的原因有如下几个:
-
他们希望自己的失败被4.7的整体市场崩盘所淹没。他们更愿意与其他科技公司一起遭受打击,而不是冒险在周二股市崩盘,而那时市场的其他部分可能已经稳定下来。
-
坏消息通常在周末发布,那时没有人注意。
-
有消息认为本周阿里会发布Qwen系列,或者Deepseek会有新动作,担心受到影响。
性价比表现一般
LLAMA4本次发布的模型主要有三个,其中:
-
Llama-4-Scout-17B-16E, (其实是109B)MoE模型,多模态输入,16个专家,激活参数量17B,上下文长度10M,知识截至时间2024年8月
-
Llama-4-Maverick-17B-128E,(其实是402B) MoE模型,多模态输入,128个专家,激活参数量17B,上下文长度1M,知识截至时间2024年8月
-
Llama-4-Behemoth-288B-16E,(其实是2T),还在训练中。
其中,Scout和Maverick两个模型的实际性价比如下图所示:
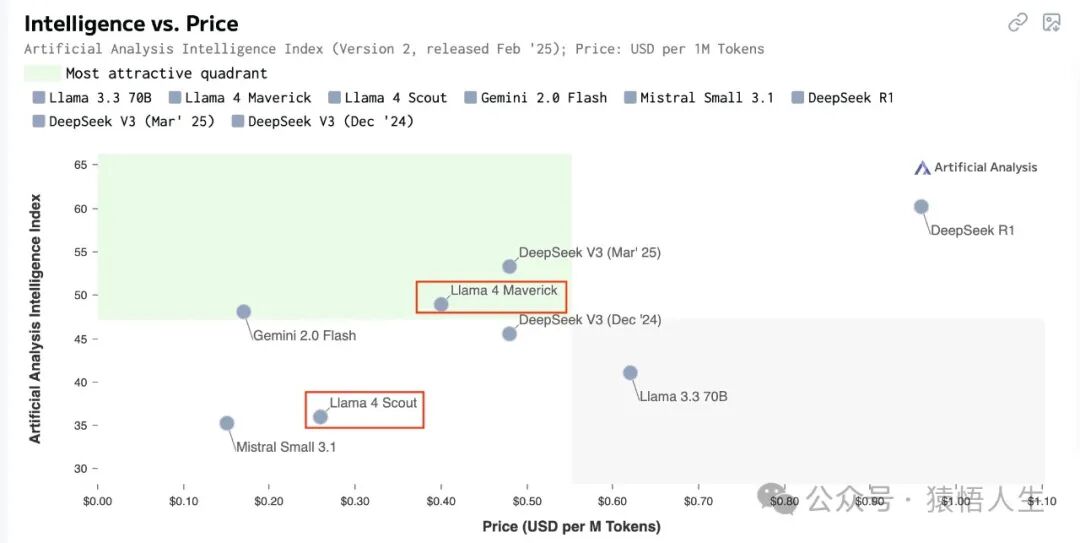
注:横轴是价格,纵轴是能力水平。
可以看到,这两个模型当前的性价比其实都不太高。
评测表现
编码能力
Aider Leaderboard的评测结果显示,llama-4甚至打不过2024年11月初的qwen-coder-32B,效果真是一言难尽。具体详见下图:
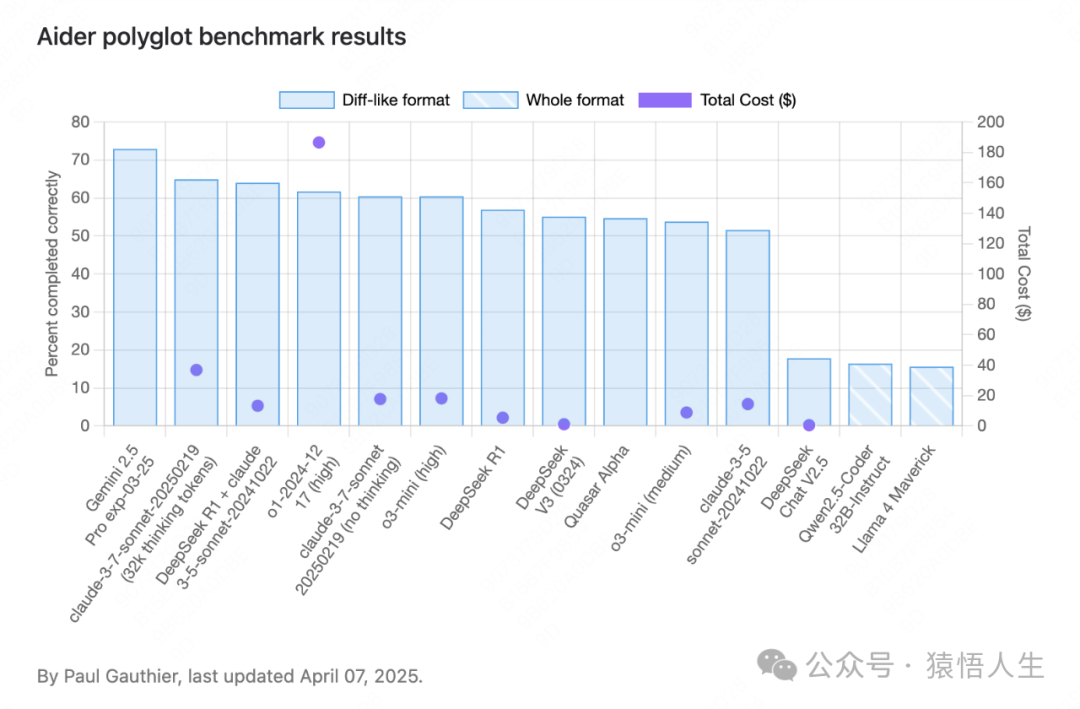
网址:https://aider.chat/docs/leaderboards/
以常见的小球弹跳测试验证下效果,可以看到,效果惨不忍睹:
考虑到 llama-4-maverick足足有402B 大小,还不如直接用DeepSeek-V3-0324算了,甚至用Qwen-QwQ-32B也胜在小巧,性价比更高。
长上下文应用效果
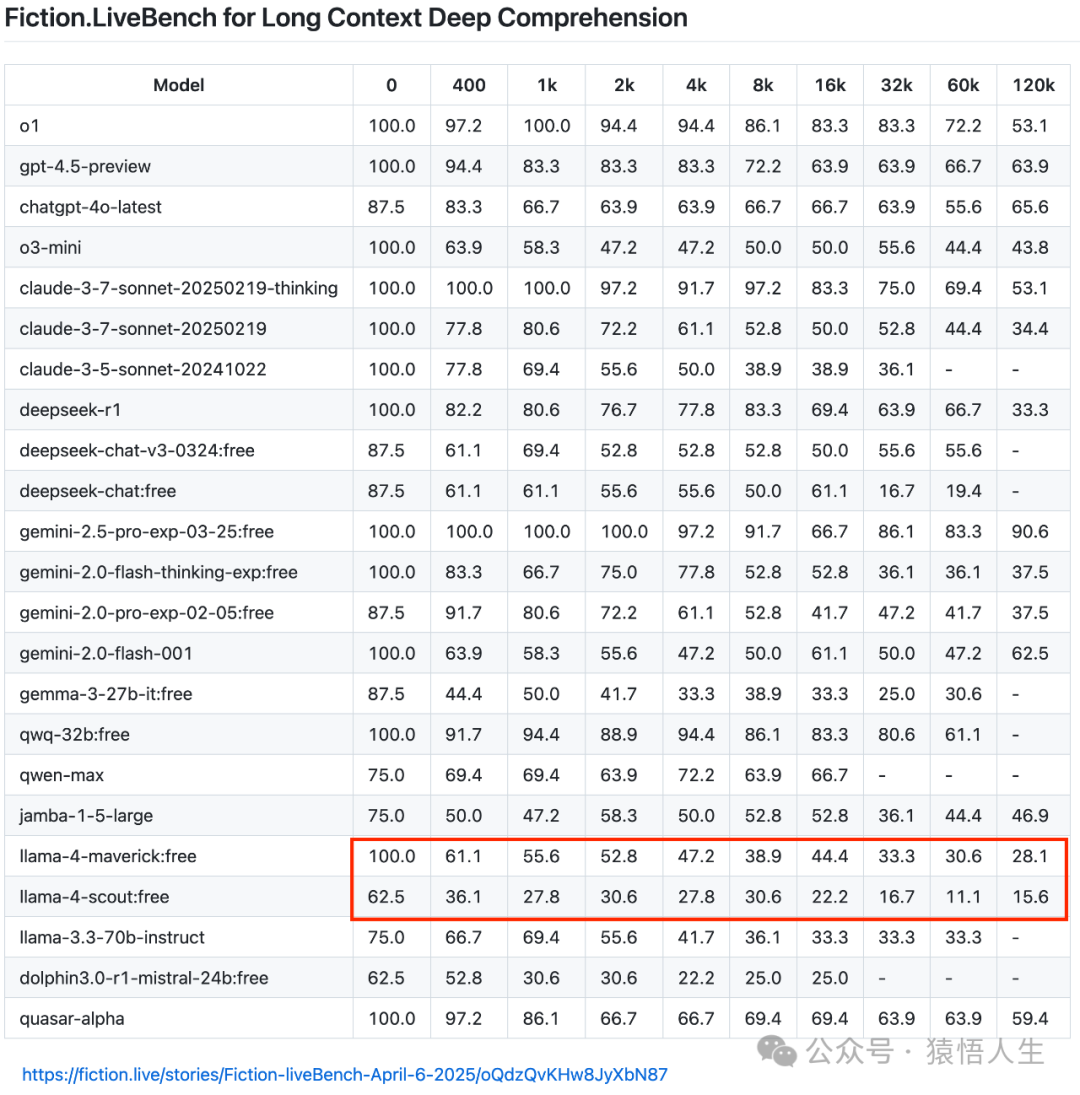
LLAMA4支持长上下文(1M~10M),但是Fiction.LiveBench的实际测试表明,llama-4在1K上下文召回(评测分数实际是问题回答的正确率)就已经降到60%以下了,甚至 llama-4-scout 超过16K只有22%。而《哈利波特与魔法石》差不多正好是16K左右,这意味着你把这本书塞进去,然后问哈利小时候生活在卧室还是楼梯下面的储物间,llama-4-scout 只有22% 的机会能答对(近似理解,实际上召回要再复杂点),这个分数其实是远低于头部的平均水平的。
总结
目前LLAMA4在外网上疯狂被吐槽(详见:https://www.reddit.com/r/LocalLLaMA/),网友甚至做了相关图片来吐槽当前LLAMA4的实际表现,以及Meta以及扎克伯格在面对Deepseek和Alibaba激烈竞争下的应对失措。