通过网络流量逆向工程GPT-4o图像生成
reddit上有网友seicaratteri逆向了一下 GPT-4o 的生成图片的网络请求返回。发现 GPT-4o 生成可能是多步骤的,即它并不是一次生成完整的图片,而是先生成,然后再优化(类似ComfyUI中的流程)。如果GPT-4o并不是基于扩散模型(diffusion model),而是个自回归模型(autoregressive model)。
这是否意味着新的图像生成模式要全面铺开?另外,也可以期待下效果比 diffusion 要好的开源模型的到来。
原贴翻译
我对这个新模型非常感兴趣;我一直在图像生成领域做了很多工作,我想了解到底发生了什么。
我在打开网络选项卡查看后端(BE)发送的内容时发现了一些有趣的细节——以下是我的发现。我尝试了几个不同的提示语,我们先从这个开始:
“一只快乐的小狗在街上跑,吉卜力工作室风格的图像”
在这里,我得到了四张中间图像,具体如下:
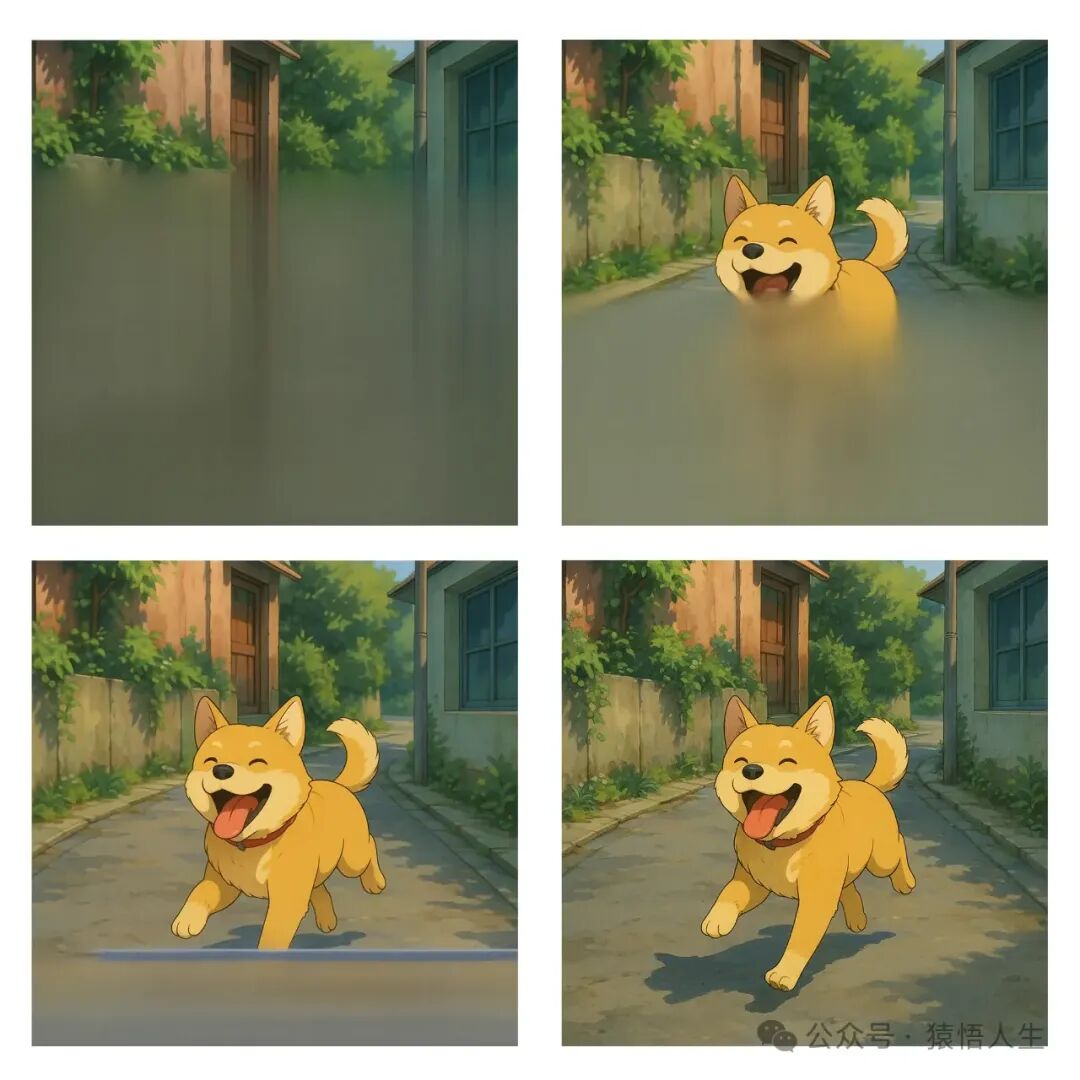
我们可以看到:
-
后端实际上返回了我们在用户界面中看到的图像。
-
目前还不清楚生成过程是否是自回归的——我们可以看到一些细节和图像的模糊全局结构,这可能意味着两件事:
-
像通常的扩散过程一样,我们先生成全局结构,然后添加细节;
-
或者,图像实际上是自回归生成的。
如果我们分析第一帧和最后一帧的100%缩放,可以看到细节被添加到高频纹理上,比如树木。
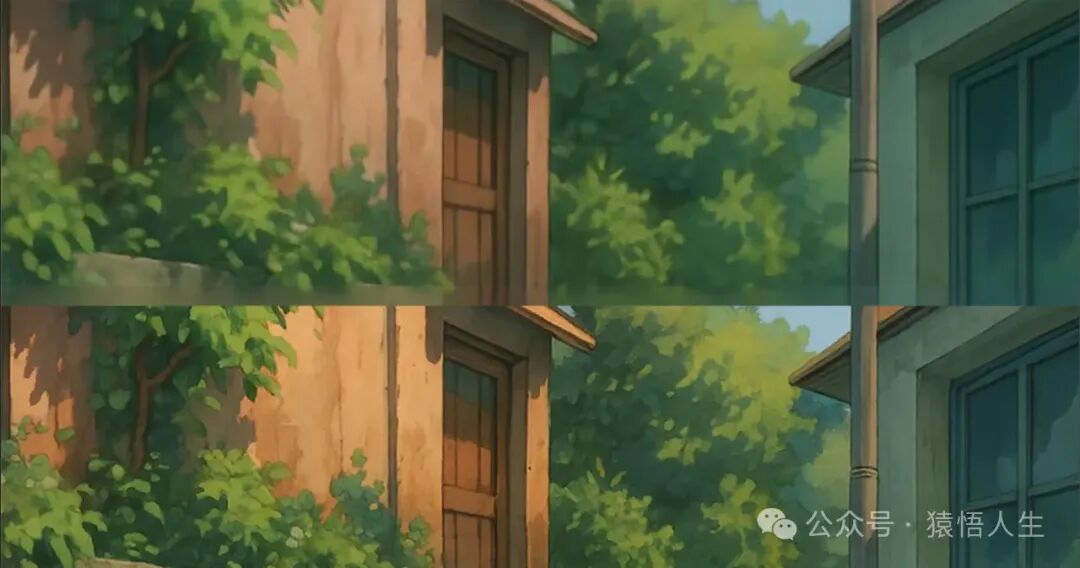
这正是我们通常从扩散模型中期待的结果。在另一个例子中,这种情况更加明显,我特意提示了一个高频细节纹理(“创建一张颗粒状纹理的图像,抽象形状,极其高度详细”)。
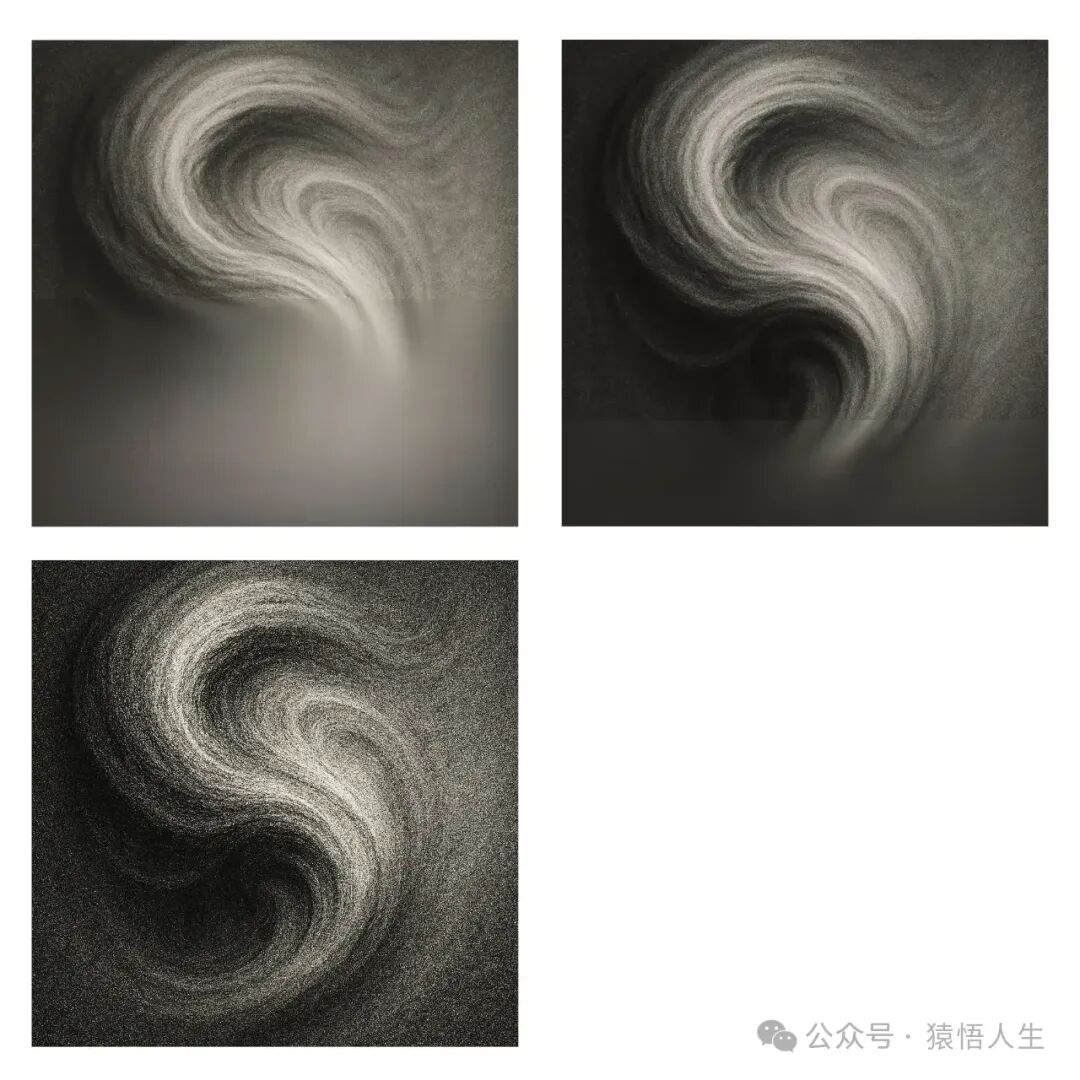
有趣的是,这里我只从后端得到了三张图像;细节的添加非常明显:
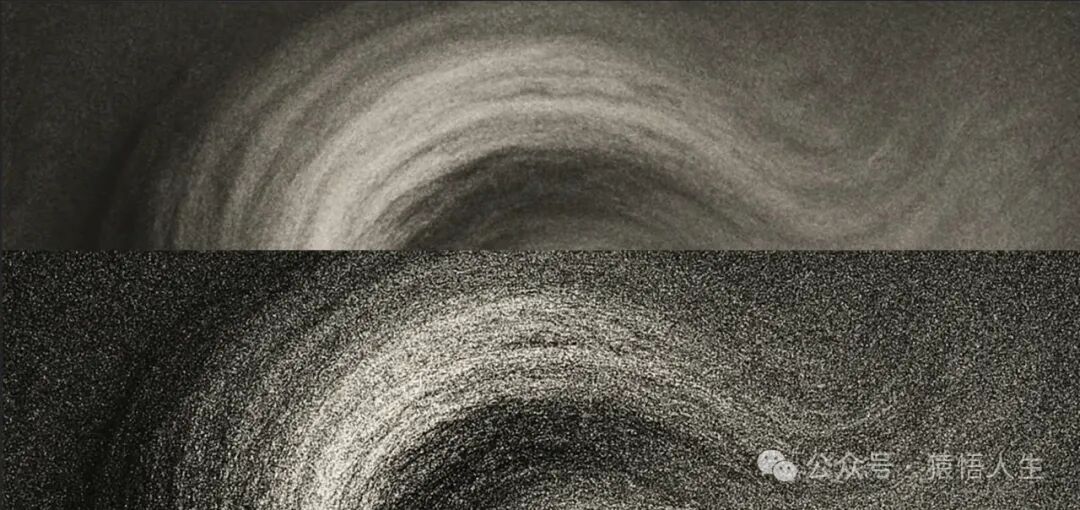
当然,这也可能作为一个单独的后处理步骤完成,例如像SDXL当年引入的精炼模型(refiner model),专门训练用于在解码到像素空间之前为VAE潜在表示添加细节。
还不清楚我用这个提示语得到较少的图像是因为可用性(即后端可以给我更多计算资源),还是某种特定优化(例如:潜在缓存)。
所以我现在的想法是:
-
这可能是一个多步骤的处理管道。
-
OpenAI在模型卡中提到:“与作为扩散模型运行的DALL·E不同,4o图像生成是一个自回归模型,原生嵌入在ChatGPT中。”
-
这让我想起了最近的一篇论文:OmniGen(链接:https://arxiv.org/pdf/2409.11340)。
在OmniGen中,他们直接将潜在扩散架构的VAE连接到一个大语言模型(LLM),并学习共同建模文本和图像;他们观察到少样本能力(few-shot capabilities)和新兴属性,这也可以解释GPT-4o的广泛能力。如果我们考虑OpenAI一贯的公式,这就更有意义了:
-
更多/更高质量的数据
-
更多的计算资源(flops)
OmniGen提出的架构完全基于Transformer,具有很大的扩展潜力——如果我们知道一件事,那就是Transformer的扩展性很好,而OpenAI尤其擅长这一点。
你们怎么看?我很希望把这个作为一个共同探索的空间!感谢你们阅读,让我们一起深入研究吧!
补充信息
openAI之前放出的图片里其实有提到模型的一些“细节”信息:
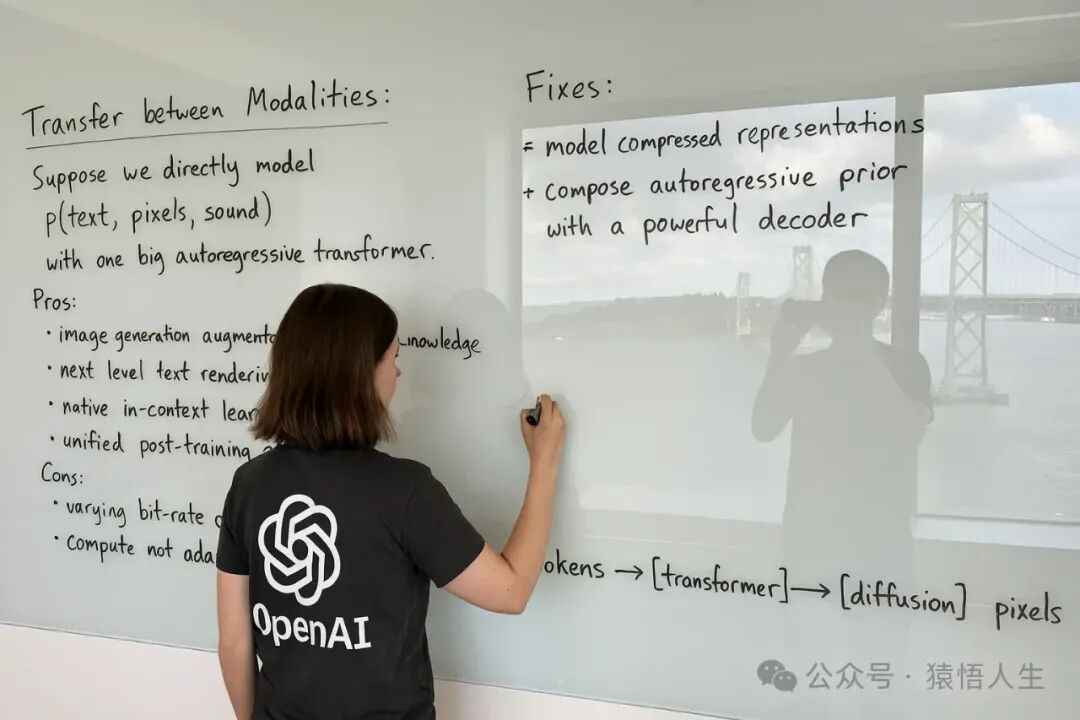
跨模态转移:
假设我们直接建模:P(文本,像素,声音)
使用一个大型自回归Transformer
优点:
-
图像生成增强
-
下一级文本渲染
-
原生上下文学习
-
统一的预训练
缺点:
-
变化的比特率
-
计算不适应
修复:
-
模型压缩表示
-
结合自回归先验与强大的解码器
流程:
- 标记 → [Transformer] → [扩散] → 像素
OmniGen
OmniGen是一种新的统一图像生成扩散模型,可以在单一框架内处理各种任务。它以统一性、简单性和知识转移为特征。OmniGen不仅展示了文本到图像生成的能力,还支持图像编辑、主题驱动生成和视觉条件生成等任务。它简化的架构消除了对额外插件的需求,可以通过指令完成复杂任务,无需额外的中间步骤。OmniGen有效地跨不同任务传递知识,管理未知任务和领域,并展现出新颖的能力。这项工作代表了通用图像生成模型的首次尝试。
OmniGen架构
OmniGen 的主要架构如下:
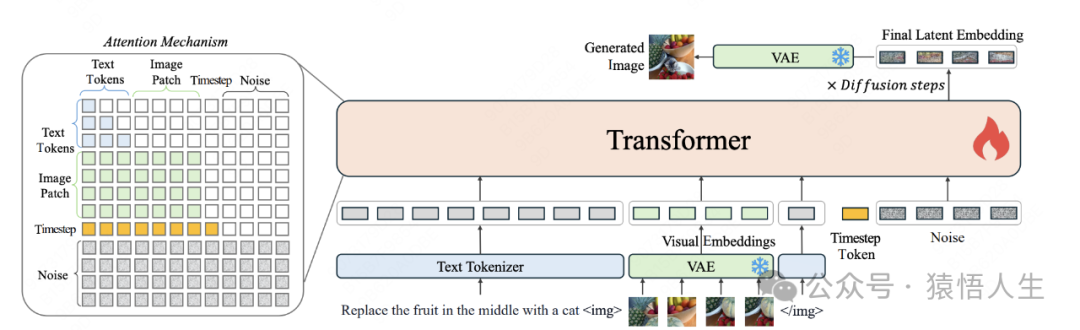
OmniGen 采用了一个由 VAE 和预训练的大型 transformer 模型组成的架构。具体来说:
-
它使用了 SDXL 的 VAE 来提取图像的连续视觉特征。
-
它使用由 Phi-3 初始化的 transformer 模型根据指令生成图像。
这种架构具有以下特点:
-
简单性: OmniGen 的架构非常简洁,不需要额外的插件。相比现有的扩散模型,它更加用户友好,可以通过指令直接完成复杂的任务,大大简化了图像生成流程。
-
统一性: OmniGen 不仅具有文本到图像生成的能力,还可以支持图像编辑、主题驱动生成和视觉条件生成等多种下游任务。
-
知识迁移: 通过统一格式的训练,OmniGen 可以有效地将知识迁移到不同的任务和领域,并展现出新的能力。
写在最后
希望国内尽快能推出对标且开源的模型,满足国内外网友对此的期待。哈哈~~