大家好,我是Aaron。当前在实践”辅助AI编程”,目前有个比较火的词语是”干中学”。因此,我希望能通过一步步完善项目,来掌握RAG相关知识。因此正在开发一个名为ragflow4j(https://github.com/aaronshan/ragflow4j) 的项目。为了方便记录,我会在每天结束时让AI总结今天的开发进展,同步到公众号。
欢迎大家关注我关注公众号,第一时间收到更新推送,一步一步一起开发RAG引擎。
项目简介 📖
ragflow4j(https://github.com/aaronshan/ragflow4j) 是一个开源的 RAG(检索增强生成)引擎。与 Dify、Ragflow 等不同,它是用 Java 开发的。市面上类似的产品大多使用 Python 开发。我希望通过这个项目能帮助以 Java 为主要开发语言的开发者更好地理解 RAG 的整体机制。
今日工作内容 ✨
1. 核心功能开发进展
1.1 文档加载器框架实现
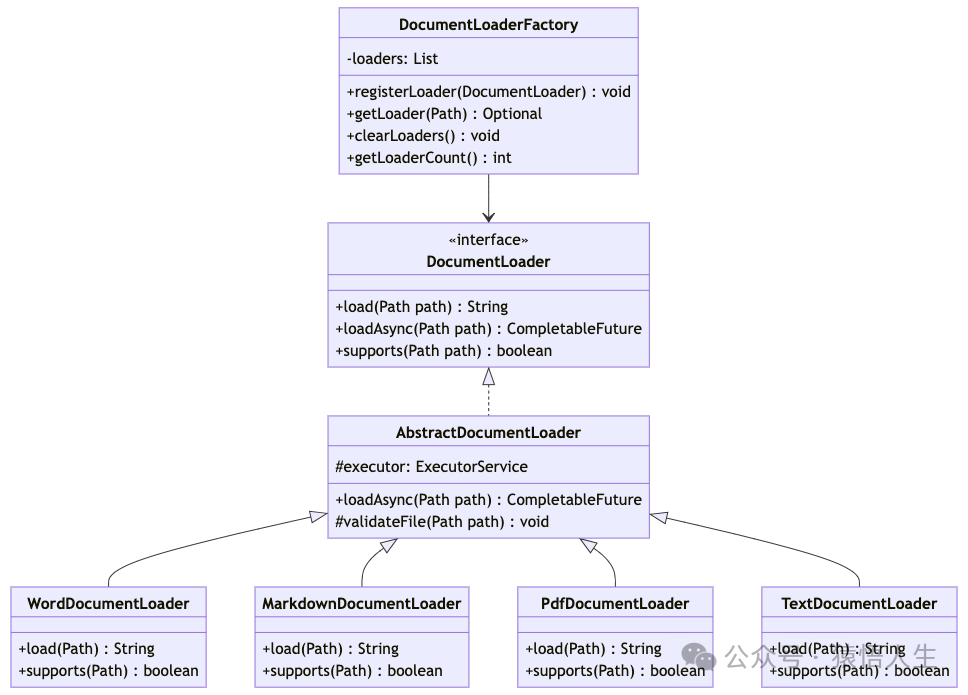
今天主要完成了文档加载器框架的核心实现,包括以下几个主要组件:
类图
1.2 关键实现细节
DocumentLoader 接口
public interface DocumentLoader {
    String load(Path path) throws IOException;
    CompletableFuture<String> loadAsync(Path path);
    boolean supports(Path path);
}-
定义了文档加载的核心接口
-
支持同步和异步加载
-
提供文件类型支持检查
AbstractDocumentLoader 抽象类
public abstract class AbstractDocumentLoader implements DocumentLoader {
    protected static final ExecutorService executor =
        Executors.newFixedThreadPool(Runtime.getRuntime().availableProcessors());

    @Override
    public CompletableFuture<String> loadAsync(Path path) {
        return CompletableFuture.supplyAsync(() -> {
            try {
                return load(path);
            } catch (IOException e) {
                throw new RuntimeException("Failed to load document: " + path, e);
            }
        }, executor);
    }
}-
实现了异步加载的通用逻辑
-
使用线程池优化并发性能
-
提供文件验证等通用功能
DocumentLoaderFactory 工厂类
public class DocumentLoaderFactory {
    private static final List<DocumentLoader> loaders = new ArrayList<>();

    static {
        registerLoader(new TextDocumentLoader());
        registerLoader(new PdfDocumentLoader());
        registerLoader(new WordDocumentLoader());
        registerLoader(new MarkdownDocumentLoader());
    }

    public static Optional<DocumentLoader> getLoader(Path path) {
        return loaders.stream()
            .filter(loader -> loader.supports(path))
            .findFirst();
    }
}-
采用工厂模式管理不同类型的文档加载器
-
支持动态注册新的加载器
-
提供自动文档类型识别和加载器选择
2. 单元测试覆盖
2.1 测试用例统计
-
总测试用例数:57个
-
按模块分布:
-
WordDocumentLoaderTest: 4个
-
MarkdownDocumentLoaderTest: 22个
-
PdfDocumentLoaderTest: 16个
-
DocumentLoaderFactoryTest: 15个
2.2 关键测试场景
-
文档格式支持检测
-
同步/异步加载功能
-
错误处理和边界条件
-
文档结构解析
-
元数据提取
3. 技术要点总结
-
- 异步处理优化
-
使用CompletableFuture实现非阻塞操作
-
线程池管理提升性能
-
- 设计模式应用
-
工厂模式:文档加载器创建
-
模板方法:通用文档处理流程
-
策略模式:不同格式文档的处理策略
-
- 代码质量保证
-
完整的单元测试覆盖
-
统一的异常处理机制
-
规范的代码注释
4. 后续计划
-
1. 优化文档解析性能
-
2. 添加更多文档格式支持
-
3. 实现文档内容索引功能
-
4. 增加批量处理能力
5. 问题与解决方案
-
- Java 8 兼容性问题
-
问题:部分API不支持Java 8
-
解决:替换现代API为兼容版本
-
示例:将
Path.of()替换为Paths.get()
-
- 文档格式处理
-
问题:DOC格式支持限制
-
解决:暂时只支持DOCX格式,后续规划DOC支持
6. 代码提交记录
commit 9844aa5
feat: 实现文档加载器和单元测试
- 实现Word文档加载器(支持DOCX格式)
- 实现Markdown文档加载器(支持MD/MARKDOWN格式)
- 添加完整的单元测试覆盖
- 确保Java 8兼容性
7. 备注
-
所有测试用例均已通过
-
代码已完成提交并同步到远程仓库
-
文档加载器框架已具备良好的扩展性
-
后续可基于此框架扩展更多文档类型支持
明日开发重点🎯
-
1. 开始实现Document Parser接口
-
2. 设计解析器链模式
-
3. 实现基础文本解析器
-
4. 实现HTML解析器
-
5. 编写相应的单元测试
