HTTP概述
HTTP协议: 协议 是指计算机通信网络中两台计算机之间进行通信所必须共同遵守的规定或规则。HTTP表示超文本传输协议(Hypertext Transfer Protocol),是一种通信协议,它允许将超文本标记语言(HTML)文档从Web服务器传送到客户端的浏览器。HTTP是迄今为止使用最多的互联网协议,目前版本为1.1。HTTP运行在应用层(ISO/OSI七层参考模型包括应用层,表示层,会话层,传输层,网络层,数据链路层,物理层。),是一个基于请求/响应模式的,无状态的协议。HTTP是TCP/IP的上层协议。如果你对这些网络协议还都不太熟悉,可以这样理解:TCP负责确保从一个网络节点向另外一个网络节点发送的文件能作为一个完整的文件到达目的地,尽管在具体传输过程中这个文件可能会分解为小块传输;IP是一个底层协议,负责把数据块(数据包)沿路移动/路由到目的地。
我们经常会在 浏览器 网址栏输入网址,例如www.XXX.com,然后回车。这时候,浏览器和web服务器之间就会使用HTTP协议在网络上进行数据的接收和发送。客户端(浏览器)与服务器端(服务器应用程序)建立连接之后,向服务器发送请求(Request),服务器对该请求进行处理,然后返回一个响应(Response)消息,之后双方连接关闭。其中,请求有可能是先经过代理服务器,再传递到web服务器的。
在SO/OSI七层参考模型中,上层协议使用下层协议提供的服务, HTTP 作为应用层协议,其连接的建立使用传输层的TCP协议来完成。TCP是面向连接的协议,一方等待,一方发起连接。web服务器等待浏览器发起连接,默认情况下,浏览器和在web服务器上监听80端口的服务器程序建立连接。虽然HTTP基本TCP协议进行连接,但不排除基于其他协议进行连接。
在HTTP1.0中,建立连接后,浏览器发送一个请求, 服务器 回应一个消息之后连接就被关闭。当下一次浏览器请求时,需要重新建立连接,这种不断建立连接的方式开销比较大。早期的网页通常只包含HTML文本,不会有太大影响。但是现在web网页包含众多资源(图片,声音,视频等),如果每获取一种资源,就要连接一次,会增加HTTP服务器的开销,造成网络信息堵塞。因此HTTP1.1给出了一种持续连接(Persistent Connections)机制(Cookie机制),作为HTTP1.1中连接建立的默认行为。通过这种方式,浏览器只需建立一次连接,可以连续发送多个请求,而不用等待每一个响应的到来。
打开一个网页需要多少次 Request ?
我们来分析一下这个过程:
- 当你在浏览器输入URL http://www.XXX.com 的时候,浏览器发送一个Request去获取 http://www.XXX.com 的html。服务器把Response发送回给浏览器.
- 浏览器分析Response中的 HTML,发现其中引用了很多其他文件,比如图片,CSS文件,JS文件。
- 浏览器会自动再次发送Request去获取图片,CSS文件,或者JS文件。
- 等所有的文件都下载成功后,网页被显示出来。
1、HTTP URL
我们在浏览器网址栏输入的网址就是HTTP URL。URL表示统一资源定位符(Uniform Resource Locator),它是一种特殊的URI(统一资源标示符,Uniform Resource Identifier,统一资源标示符)。包含了用于查找某个资源的足够信息。HTTP URL格式:http://host [:port][path]。http表示通过HTTP协议来定位网络资源,host表示合法的主机域名或IP地址,port表示一个指定的端口号,如果为空,表示默认使用80端口。path指定URI,如果URI中没有给出path,那么当它作为请求URI时,必须以“/”的形式给出,通常,浏览器会帮我们完成这个工作。
常用的服务器应用端口号:FTP(21)、Telnet(23)、SMTP(25)、Time(37)、HTTPS(443)、POP3(110)、HTTP(80)。
2、HTTP 请求
1)请求行
请求行以一个方法符号开头,后面跟着请求URI和协议的版本,以CRLF(表示回车换行)作为结尾。请求行以空格分隔,除了作为结尾的CRLF外,不允许出现单独的CR或LF字符。格式:Method Request-URI HTTP-Version CRLF。Mehtod表示请求的方法,Request-URI是一个统一资源标示符,表示了要请求的资源,HTTP-Version表示HTTP协议版本,CRLF表示回车换行。例如: GET /form.html HTTP/1.1 (CRLF)。
方法
在HTTP协议中,HTTP请求可以使用多种请求方法,这些方法指明了要以何种方式来访问由Request-URI标识的资源。HTTP1.1支持的请求方法如下所示:
| 方法 | 作用 |
|---|---|
| GET | 请求Request-URI标识的资源。注意:GET方法不应当被用于产生“副作用”的操作中,例如在Web Application中。其中一个原因是GET可能会被网络蜘蛛等随意访问。 |
| POST | 向指定资源提交数据进行处理请求(例如提交表单或者上传文件)。数据被包含在请求体中。POST请求可能会导致新的资源的创建和/或已有资源的修改。 |
| HEAD | 向服务器索要与GET请求相一致的响应,只不过响应体将不会被返回。这一方法可以在不必传输整个响应内容的情况下,就可以获取包含在响应消息头中的元信息。 |
| PUT | 向指定资源位置上传其最新内容。 |
| DELETE | 请求服务器删除Request-URI所标识的资源。 |
| TRACE | 回显服务器收到的请求,主要用于测试或诊断。 |
| CONNECT | HTTP/1.1协议中预留给能够将连接改为管道方式的代理服务器。 |
| OPTIONS | 返回服务器针对特定资源所支持的HTTP请求方法。也可以利用向Web服务器发送’*‘的请求来测试服务器的功能性。 |
其中最常使用的请求方法是GET和POST,HEAD方法也使用较多,下面做一个简要介绍。
GET方法:GET方法用于获取由Request-URI标识的资源的信息,常见的格式为:GET Request-URI HTTP/1.1
当我们通过在浏览器的地址栏中直接输入网址的方式去访问网页的时候,浏览器使用的就是GET方法向服务器获取资源。
POST方法:POST方法用于向目的服务器发送请求,要求服务器接收附在请求后面的数据。POST方法在表单提交的时候用的较多,下面给出一个使用POST方法提交表单的例子。
POST /register.jsp HTTP/1.1 (CRLF)
Accept:image/gif,… (CRLF)
Host: www.XXX.com (CRLF)
Content-Length: 22 (CRLF)
Connecion: Keep-Alive (CRLF)
Cache-Control: no-cache (CRLF)
(CRLF)
username=shan&passwd:111
两个回车换行后,是表单提交的数据。
HEAD方法:该方法与GET方法几乎相同,它们之间的区别在于HEAD方法只是请求消息报头,而不是完整的内容。该方法常用来检测超链接的有效性,是否可以访问,最近是否有更新。
2)消息报头
见后面的消息部分。
3)请求正文
消息报头和请求正文之间是一个空行(只有CRLF的行),该行表示消息报头已经结束,接下来的是请求正文。请求正文中可以包含提交的数据。如上面例子中的username=shan&passwd:111就是请求正文部分。
3、HTTP响应
在接收和解释请求消息后,服务器会返回一个HTTP响应消息。与HTTP请求类似,HTTP响应也由三个部分组成,分别是:状态行、消息报头和响应正文。
1)状态行
状态行由协议版本,数字形式的状态代码,及相应的状态描述组成,各元素间以空格分隔,除了作为结尾的CRLF外,不允许出现单独的CR或LF字符。格式如下:HTTP-Version Status-Code Reason-Phrase CRLF。
HTTP-Version表示服务器HTTP协议的版本,Status-Code表示服务器发回的响应代码,Reason-Phrase表示状态代码的文本描述,CRLF表示回车换行。例如:HTTP/1.1 200 OK (CRLF)
状态码与状态描述:
状态码由三位数字组成,表示请求是否被理解或被满足,状态描述给出了关于状态代码的简短描述。状态代码的第一个数字定义了响应的类别,后面两位数字没有具体的分类。第一个数字有五种取值,如下所示:
1xx:指示消息——请求已被服务器接收,继续处理
2xx:成功——请求已成功被服务器接收、理解、并接受
3xx:重定向——需要后续操作才能完成这一请求
4xx:请求错误——请求含有词法错误或者无法被执行
5xx:服务器错误——服务器在处理某个正确请求时发生错误
在HTTP1.1中定义的状态码如下表所示:
| 100 Continue | 404 Not Found |
|---|---|
| 101 Switching Protocols | 405 Method Not Allowed |
| 200 OK | 406 Not Acceptable |
| 201 Created | 407 Proxy Authentication Required |
| 202 Accepted | 408 Request Time-out |
| 203 Non-Authoritative Information | 409 Conflict |
| 204 No Content | 410 Gone |
| 205 Reset Content | 411 Length Required |
| 206 Partial Content | 412 Precondition Failed |
| 300 Multiple Choices | 413 Request Entity Too Large |
| 301 Moved Permanently | 414 Request-URI Too Large |
| 302 Found | 415 Unsupported Media Type |
| 303 See Other | 416 Requested range not satisfiable |
| 304 Not Modified | 417 Expectation Failed |
| 305 Use Proxy | 500 Internal Server Error |
| 307 Temporary Redirect | 501 Not Implemented |
| 400 Bad Request | 502 Bad Gateway |
| 401 Unauthorized | 503 Service Unavailable |
| 402 Payment Required | 504 Gateway Time-out |
| 403 Forbidden | 505 HTTP Version not supported |
2)消息报头
见后面的消息部分
3)响应正文
消息报头和响应正文之间是一个空行(只有CRLF的行),这个空行表明消息报头已经结束,接下来的是响应正文。响应正文就是服务器返回的资源的内容。例如请求一个页面,则返回一个 html 文件。
4、HTTP消息
HTTP消息由客户端到服务器的请求和服务器到客户端的响应组成。请求消息和响应消息都是由开始行、消息报头(可选)、空行(只有CRLF的行)、消息正文(可选)组成。
对于请求消息,开始行就是请求行;对于响应消息,开始行就是状态行。
抽象的内容不好理解,打开Fiddler,捕捉CSDN首页的Request和Response,分析一下其内容。如下图:
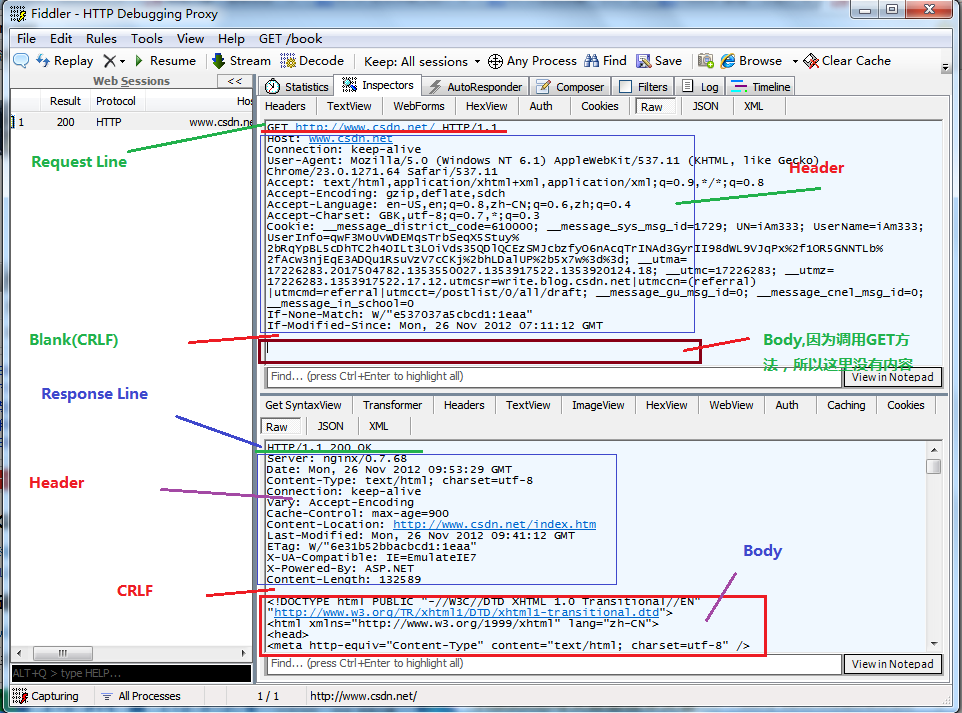
上图中因为请求使用了GET方法,所以BODY中没有内容。另外,由上图可知,每一个消息报头都由一个回车换行符(CRLF)结束。GET方法和POST方法的区别有哪些呢?
- GET提交的数据会放在URL之后,以?分割URL和传输数据,参数之间以&相连,如Register.jsp?username=shan&passwd=111,POST方法是把提交的数据放在HTTP包的Body中.
- GET提交的数据大小有限制(因为浏览器对URL的长度有限制),而POST方法提交的数据没有限制.
- GET方式需要使用Request.QueryString来取得变量的值,而POST方式通过Request.Form来获取变量的值。
- GET方式提交数据,会带来安全问题,比如一个登录页面,通过GET方式提交数据时,用户名和密码将出现在URL上,如果页面可以被缓存或者其他人可以访问这台机器,就可以从历史记录获得该用户的账号和密码.
5、消息报头
HTTP消息报头包括普通报头(general header)、请求报头(request header)、响应报头(response header)和实体报头(entity header)。每一个报头都是由名字+”:“+空格+值组成,消息报头域的名字是大小写无关的。
1)普通报头
在普通报头中,有少数报头域应用于所有的请求和响应消息,但并不用于被传输的实体(实体,请参考实体报头部分),这些报头域只用于传递消息。普通报头包括:
Cache-Control、Connection、Date、Pragma、Tralier、Transfer-Enconding、Upgrade、Via、Warning。下面介绍几个常用的普通报头。
(1)Cache-Control:普通报头域用于指定 缓存 指令,该指令将被请求/响应链中的缓存机制所遵循。这些指令将覆盖默认的规则。缓存指令是单向的,在请求中出现的缓存指令,并不意味着在响应中也会出现。此外,在一个消息(请求或响应消息)中指定的缓存指令,并不会影响另一个消息处理的缓冲机制。注:HTTP1.1中为Cache-Control,HTTP1.0中为Pragma。
缓存指令分为请求时的缓存指令和响应时的缓存指令。请求时的缓存指令包括no-cache、no-store、max-age、max-state、min-fresh、only-if-cached。响应时的缓存指令包括public、private、no-cache、no-store、no-transform、must-revalidate、proxy-revalidate、max-age、s-maxage。其中常用的是no-cache,用于指示请求或响应消息不能缓存。
Cache-Control:Public:可以被任何缓存所缓存
Cache-Control:Private:内容只缓存到私有缓存中(默认)
Cache-Control:no-cache:所有内容都不会被缓存
Cache-Control:max-age=5:表示当访问此网页后的5秒内再次访问不会去服务器
(2)Date:Date普通报头域表示消息产生的日期和时间,可用于HTTP请求中,也可以用于HTTP响应中。作为服务器端,应该总是在所有的响应中包含Date报头域。客户端只有在发送的消息中包含了消息正文的时候,才应该发送Date报头域,例如,在POST请求的时候。
(3)Connection:Connection普通报头域允许发送指定连接的选项。例如,指定连接时持续的,或者指定”close“选项,通知服务器,在响应完成后,关闭连接。
(4)Pragma:Pragma普通报头域被用于包含特定实现的指令,这些指令可能会应用到请求/响应链中的任何一个接收者。最常用的是Pragma:no-cache。在HTTP1.1中,它的含义与Cache-Control:no-cache相同。
2)请求报头
请求报头允许客户端向服务器端传递该请求的附加消息,以及客户端自身的消息。包括:
Accept、Accept-Charset、Accept-Encoding、Accept-Language、Authorization、Expect、From、Host、If-Match、If-Modified-Since、If-None-Match、If-Range、If-Unmodified-Since、Max-Forwards、Proxy-Authorization、Range、Referer、TE、User- Agent 、Cookie。
下面介绍几个常用的请求报头域。
(1)Accept:Accept请求报头域用于指定客户端接收那些类型的消息。例如Accept:image/gif,表明客户端希望接收gif格式的图像;Accept:text/html表明客户端希望接收html文本。
(2)Accept-Charset:Accept-Charset请求报头域用于指定客户端接收的字符集。例如Accept-Charset:gb2321,表明希望接收中文字符。如果未指定,表明任何字符集都接收。
(3)Accept-Encoding:Accept-Encoding请求报头域用于指定可接受的内容编码。例如Accept-Encoding:gzip。如果请求消息中未指定,则表明任何内容编码都可以接收。
(4)Accept-Language:Accept-Language请求报头域用于指定客户端接收的语言。例如Accept-Language:zh-cn。如果为设定,报名任何语言都可以接收。
(5)Authorization:Authorization请求报头域主要用于证明客户端有权查看某个资源。当浏览器访问一个页面时,如果收到服务器的响应代码为401(未授权),可以发送一个包含Authorization请求报头域的请求,要求服务器对其进行验证。
(6)Host:Host请求报头域用于指定被请求资源的Internet主机和端口号,它通常是从HTTP URL中提取出来的。注:在发送HTTP请求时,这个报头域是必须的。
(7)User-Agent:在登录论坛时,往往会看到一些欢迎信息,列出了你的操作系统名称和版本,你用的浏览器和版本。很多人对此感到神奇,实际上,服务器应用程序就是从User-Agent这个请求报头域中获取到的这些信息。不过该报头不是必须的,如果我们自己编写一个浏览器,不是用User-Agent请求报头域,则服务器就无从得知我们的信息。
(8)If-Modified-Since: 把浏览器端缓存页面的最后修改时间发送到服务器去,服务器会把这个时间与服务器上实际文件的最后修改时间进行对比。如果时间一致,那么返回304,客户端就直接使用本地缓存文件。如果时间不一致,就会返回200和新的文件内容。客户端接到之后,会丢弃旧文件,把新文件缓存起来,并显示在浏览器中。例如上面捕获CSDN的信息截图中:If-Modified-Since: Mon, 26 Nov 2012 07:11:12 GMT,而相应报头域中的Last-Modified: Mon, 26 Nov 2012 09:41:12 GMT,两者不一致,所以返回200和新文件内容。
(9)If-None-Match: If-None-Match和ETag一起工作,工作原理是在HTTP Response中添加ETag信息。 当用户再次请求该资源时,将在HTTP Request 中加入If-None-Match信息(ETag的值)。如果服务器验证资源的ETag没有改变(该资源没有更新),将返回一个304状态告诉客户端使用本地缓存文件。否则将返回200状态和新的资源和Etag. 使用这样的机制将提高网站的性能。例如上面捕获CSDN的信息截图中:If-None-Match: W/”e537037a5cbcd1:1eaa”,而相应报头域中的ETag: W/”6e31b52bbacbcd1:1eaa”,两者不一致,所以返回200和新文件内容。
(10)Cookie:是最重要的请求报头域, 它将cookie的值发送给HTTP 服务器。
3)响应报头
响应报头允许服务器传递不能放在状态行中附加响应信息,以及关于服务器的信息和对Request-URI所标识的资源进行下一步访问的信息。包括:
Accept-Ranges、Age、ETag、Location、Proxy-Authenticate、Retry-After、Server、Vary、WWW-Authenticate。
下面介绍几个常用的响应报头域。
(1)Location:Location响应报头域用于重定向接收者到一个新的位置。例如,客户端所请求的页面已不再原来的位置,为了让客户端重定向到这个页面的新位置,服务器端可以发回Location响应报头域。
(2)Server:Server响应报头域包含了服务器用来处理请求的软件信息。它和User-Agent请求报头域是相对应的,一个发送服务端软件的信息,一个发送客户端软件(浏览器)和操作系统的信息。如上面捕捉到CSDN该域的内容为Server: nginx/0.7.68。
(3)WWW-Authenticate:WWW-Authenticate响应报头域必须被包含在401(未授权)响应消息中,这个报头域和前面讲到的Authorization报头域是相关的。当客户端收到401响应消息,就要决定是否请求服务器对其验证。如果要求服务器对其进行验证,就可发送一个包含Authorization报头域的请求。
4)实体报头
请求和响应消息都可以传送一个实体。一个实体由实体报头域和实体正文组成,在大多数情况下,实体正文就是请求消息中的请求正文或者响应消息中的响应正文。但在发送时,并不是说实体报头域和实体正文要在一起发送,例如,有些响应就可以只包含实体报头域。就像写信,在信中,可以写上标题,加上页号等,这部分就相当于实体报头域,而信的内容,就相当于是实体正文。之前所讲的普通报头、请求报头、响应报头可以看成是邮编、接收者、发送者等。
实体报头主要包括:Allow,Content-Encoding,Content-Language,Content-Length,Content-Location,Content-MD5,Content-Range,Content-Type,Expires,Last-Modified。下面介绍几个主要的实体报头。
(1)Content-Encoding:Content-Encoding实体报头域的值只是了被应用到实体正文的附加内容编码,因而要获得Content-Type报头域中所引用的媒体类型,必须采用相应的解码机制。如果一个实体正文采用了编码方式存储,在使用前就必须进行解码。
(2)Content-Language:Content-Language实体报头域描述了资源所用的自然语言。
(3)Content-Length:Content-Length用于指明实体正文的长度,以字节方式存储的十进制数字来表示,也就是一个数字字符占一个字节,用其对应的ASCII码存储传输。注:这个长度仅表示实体正文长度,没包括实体报头的长度。参考上面捕获CSDN首页信息的截图。
(4)Content-Type:Content-Type实体报头域用于表明发送给接收者的实体正文的媒体类型。这个值成为MIME类型。MIME类型告诉浏览器要接收的数据是什么类型,这样浏览器才能知道该如何显示这些数据。注:MIME类型与HTTP请求的Accept域中的值相关。
(5)Expires:Expires实体报头域给出响应过期的日期和时间。通常,代理服务器或浏览器会缓存一些页面,当用户在此访问这些页面时,直接从缓存中加载并显示给用户。这样缩短响应时间,减少了服务器负担。为了让代理服务器或浏览器在一段时间后更新页面,可以使用Expires实体报头域来制定页面过期的时间。
(6)Last-Modified:Last-Modified实体报头域用于指示资源最后的修改日期和时间。
HTTP协议的“无状态”和“Connection: keep-alive”的区别
无状态是指协议对于事务处理没有记忆能力,服务器不知道客户端是什么状态。打开一个服务器上的网页和你之前打开这个服务器上的网页之间没有任何联系。
HTTP是一个无状态的面向连接的协议,无状态不代表HTTP不能保持TCP连接,更不能代表HTTP使用的是UDP协议(无连接)。
从HTTP/1.1起,默认都开启了Keep-Alive,保持连接特性,简单地说,当一个网页打开完成后,客户端和服务器之间用于传输HTTP数据的TCP连接不会关闭,如果客户端再次访问这个服务器上的网页,会继续使用这一条已经建立的连接。而Keep-Alive不会永久保持连接,它有一个保持时间,可以在不同的服务器软件(如Apache)中设定这个时间。
